4. 실행 설계: planner → upload → retain
4.1 Planner와 selector
select_block_level_no_stack()는 :4075의 blocks를 반환하고 token 확장을 제거한다.plan_block_native()는 want 순서에서 held를 빼고 ranked tail로 부족분을 채운다.- old contract와 같게 최종 upload 순서를 ID 오름차순으로 고정한다.
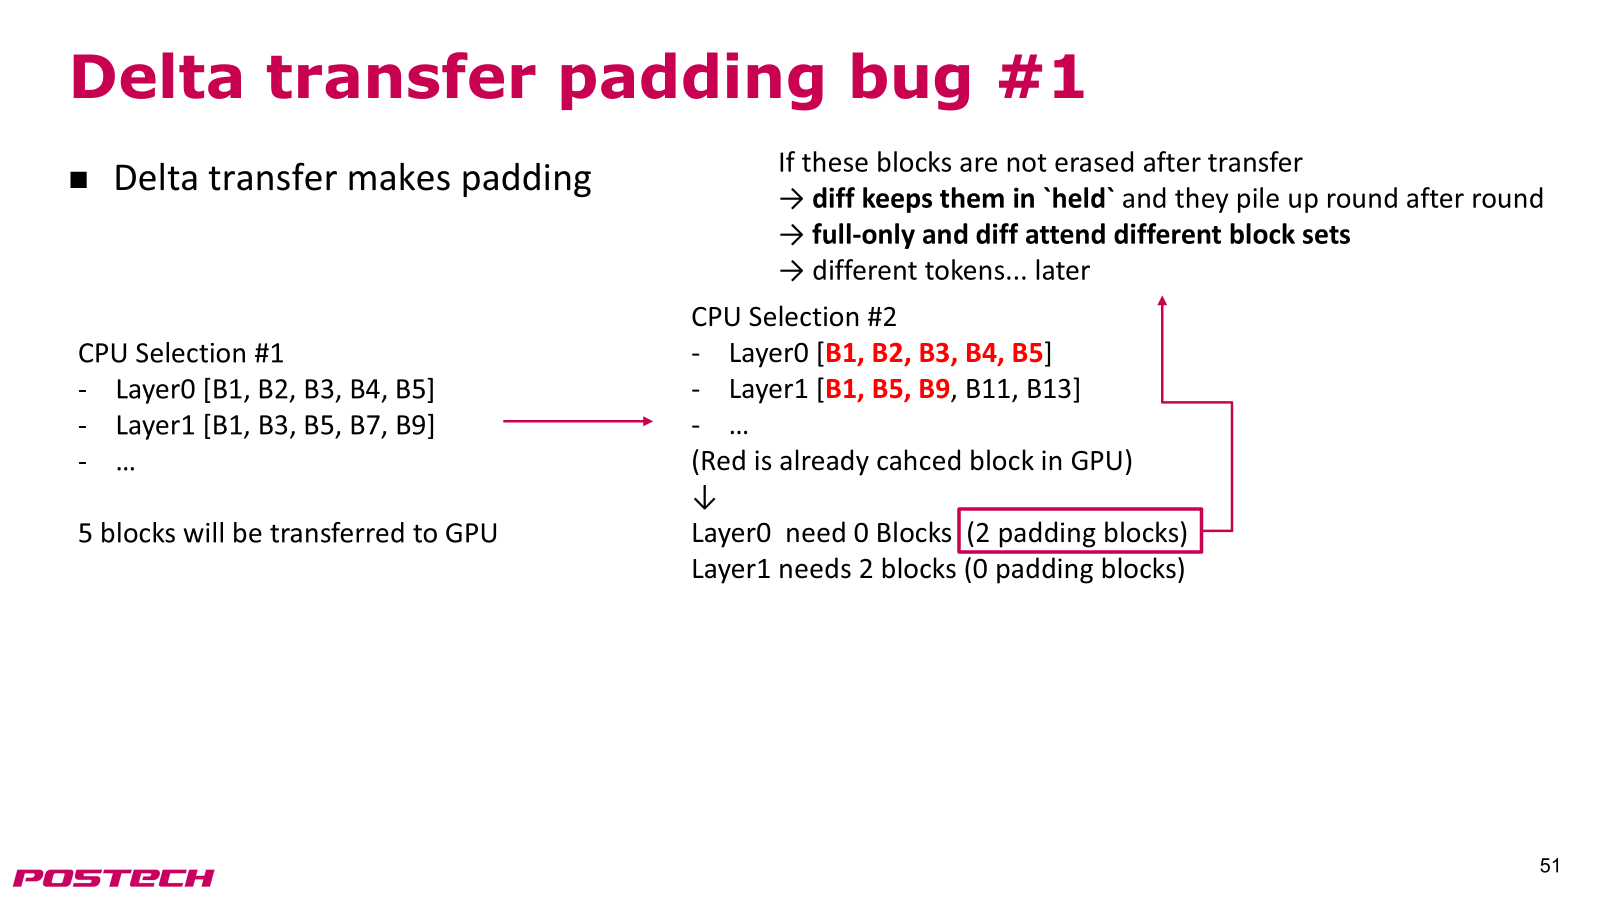
- padding은 want/held와 중복하지 않는 실제 존재하는 유효 KV만 사용한다.
- 한 layer의 후보가 모자라 원하는 delta를 잘라내면 full plan으로 돌린다.
- block score 동점은
(-score, logical_block_id) 순서로 결정하고 NaN/Inf를 거부한다.
- 아직 확정되지 않은 partial/recent/draft tail은 selected pool과 분리한다.
_token_scores_no_stack():3858는 현재 whole-block 범위로 자른다.
- sink+recent가 budget을 초과하면 effective budget을 기록하거나 명시적으로 실패한다.
def validate_whole_blocks(token_ids, B):
require(B > 0 and len(token_ids) % B == 0)
rows = as_int64(token_ids).reshape(-1, B)
require(all(rows[:, 0] >= 0))
require(all(rows[:, 0] % B == 0))
require(array_equal(rows, rows[:, :1] + arange(B)))
blocks = rows[:, 0] // B
require(unique_count(blocks) == len(blocks))
return blocks
# rank-tail[-1]은 최댓값이 아니다. HOLE은 membership 이전에 제외한다.
max_id = max(max_or_zero(want), max_or_zero(tail), max_or_zero(valid_held))
require(all_ids_nonnegative_and_within_sequence)
현재 diff_plan.py:197–200는 tail 마지막 값을 최댓값으로 사용한다. want=[2], tail=[127,4,3], held=[1]이면 3을 넘기지만 실제 최대는 127이다. C++ compact_amx_kernel.cpp:138–153는 이 크기로 scratch를 잡고 b[v >> 3]를 읽으므로 작은 scratch에서는 범위 밖 접근이 가능하다. 이는 코드·정수 계산으로 확인한 반례이며 native C++를 실행해서 충돌시킨 결과는 아니다.
4.2 Upload commit과 0-delta
현재 gpu_model_runner.py:5225–5231은 n_new=0이면 selection 기록 후 바로 return하여 finalize_diff_upload()와 keep-map 갱신을 건너뛴다. “전송 0”도 최신 selection/retention 상태를 갱신해야 한다.
SELECT revision r → PLAN
bytes > 0: stage(g+1) → allocate + source lease → transfer
→ all-rank completion → commit residency(g+1) → ACK
bytes = 0: residency(g) 유지 → publish keep revision r → metadata ACK
pending 요청은 (request_epoch, operation_id, pool_generation, map_revision)으로 식별한다. 반복 ACK는 no-op, 오래된 ACK는 무시, 미래/충돌 ACK는 오류로 처리한다. 같은 HTTP 요청 재시도가 다른 upload나 RNG 소비를 새로 만들지 않도록 결과를 재사용한다. upload-only resume에서도 동일 장부 stage/ACK를 사용한다. request identity는 전달받은 opaque ID 전체와 epoch를 쓴다. 현재 index_map.py:72–74의 하이픈 두 구간 추출에 새 프로토콜을 의존시키지 않는다.
4.3 Clear-legacy fast path와 최종형
공통 table 호환 단계에서는 group별 ordered keep-slot list가 모든 layer에서 같은지 검사한다. 같으면 prefix 개수만 줄이는 것이 아니라 실제 keep slot으로 table을 재작성한다. 다르면 현재 byte-move 경로를 유지한다. COMPACT_METHOD=block이라고 검사를 생략하지 않는다.
def plan_retain_group(residency, keep_by_layer, active_layers):
rows = [keep_by_layer[L] for L in active_layers]
validate_epoch_generation_bounds(rows, residency)
if all(array_equal(row, rows[0]) for row in rows):
slots = rows[0] # stable resident order, whole blocks only
return SharedTableRemap(
new_table=[residency.shared_table[s] for s in slots])
if residency.supports_layer_tables:
return LayerTableRemap(
tables={L: [residency.physical_by_slot_by_layer[L][s]
for s in keep_by_layer[L]]
for L in active_layers})
return ExistingByteMovePlan(rows)
최종 layer별 table 단계의 변경 범위:
| 경계 |
변경 |
| scheduler / KV manager | group owner allocation set과 layer별 logical view를 분리; refcount 기반 release |
| worker block table | layer별 selected table/valid length와 group별 regular tail을 결합 |
| FlashInfer metadata | layer별 paged indices·indptr·last_page_len/길이에 맞춰 plan; group 공통 wrapper 재사용 가정 제거 |
| CUDA graph | table 버퍼 pointer·capacity 고정; contents/count 갱신은 replay 전에 완료 |
| CPU ledger | GPU가 ACK한 slot mapping/permutation을 같은 순서로 반영 |
| TP/DP/hybrid | group ID를 flatten하지 않음; SW 제외; rank별 completion 뒤 commit; DP owner로 ACK 라우팅 |
기존 GPU allocation 하나에 layer별 KV가 함께 매달려 있으므로 layer0이 놓은 physical block을 layer1이 아직 읽으면 free할 수 없다. group 내 모든 layer·regular/prefix 공유 참조·진행 중 transfer 참조가 사라진 뒤에만 owner가 release한다. retired = old_owned − referenced_after_commit이며 shared/prefix block은 allocator reference를 감소시킬 뿐 무조건 반환하지 않는다. layer별 table은 byte movement를 없앨 수 있어도 회수 블록 수가 적거나 0일 수 있다. 이 한계는 구현 후 workload별로 측정한다.
4.4 안전한 commit / free
build immutable RetainPlan
→ validate request still RUNNING + no conflicting verify/upload/preempt
→ wait last reader/transfer event
→ apply all affected layer/group tables + valid lengths
→ worker completion ACK (all TP ranks)
→ scheduler commits new owner/view generation
→ retire old references and publish CPU ledger ACK
현 scheduler_recompact.py:219–232는 table 길이를 먼저 줄이고 tail을 다음 step에 free한다. 새 경로는 단순 “다음 schedule”을 완료 증거로 사용하지 않는다. 오류/취소 시 ACK 전의 old state를 유지하고 신규 예약을 돌려주는 abort 경로가 필요하다. 최근/partial/draft 블록과 SW window는 selected clear의 대상에 넣지 않는다.