현황
TandemSpec(CompressSpec) · HeadInfer · NEO · SparseSpec 에서 실제로 돌려 본 모델과 그 설정. 조건만 정리한 문서는 같은 디렉터리의 README.md.
| 항목 | 값 | |
|---|---|---|
| 1.0.2.1 | smoke 노드 | n88 (H200 143 GiB, Xeon Platinum 8562Y+, 할당 core 8개) |
| 1.0.2.2 | 측정 노드 | Nebius RTX PRO 6000 (81.85.1.77 · 81.85.4.145 × 8) |
| 1.0.2.3 | 축약 전 원문 | model_matrix/_redesign/before/CAN_MODEL.md (지운 표·로그·예시는 여기) |
| 모델 | 크기 | TandemSpec | HeadInfer | NEO | SparseSpec | 실험 채택 | |
|---|---|---|---|---|---|---|---|
| 1.0.3.1 | Magistral-Small-2509 (text-only) | 23.57B / 43.90 GiB | 통과 | 통과 | 통과 | 통과 | 채택 |
| 1.0.3.2 | ibm-granite/granite-4.2-30b | 30B / 54.53 GiB | 통과 | 통과 | 통과 | 통과 | 채택 |
| 1.0.3.3 | skt/A.X-3.1 | 34.7B / 64.6 GiB | 통과 | 통과 | 통과 | 통과 | 불가 부적합 |
- 기(상황) 네 시스템 통과와 실험 채택은 다르다. A.X-3.1 은 reasoning 모델이 아니다
- 승(증상) AIME 30문제 생성 길이 중앙값 Magistral 16,107 vs A.X-3.1 1,173 token (13.7배). 둘 다 30개 전부 EOS 종료
- 전(원인) 길이를 강제하면 8-gram 고유율이 0.883 → 0.451 로 떨어져 speculative accept 이 부풀려진다
- 결(조치) 긴 출력 비교 실험에서 제외. 기록
results/20260920_magistral_aime/gen_mag_len.jsonl·gen_ax_yarn.jsonl
위 표의 수치는 core 8개 조건이라 성능 비교에 쓰지 않는다. TandemSpec 은 GPU 엔진까지만 확인했고 CPU verify 서버를 붙인 전체 경로는 미확인.
1.1모델별로 실제 필요했던 작업
| 모델 | 코드 수정 | 그 밖에 필요한 것 | |
|---|---|---|---|
| 1.1.1.1 | Magistral-Small-2509 | HeadInfer 1줄 · NEO 1줄 + pacpu macro | text-only 변환, params.json 삭제, eos_token_id, 24b 이름 |
| 1.1.1.2 | ibm-granite/granite-4.2-30b | HeadInfer 1줄 · NEO 1줄 + pacpu macro · attention_multiplier 지원 | 없음. 자세한 것은 준비 탭의 모델 준비 · 코드 수정 |
| 1.1.1.3 | skt/A.X-3.1 | 없음 (NEO pacpu macro 만) | 35b 이름 symlink. 다만 reasoning 모델이 아니라 실험에서는 제외 |
1.2통과 근거
| 모델 | 시스템 | 확인한 것 | |
|---|---|---|---|
| 1.2.1.1 | Magistral | vLLM 엔진 | 256 token 생성, AIME 문제를 정상 전개 |
| 1.2.1.2 | Magistral | HeadInfer | 40층 × 8 kv = 320 pseudo-layer, decode 145 ms/token |
| 1.2.1.3 | Magistral | SparseSpec | 요청 2개 정상 종료, acceptance 93.93% |
| 1.2.1.4 | Magistral | NEO | 16 token 생성, decode 579 ms/token |
| 1.2.1.5 | Granite | vLLM 엔진 | registry 에 있고 attention_multiplier 를 읽음 |
| 1.2.1.6 | Granite | HeadInfer | 64층 × 8 kv = 512 pseudo-layer 로 동작 |
| 1.2.1.7 | Granite | SparseSpec | acceptance 52.35% → 86.92% (attention scale override 적용) |
| 1.2.1.8 | Granite | NEO | 첫 토큰이 반복·특수문자에서 정상 토큰으로 바뀜 |
| 1.2.1.9 | A.X-3.1 | vLLM 엔진 | 256 token 생성 |
| 1.2.1.10 | A.X-3.1 | HeadInfer | 48층 × 8 kv = 384 pseudo-layer, decode 183 ms/token |
| 1.2.1.11 | A.X-3.1 | SparseSpec | acceptance 90.77%, model 65.19 GB / KV 53.63 GB |
| 1.2.1.12 | A.X-3.1 | NEO | 16 token 생성, decode 640 ms/token |
1.3지금 무엇을 하고 있나
| 노드 | 내용 | |
|---|---|---|
| 1.3.1.1 | Nebius 81.85.1.77 | 측정 종료. 마지막 판 qw4b_ss_b64r256_20260921_110558 을 214/256 에서 끊었습니다. GPU 3 MiB |
| 1.3.1.2 | RunPod | 사용자 지시로 중단. 메인 세션 소관 |
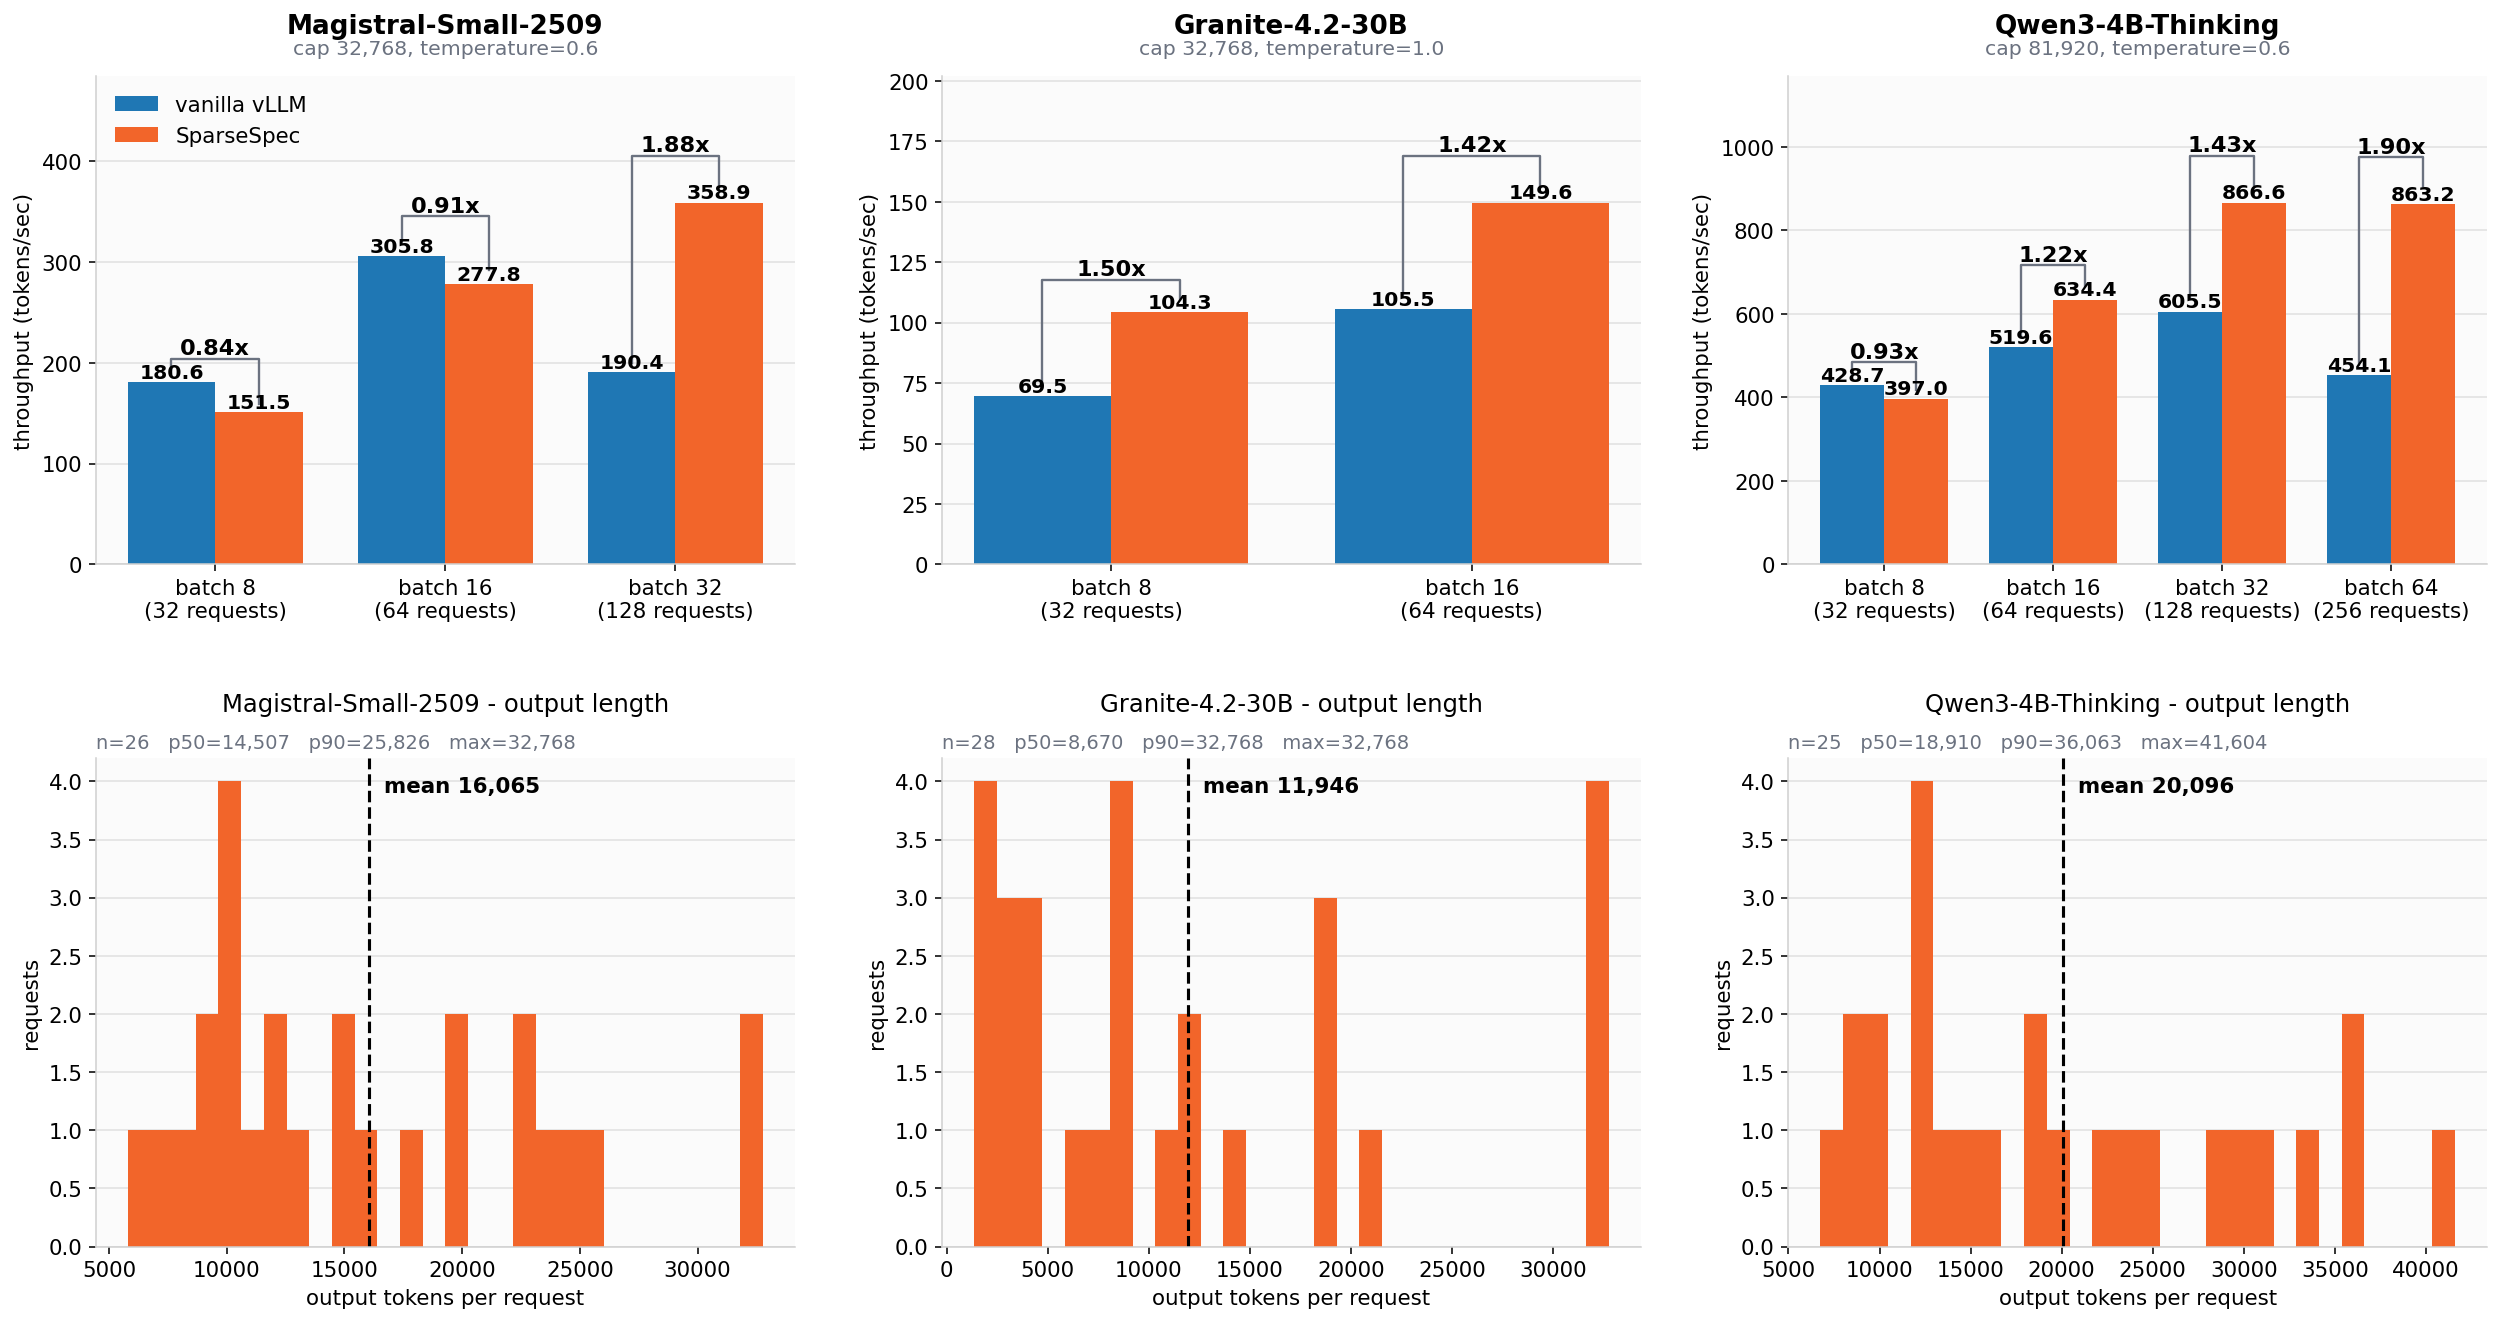
각 arm 은 요청수 − batch 개 완료 시점에 끊었다. 원본 trace 와 요약 CSV 는 results/sparsespec_batch_sweep_20260921/. 모델별 monitor plot 은 결과 탭에 있다.
준비
측정 전에 갖춰야 하는 것. 모델 · 실행 환경 · 주의사항 · AIME pool · 코드 수정 · KV 계산기.
Magistral-Small-2509
VLM(Mistral3ForConditionalGeneration)이라 text-only 로 바꿔야 한다. 준비된 사본: HF private repo PsalMonster/Magistral-Small-2509-text.
python scripts/models/convert_vlm_textonly.py <src> <tokenizer_dir> <dst>
rm -f <dst>/params.json <dst>/tekken.json        # 없애야 vLLM 이 HF 형식으로 읽는다
ln -sfn <dst> models/mistralai/magistral-24b-2509-text| 단계 | 내용 | |
|---|---|---|
| 2.1.4.1 | vision 제거 | vision_tower.*, multi_modal_projector.* tensor 222개 |
| 2.1.4.2 | prefix 변경 | language_model.model.* → model.* |
| 2.1.4.3 | config | top-level 로 올리고 MistralForCausalLM · mistral · eos_token_id: 2 |
| 2.1.4.4 | tokenizer | 공식 repo 에 없어 unsloth/Magistral-Small-2509 에서 가져옴 |
skt/A.X-3.1
LlamaForCausalLM 이라 변환이 필요 없다. 이름만 맞춰 준다.
huggingface-cli download skt/A.X-3.1 --local-dir models/skt/A.X-3.1
ln -sfn A.X-3.1 models/skt/ax-35b-3.1            # SparseSpec 크기 parsing
# NEO 는 pacpu 에 48/64/8 macro 추가 후 build (실행 환경 → NEO)| 항목 | 값 | |
|---|---|---|
| 2.1.8.1 | 층/Q/KV · head_dim · ctx | 48 / 64 / 8 (GQA ratio 8) · 128 · 32,768 |
| 2.1.8.2 | sliding window · bias · rope scaling | 모두 없음 |
| 2.1.8.3 | weight | 69.34 GB (BF16), 약 34.7B params |
ibm-granite/granite-4.2-30b
변환은 필요 없다(GraniteForCausalLM 이 vLLM registry 에 있고 attention_multiplier 도 읽는다). 긴 컨텍스트를 쓰려면 밑작업이 따로 있다. n88(H200 1장, TP=1)에서 확인.
| 항목 | 값 | |
|---|---|---|
| 2.1.11.1 | 층/Q/KV · head_dim | 64 / 32 / 8 (GQA ratio 4) · 128 |
| 2.1.11.2 | max_position_embeddings | 131,072 |
| 2.1.11.3 | rope_scaling · rope_theta | null · 50,000,000 |
| 2.1.11.4 | attention_multiplier | 0.0078125 (= 1/128, 표준 1/√d 의 11.3배 차이) |
| 2.1.11.5 | weight · KV / token | 54.53 GiB · 256 KiB (Qwen3-30B-A3B 의 2.67배) |
1) 128K 를 넘기려면
- 기(상황) checkpoint 는
max_position_embeddings=131072만 싣고 나온다. vLLM 은 이 값으로 상한을 잡는다(vllm/config/model.py:2022) - 승(증상) README 는 512K 를 내걸지만 확장 방법이 없다. 서빙 예시는 전부
--max-model-len 131072 - 전(원인) Granite 는 yarn 이 아니라
rope_theta50M 으로 길이를 확보하는 설계다(Llama-3 의 100배) - 결(조치) rope 는 두고
max_position_embeddings만 올린 사본을 만든다. yarn 을 덧씌우면 128K 이하 구간까지 망가진다. 짧은 실험은 원본 config
# weight 는 symlink 라 54.53 GiB 를 복사하지 않는다. config.json 한 줄만 바꾼다.
python make_mpe.py models/ibm-granite/granite-30b-4.2 models/ibm-granite/granite-30b-4.2-mpe288k 2949122) max_model_len 은 prompt + generation 이다
- 기(상황)
max_model_len=262144에 262,127 token prompt 를 넣었다 - 승(증상) 출력이 16 token 에서
finish_reason=length. thinking 모델이라 답을 못 냈다 - 전(원인) 생성 여유 =
max_model_len − prompt_len= 17.max_tokens=8192는 쓰이지도 못했다 - 결(조치)
mpe를 prompt + generation 으로 잡는다. 256K + 8K = 270,336 → 294,912 사용. KV pool 실측(util 0.95) 304,176 token
3) H200 한 장의 상한은 256K
| GPU | TP=1 · util 0.95 KV pool | 400K 요청 | |
|---|---|---|---|
| 2.1.18.1 | H200 (140.40 GiB) | 304,176 token (74.26 GiB) | 불가 (97.66 GiB 필요) |
| 2.1.18.2 | RTX PRO 6000 (95.60 GiB) | 약 130,000 token | 불가 |
256K 요청 하나가 64.0 GiB 라 동시 2개는 못 들어간다 → batch 1 순차. 512K 는 TP 2 이상.
4) prompt 는 그 모델 template 으로 새로 감싼다
- 기(상황) 공용 long-context pool(
dump/lb_prompts_qwen/)은 Qwen template 이 박힌 완성 프롬프트이고 길이도 Qwen tokenizer 기준 - 승(증상) 같은
262144_Q*.txt가 Granite tokenizer 로는 262,207 ~ 331,057 token 으로 26% 흩어진다. Q1·Q4 는 KV pool 을 넘는다 - 전(원인) Granite vocab 100,352 < Qwen 151K 라 같은 텍스트가 더 많은 token 이 된다
- 결(조치) 길이 축을 Granite token 으로 정의하고, Qwen template 을 벗겨
apply_chat_template(enable_thinking=True)로 다시 감싼다.<text>안쪽만 자르고 질문·보기·형식 지시는 보존
자르는 규칙 (펼치기)
1. <|im_start|> / <|im_end|> 를 벗기고 user turn 의 내용만 남긴다
2. <text> 안쪽만 잘라 목표 토큰 수를 맞춘다
3. 질문 · 보기 · "Format your response..." 는 절대 자르지 않는다 (꼬리는 80~422 토큰)
4. tokenizer.apply_chat_template(..., enable_thinking=True) 로 다시 감싼다
5. 감싼 뒤 디코딩해 앞뒤를 눈으로 확인한다
ground truth 는 prompt 에 없다. 질문 문자열로 LongBench-v2 를 역조회해 "The correct answer is (X)" 와 대조한다.5) 실행 설정
| 항목 | 값 | 비고 | |
|---|---|---|---|
| 2.1.24.1 | env | vllm0140 | vanilla_L40S 는 CPU 빌드라 H200 에서 못 쓴다 |
| 2.1.24.2 | model | granite-30b-4.2-mpe288k | rope 원본, mpe 만 294,912 |
| 2.1.24.3 | gpu_memory_utilization | 0.95 | 0.90 이면 KV pool 이 256K 에 6.7% 여유뿐 |
| 2.1.24.4 | enable_prefix_caching | False | 길이별 대조라 셀이 캐시를 공유하면 안 된다 |
| 2.1.24.5 | sampling | temperature 1.0 / top_p 0.95 | generation_config.json 값, thinking ON |
6) 256K 는 동작한다
- 기(상황)
mpe상향 사본으로 262,144 Granite token 을 H200 TP=1 에 넣었다 (LongBench-v2 5문항,max_model_len 307,200·util 0.97·max_tokens 8,192) - 승(증상) 정답 2/4 (Q4 는 원본 데이터셋과 질문 문자열이 달라 정답 대조 실패 → 분모 제외). 벤치마크의 상위 모델도 50% 안팎
- 전(원인) 생성문이 본문을 정확히 인용한다(
LoraConfig(..., use_dora=True),cluster_jaxpr_by_cost, 몽테크리스토 27장). 위치 인코딩 붕괴가 아니다 - 결(조치) 결과
jh_script/claude_script/results/20260921_214419_granite_lb_lenscan/. 64K·128K·192K needle 판은 전부stop정상 종료
| 문항 | 출력 | 종료 | 답 / 정답 | 판정 | |
|---|---|---|---|---|---|
| 2.1.27.1 | Q1 | 5,300 | stop | D / A | ✗ 본문은 읽었으나 마지막 일반화가 틀림 |
| 2.1.27.2 | Q2 | 1,621 | stop | D / C | ✗ |
| 2.1.27.3 | Q3 | 2,291 | stop | B / B | ✓ |
| 2.1.27.4 | Q4 | 8,192 | length | D / — | thinking 미수렴 (8-gram 고유율 0.219, 텍스트는 온전) |
| 2.1.27.5 | Q5 | 6,245 | stop | D / D | ✓ |
max_tokens권고는 16,384. 정상 생성 최대는 6,245 였으나 수렴하지 않는 문항(Q4)이 실제로 나왔다- 8-gram 고유율은 0.20~0.94 로 흔들리고 Q5 는 0.20 인데도 정답. thinking 모델에서는
finish_reason이 더 나은 반복 신호다 - 생성 예시 원문(Q1·Q4·Q5)은 축약 전 원문 2절 7) 에 있다
시스템별 설정
TandemSpec
vLLM fork + CPU verify. 두 모델 모두 코드 수정 없음.
export ST_MODEL=<model_dir> ST_ROUTER=1          # ROUTER=0 이면 순수 CompressSpec
bash scripts/models/smoke/run_smoke_vllm.sh      # 엔진 단독 확인
bash scripts/saturate/run_sweep.sh <arm> # AIME harness| 항목 | 값 | |
|---|---|---|
| 2.2.5.1 | env | vllm0140 |
| 2.2.5.2 | GQA | Magistral 4, A.X-3.1 8 → 둘 다 2의 거듭제곱이라 CPU attention 수정 불필요 |
| 2.2.5.3 | 주의 | aime_data.py 는 jsonl 의 id key 를 기대. baseline jsonl 은 problem_idx |
HeadInfer
registry 에 architecture 를 등록하면 끝난다. A.X-3.1(llama)은 이미 있다.
# headinfer/mp_modern.py 에 _register("mistral", "MistralForCausalLM", "MistralAttention") 한 줄
HI_SRC=<clone> HI_MODEL=<model> CTX=0 LB_DIR=<docs> python scripts/longcontext/lib/hi_lb.py| 항목 | 값 | |
|---|---|---|
| 2.2.9.1 | env · branch | headinfer-qwen3 · third-party/mistral-support (PSAL-POSTECH/headinfer) |
| 2.2.9.2 | 입력 | CTX=0 자연 길이 모드, doc*.txt 를 읽음 |
NEO
유일하게 매번 손이 가는 곳. model type 허용 + pacpu shape + GPU architecture 별 build.
# pacpu/dtype.h 에 NUM_LAYERS / NUM_Q_HEADS / NUM_KV_HEADS 세 줄을 넣고
bash scripts/models/smoke/neo_pacpu_build_all.sh    # CPU 쪽, shape 별
bash scripts/models/smoke/neo_csrc_build_sm90.sh # GPU 쪽, architecture 별| 항목 | 값 | |
|---|---|---|
| 2.2.13.1 | env · branch | neo · third-party/mistral-ax-support (PSAL-POSTECH/NEO), dtype FP16 고정 |
| 2.2.13.2 | clone 위치 | <ws>/third-party/NEO + <ws>/compressspec symlink |
| 2.2.13.3 | 이미 있는 shape | 32/32/8, 36/32/8, 40/40/8, 48/32/4, 64/64/8, 80/64/8, 40/32/8, 48/64/8, 64/32/8 |
SparseSpec
코드 수정 없음. 경로 이름과 config 두 가지만 맞춘다.
ln -sfn <model_dir> models/<name>-24b-...          # 이름에서 parameter 크기를 읽는다
python -c "import json;p='<model>/config.json';c=json.load(open(p));c.setdefault('eos_token_id',2);json.dump(c,open(p,'w'))"
torchrun --standalone --nproc_per_node=1 serve/run_sat.py --model_name <model> --dtype bfloat16 ...| 항목 | 값 | |
|---|---|---|
| 2.2.17.1 | env · 본체 | sparsespec · baseline/SparseSpec |
| 2.2.17.2 | score tile | (spec_stride+1) × (q/kv). Magistral 36, A.X-3.1 72 (64 초과지만 실행 정상) |
| 2.2.17.3 | 전체 인자 | --kv_cache pillar --admit_policy offloading --chunk_size 2048 --spec_stride 8 --budget_ratio 0.05 |
측정 계약 (RTX PRO 6000 large batch)
Pod 의 /workspace/aime30b 에 Qwen3-30B-A3B-Thinking-2507(yarn2)로 돌린 batch 스윕이 있다. 같은 계약을 따라야 비교가 된다.
| 항목 | 값 | |
|---|---|---|
| 2.2.20.1 | arm | b4r16 ~ b64r256 × {SparseSpec, vanilla}, 요청 수 = batch × 4 |
| 2.2.20.2 | 입력 pool · MAXLEN · OUT_CAP | AIME 2025 30문제 순환 · 40,960 · 39,936 |
| 2.2.20.3 | sampling | temperature 0.6 · top_p 0.95 · top_k 20 · seed 0 (Nebius 장문 실험도 같음) |
| 2.2.20.4 | mem_fraction · chunk | 0.85 · vanilla 16,384 / SparseSpec 2,048 (유일하게 의도한 arm 차이) |
| 2.2.20.5 | SparseSpec | --spec_stride 8 --budget_ratio 0.05 --num_min_budget 128 --clip_length (OUT_CAP + 최장 prompt) + SSPEC_FIXED_OUTPUT |
| 2.2.20.6 | trace | vanilla ITER_TRACE=1 DUMP_INTERVAL=20, SparseSpec SSPEC_ITER_TRACE=1 SSPEC_REQ_TIMING=1 SSPEC_ACCEPT_CHECK=1 |
| 2.2.20.7 | 결과 · 안전장치 | 04_results/<arm>_<TS>/ · 실행 전 memory.used ≥ 500 MiB 이면 거부 |
모델이 권장하는 sampling 값
generation_config.json 에 실제로 들어 있는 값. — 는 미지정. 시스템 간 비교가 목적이면 0.6 / 0.95 / 20 통일, 모델 품질을 보려면 권장값.
| 모델 | temperature | top_p | top_k | max_new_tokens | 출처 | |
|---|---|---|---|---|---|---|
| 2.2.23.1 | 우리 실험값 (기존 계약) | 0.6 | 0.95 | 20 | 39,936 (cap) | run_arm_30b.sh |
| 2.2.23.2 | Qwen/Qwen3-30B-A3B-Thinking-2507 | 0.6 | 0.95 | 20 | — | generation_config.json ↗ |
| 2.2.23.3 | Qwen/Qwen3-32B | 0.6 | 0.95 | 20 | — | generation_config.json ↗ |
| 2.2.23.4 | mistralai/Magistral-Small-2509 | 0.7 | 0.95 | — | 131,072 | generation_config.json ↗ |
| 2.2.23.5 | skt/A.X-3.1 | — | — | — | 28,000 | generation_config.json ↗ |
ctx · 출력 cap · eos
cap 39,936 이 그대로 쓰이는지는 최장 입력 + 39,936 > ctx 로 판정.
| 모델 | native ctx | YaRN | 최장 입력 | 판정 | eos (config / generation_config) | |
|---|---|---|---|---|---|---|
| 2.2.26.1 | Magistral-Small-2509 | 131,072 | 없음 | 872 | 여유 | 2 (우리가 넣음) / 2 |
| 2.2.26.2 | skt/A.X-3.1 | 32,768 | factor 4 → 131,072 | 751 | 초과 | 0 / 27 — SparseSpec 은 [0, 0, 27, 2] 를 모두 stop 으로 잡음 |
| 2.2.26.3 | Qwen3-30B-A3B-Thinking-2507 | 262,144 | 기존 실험은 yarn2 사본 | 872 | 여유 | |
| 2.2.26.4 | Qwen3-32B | 32,768 | factor 4 → 131,072 | 872 | 초과 | |
| 2.2.26.5 | Qwen3-4B-Thinking-2507 | 262,144 | 없음 | 872 | 여유 |
- A.X-3.1·Qwen3-32B 는 cap 을 28,000 이하로 낮추거나 YaRN 사본(
-yarn4처럼 이름으로 구분)을 쓴다. YaRN 은 rope 를 바꾸므로 다른 모델과 같은 조건이 아니다 - A.X-3.1 YaRN 4배 실측(2026-09-20): 자연 종료 중앙값 1,173 token, 강제 채움 시 8-gram 고유율 0.451. 현황 탭 참고
RTX PRO 6000 준비
| 대상 | sm_120 에서 해야 하는 것 | ||
|---|---|---|---|
| 2.2.29.1 | NEO swiftllm_c | TORCH_CUDA_ARCH_LIST=12.0 으로 재빌드 | |
| 2.2.29.2 | NEO pacpu | CPU 전용이라 arch 무관. shape macro 만 있으면 됨 | |
| 2.2.29.3 | vLLM fork _C | `cuobjdump --list-elf _C.abi3.so \ | grep sm_120` 로 확인 |
| 2.2.29.4 | FlashInfer | JIT cache 를 /workspace 로 (/tmp 는 재시작 때 사라짐) | |
| 2.2.29.5 | neo·headinfer env 의 torch | cu121 이라 sm_120 이 없다. 교체 필요. pip install vllm-flash-attn 은 neo env 를 망가뜨리므로 install_fa_shim.py |
| Pod 운영 | 값 | |
|---|---|---|
| 2.2.30.1 | 저장소 · GPU | 300 GB 중 약 120 GiB 여유 (text-only 43.9 GiB 만 받음) · 95.6 GiB 가시 |
| 2.2.30.2 | env | sparsespec, vllm_probe 만 있음. neo·headinfer 는 새로 만들어야 함 |
| 2.2.30.3 | 결과 보존 | /tmp·/root 는 정지 시 사라짐. /workspace 에 둔다 |
| 2.2.30.4 | 접속 | proxy 는 동시 연결 1개. 명령을 겹쳐 보내지 않는다 |
같은 함정이 RTX PRO 6000 에서도 재발한다.
1. 변환본에 Mistral 형식 파일이 남음
- 기(상황) VLM 을 text-only 로 변환해 vLLM 에 올렸다
- 승(증상) shard 를 못 열고
FileNotFoundError. trace 가pixtral.py를 지난다 - 전(원인)
params.json·tekken.json이 남아 vLLM 이 Mistral 형식(VLM loader)으로 오인 - 결(조치) 두 파일을 지운다. 지우면
llama.py경로로 들어간다
2. config 에 eos_token_id 가 없음
- 기(상황) 변환본을 SparseSpec 에 넘겼다
- 승(증상) "Missing required HF config fields" 로 거부
- 전(원인)
text_config를 top-level 로 올릴 때eos_token_id가 빠졌다 - 결(조치)
generation_config.json값을 config 에 넣는다 (Magistral 은 2)
3. 모델 경로 이름에 크기가 없음
- 기(상황) 모델 경로를 받은 이름 그대로 지정했다
- 승(증상) SparseSpec 이
Unsupported <name>으로 거부 - 전(원인) 경로 이름에서 parameter 크기를 정규식으로 읽는 구조
- 결(조치) 이름에
24b·35b가 든 symlink 를 만든다
4. NEO clone 위치
- 기(상황) NEO clone 을 임의 위치에 두고 실행했다
- 승(증상)
numa_first_touch.py를 못 찾는다며 종료 - 전(원인) checkout 기준 4단계 위에서
compressspec/을 찾는다 - 결(조치)
<ws>/third-party/NEO배치 +<ws>/compressspecsymlink
5. GPU architecture 가 다른 build
- 기(상황) L40S 용 build 를 H200 에서 그대로 썼다
- 승(증상)
no kernel image is available for execution - 전(원인)
swiftllm_c가 sm_89 전용. PRO 6000 은 sm_120 이라 더 넓게 발생 - 결(조치)
TORCH_CUDA_ARCH_LIST를 주고 확장을 다시 build
6. CUDA toolkit 과 torch 불일치
- 기(상황) pacpu 를 build 하려 했다
- 승(증상) cmake 가
Failed to find nvToolsExt로 실패 - 전(원인) PATH 의 CUDA toolkit 과 torch 의 cu 버전이 다르다
- 결(조치) torch 에 맞는 toolkit 을
CUDA_HOME으로 지정
7. 한 GPU 에서 두 판이 겹침
- 기(상황) 앞 판이 모델을 올리는 중에 다음 판을 띄웠다
- 승(증상)
CUDA out of memory(KV 53.63 GiB 요청, 4.86 GiB 남음) - 전(원인) 한 GPU 에서 두 판이 동시에 메모리를 잡았다
- 결(조치) 앞 판이 끝나고
memory.used가 0 인 것을 보고 띄운다
모델마다 chat template 이 달라 pool 을 새로 만든다. Qwen3 용 pool 을 재사용하면 안 된다.
python scripts/models/make_aime_pool.py <aime2025.jsonl> <model_dir> <out_dir>
# 결과: p00.txt ~ p29.txt (30문제) + meta.json| 모델 | prompt 길이 | template | |||||
|---|---|---|---|---|---|---|---|
| 2.4.3.1 | Magistral | 144 ~ 872 token | system message 가 없으면 [THINK] system prompt 자동 삽입 | ||||
| 2.4.3.2 | A.X-3.1 | 33 ~ 751 token | `<\ | im_start\ | ><\ | user\ | >` |
| 2.4.3.3 | Granite | 43 ~ 804 token | Granite chat template | ||||
| 2.4.3.4 | Qwen3-4B | 38 ~ 778 token | Qwen3 chat template |
unsloth tokenizer 는 regex pattern 경고가 난다. 본 측정 전에 fix_mistral_regex=True 로 다시 저장할지 정해야 한다.
승인 대기 목록. 모두 clone 에서만 고쳤고 공유 tree 와 dev 에는 올리지 않았다. - 가 수정 전, + 가 수정 후.
[Magistral · A.X-3.1 · Granite] 모델 등록
새 architecture 는 세 곳의 지원 목록에 더해야 한다. 등록하지 않으면 TypeError·assert·pacpu #error 로 멈춘다.
 # HeadInfer — headinfer/mp_modern.py:47-52
+_register("mistral", "MistralForCausalLM", "MistralAttention")
+_register("granite", "GraniteForCausalLM", "GraniteAttention")
 # NEO — swiftllm/model_config.py:7
-SUPPORTED_MODEL_TYPES = ("llama", "qwen3", "qwen3_moe")
+SUPPORTED_MODEL_TYPES = ("llama", "mistral", "granite", "qwen3", "qwen3_moe")
 # NEO — pacpu/dtype.h (MISTRAL_24B 40/32/8 · AX_35B 48/64/8 · GRANITE_30B 64/32/8)
+#elif defined(GRANITE_30B)
+  #define NUM_LAYERS 64
+  #define NUM_Q_HEADS (32 / TP_DEGREE)
+ #define NUM_KV_HEADS (8 / TP_DEGREE)shape 마다 bash build.sh <name> 1 로 .so 를 만든다.
[Granite] attention_multiplier 파라미터 추가
- 기(상황) SparseSpec 과 NEO 는 attention scale 을
1/√head_dim으로 가정한다. 모델이 다른 값을 쓰면 반영할 통로가 없다 - 승(증상) Granite 에서 SparseSpec acceptance 52.35% · 30.07 tok/s, NEO 첫 토큰이 반복·특수문자. 둘 다 오류는 없었다
- 전(원인) Granite 는
attention_multiplier = 0.0078125(1/128)인데 두 엔진이 이 필드를 읽지 않는다.1/√128 = 0.0884와 11.3배 차이 - 결(조치) config 값을 scale 로 흘려 넣는다. 값이 없는 모델은 기존 식. kernel 에 넘기는 상수 하나라 연산량·메모리는 그대로
| 검증 (H200, 정확성 기준) | 수정 전 | 수정 후 | |
|---|---|---|---|
| 2.5.8.1 | SparseSpec acceptance | 52.35% | 86.92% |
| 2.5.8.2 | NEO 첫 토큰 | [100274, 100274, 65, 65, 28, 198] | [1687, 1205, 311, 1505, 7698, 23963] |
| 2.5.8.3 | 회귀 (Magistral, override 없음) | 93.93% | 91.24% — 순전파가 비재현적이라 ±2%p 는 정상 범위 |
patch 원문 6곳 (펼치기)
NEO — swiftllm/model_config.py:41 (생성자)
 self.vocab_size = model_config["vocab_size"]
+self.attention_multiplier = model_config.get("attention_multiplier")
NEO — swiftllm/model_config.py:120-122 (softmax_scale property)
     @property
     def softmax_scale(self) -> float:
-        return self.head_dim ** -0.5
+        # Granite ships attention_multiplier (1/d) instead of the usual 1/sqrt(d).
+        return self.attention_multiplier or self.head_dim ** -0.5
SparseSpec — serve/model/config.py:36-37 (ModelArgs)
     rope_type: str = None
+    attention_multiplier: float = None   # Granite: 1/d instead of 1/sqrt(d)
SparseSpec — serve/attention/backend.py:5
 import math
+
+# set once from the model config; None keeps the 1/sqrt(head_dim) default
+ATTENTION_SCALE_OVERRIDE = None
SparseSpec — serve/attention/backend.py:350 과 :388 (두 곳 모두)
         if self._sm_scale is None:
-            self._sm_scale = 1.0 / math.sqrt(head_dim_qk)
+            self._sm_scale = ATTENTION_SCALE_OVERRIDE or 1.0 / math.sqrt(head_dim_qk)
SparseSpec — serve/run_sat.py:194-198
     model_config = ModelArgs.from_name(config_name)
+    if getattr(model_config, "attention_multiplier", None):
+        from serve.attention import backend as _attn_backend
+        _attn_backend.ATTENTION_SCALE_OVERRIDE = float(model_config.attention_multiplier)
+ logging.info(f"[attn] scale override {model_config.attention_multiplier}")clone 위치
Granite 패치는 2026-09-22 에 서브모듈 baseline_update branch 로 push 했다(origin/dev 에서 분기, dev 는 그대로). dev 반영은 승인 후.
| 대상 | 정본 (push 됨) | 실험용 clone | |
|---|---|---|---|
| 2.5.12.1 | HeadInfer | third-party/headinfer · baseline_update · d85be78 | tmp/headinfer_mistral |
| 2.5.12.2 | NEO | third-party/NEO · baseline_update · 66243ad | tmp/neo_ws/third-party/NEO |
| 2.5.12.3 | SparseSpec | 아직 dev 위 미커밋 | tmp/sparsespec_granite |
NEO 는 clone 만으로는 돌지 않는다. git 에 없는 빌드 산출물 두 개가 더 필요하다.
| 산출물 | 성격 | 없으면 | |
|---|---|---|---|
| 2.5.14.1 | pacpu/build/libpacpu-granite_30b-tp1.so | 모델 shape 을 macro 로 굽는다 (GRANITE_30B 64/32/8) | neo_lb.py:68 assert 에서 멈춘다 |
| 2.5.14.2 | swiftllm_c.cpython-310-*.so | CUDA extension, GPU architecture 별 | no kernel image is available for execution on the device |
2026-09-22 확인은 tmp/neo_ws/pacpu_so/·tmp/neo_ws/ext_sm90/ 을 참조했다. pacpu 재빌드는 CMake 4.4.2 에서 CUDA::nvToolsExt target 이 사라져 실패 → CMake 3.x 로 내리거나 우회.
새 모델 추가 절차
config.json을 받아README.md의 체크리스트 14개를 대조한다.- VLM 이면 text-only 로 변환한다.
- NEO pacpu 에 (층/q/kv) shape 가 있는지 보고, 없으면 macro 추가 후 build 한다.
- 이름에
<크기>b가 든 경로와eos_token_id를 준비한다. - 그 모델의 chat template 으로 AIME pool 을 만든다.
- smoke 를 vLLM → HeadInfer → SparseSpec → NEO 순서로, 한 번에 하나씩 돌린다.
KV per token = 2 (K,V) × layers × kv_heads × head_dim × dtype_bytes     ← num_key_value_heads 를 쓴다
Granite-4.2-30B BF16 = 2 × 64 × 8 × 128 × 2 = 262,144 B = 256 KiB
KV pool   = GPU total × gpu_memory_utilization − weight − overhead
max token = KV pool ÷ (KV per token) ← prompt + generation 합계 상한| 모델 | layers | q | kv | ratio | KV / token | weight | |
|---|---|---|---|---|---|---|---|
| 2.6.2.1 | Qwen3-4B-Thinking-2507 | 36 | 32 | 8 | 4 | 144 KiB | 7.49 GiB |
| 2.6.2.2 | Qwen3-30B-A3B (MoE) | 48 | 32 | 4 | 8 | 96 KiB | 56.87 GiB (상주. decode 가 읽는 byte 는 활성 expert 만) |
| 2.6.2.3 | Magistral-Small-2509 | 40 | 32 | 8 | 4 | 160 KiB | 43.91 GiB |
| 2.6.2.4 | Granite-4.2-30B | 64 | 32 | 8 | 4 | 256 KiB | 54.53 GiB |
| 2.6.2.5 | Llama-3.1-8B-Instruct | 32 | 32 | 8 | 4 | 128 KiB | 14.96 GiB |
GPU 메모리는 H200 143,771 MiB(n88) · L40S 46,068 MiB(n82) · RTX PRO 6000 97,887 MiB(Nebius) 실측, RTX 4090 24,564 MiB 만 스펙값.
| 컨텍스트 | KV | 동시 요청 |
|---|
overhead 기본값 4.59 GiB 의 근거와 한계 (펼치기)
Granite-4.2-30B · H200 · util 0.95 에서 vLLM 이 찍은 GPU KV cache size: 304,176 tokens 를 역산.
140.40 GiB × 0.95 − 54.53 − 4.59 = 74.26 GiB.
overhead 는 activation buffer 와 CUDA graph 라 GPU·모델·max_num_batched_tokens 에 따라 달라진다.
다른 조합에 4.59 를 그대로 쓰지 말고 한 번은 엔진을 올려 GPU KV cache size 를 보고 맞춘다.
Qwen3-4B · RTX PRO 6000 · fraction 0.85 의 SparseSpec 로그(Model 7.45 GB, KV 73.27 GB)는 overhead 가 거의 0 으로 보이나
vLLM 회계와 같은 기준인지 확인하지 않았다. 동시 요청 수는 KV pool 만 본 상한이고 스케줄러는 더 적게 받는다.
결과
측정 노드 Nebius RTX PRO 6000 (81.85.1.77, 97,887 MiB).
| 항목 | 값 | |
|---|---|---|
| 3.1.2.1 | batch · 요청 | batch × 4 (pool 30문제 순환), 요청수 − batch 개 완료 시 중단 |
| 3.1.2.2 | 출력 cap | 32,768 (batch 스윕) · 39,936 (스윕 이전 고정판) |
| 3.1.2.3 | sampling | temperature 0.6 · top_p 0.95 · top_k 20 · seed 0 |
| 3.1.2.4 | vanilla | CompressSpec fork 0.14.1.dev236 의 compression 스위치를 끈 arm, core 0-3 |
| 3.1.2.5 | SparseSpec | spec_stride 8 · budget_ratio 0.05 · num_min_budget 128, core 0-23 |
| arm | batch | 요청 | 상태 | |
|---|---|---|---|---|
| 3.1.3.1 | mag_van_b8r32_c32k · mag_ss_b8r32_c32k | 8 | 32 | 완료 |
| 3.1.3.2 | mag_van_b16r64_c32k · mag_ss_b16r64_c32k | 16 | 64 | 완료 |
| 3.1.3.3 | mag_van_b32r128_c32k | 32 | 128 | 진행 중 |
| 3.1.3.4 | mag_ss_b32r128_c32k | 32 | 128 | 대기 |
| 3.1.3.5 | b64 van · SS | 64 | 256 | 대기 |
| batch | vanilla stable | SparseSpec stable | 배수 | vanilla KV util | |
|---|---|---|---|---|---|
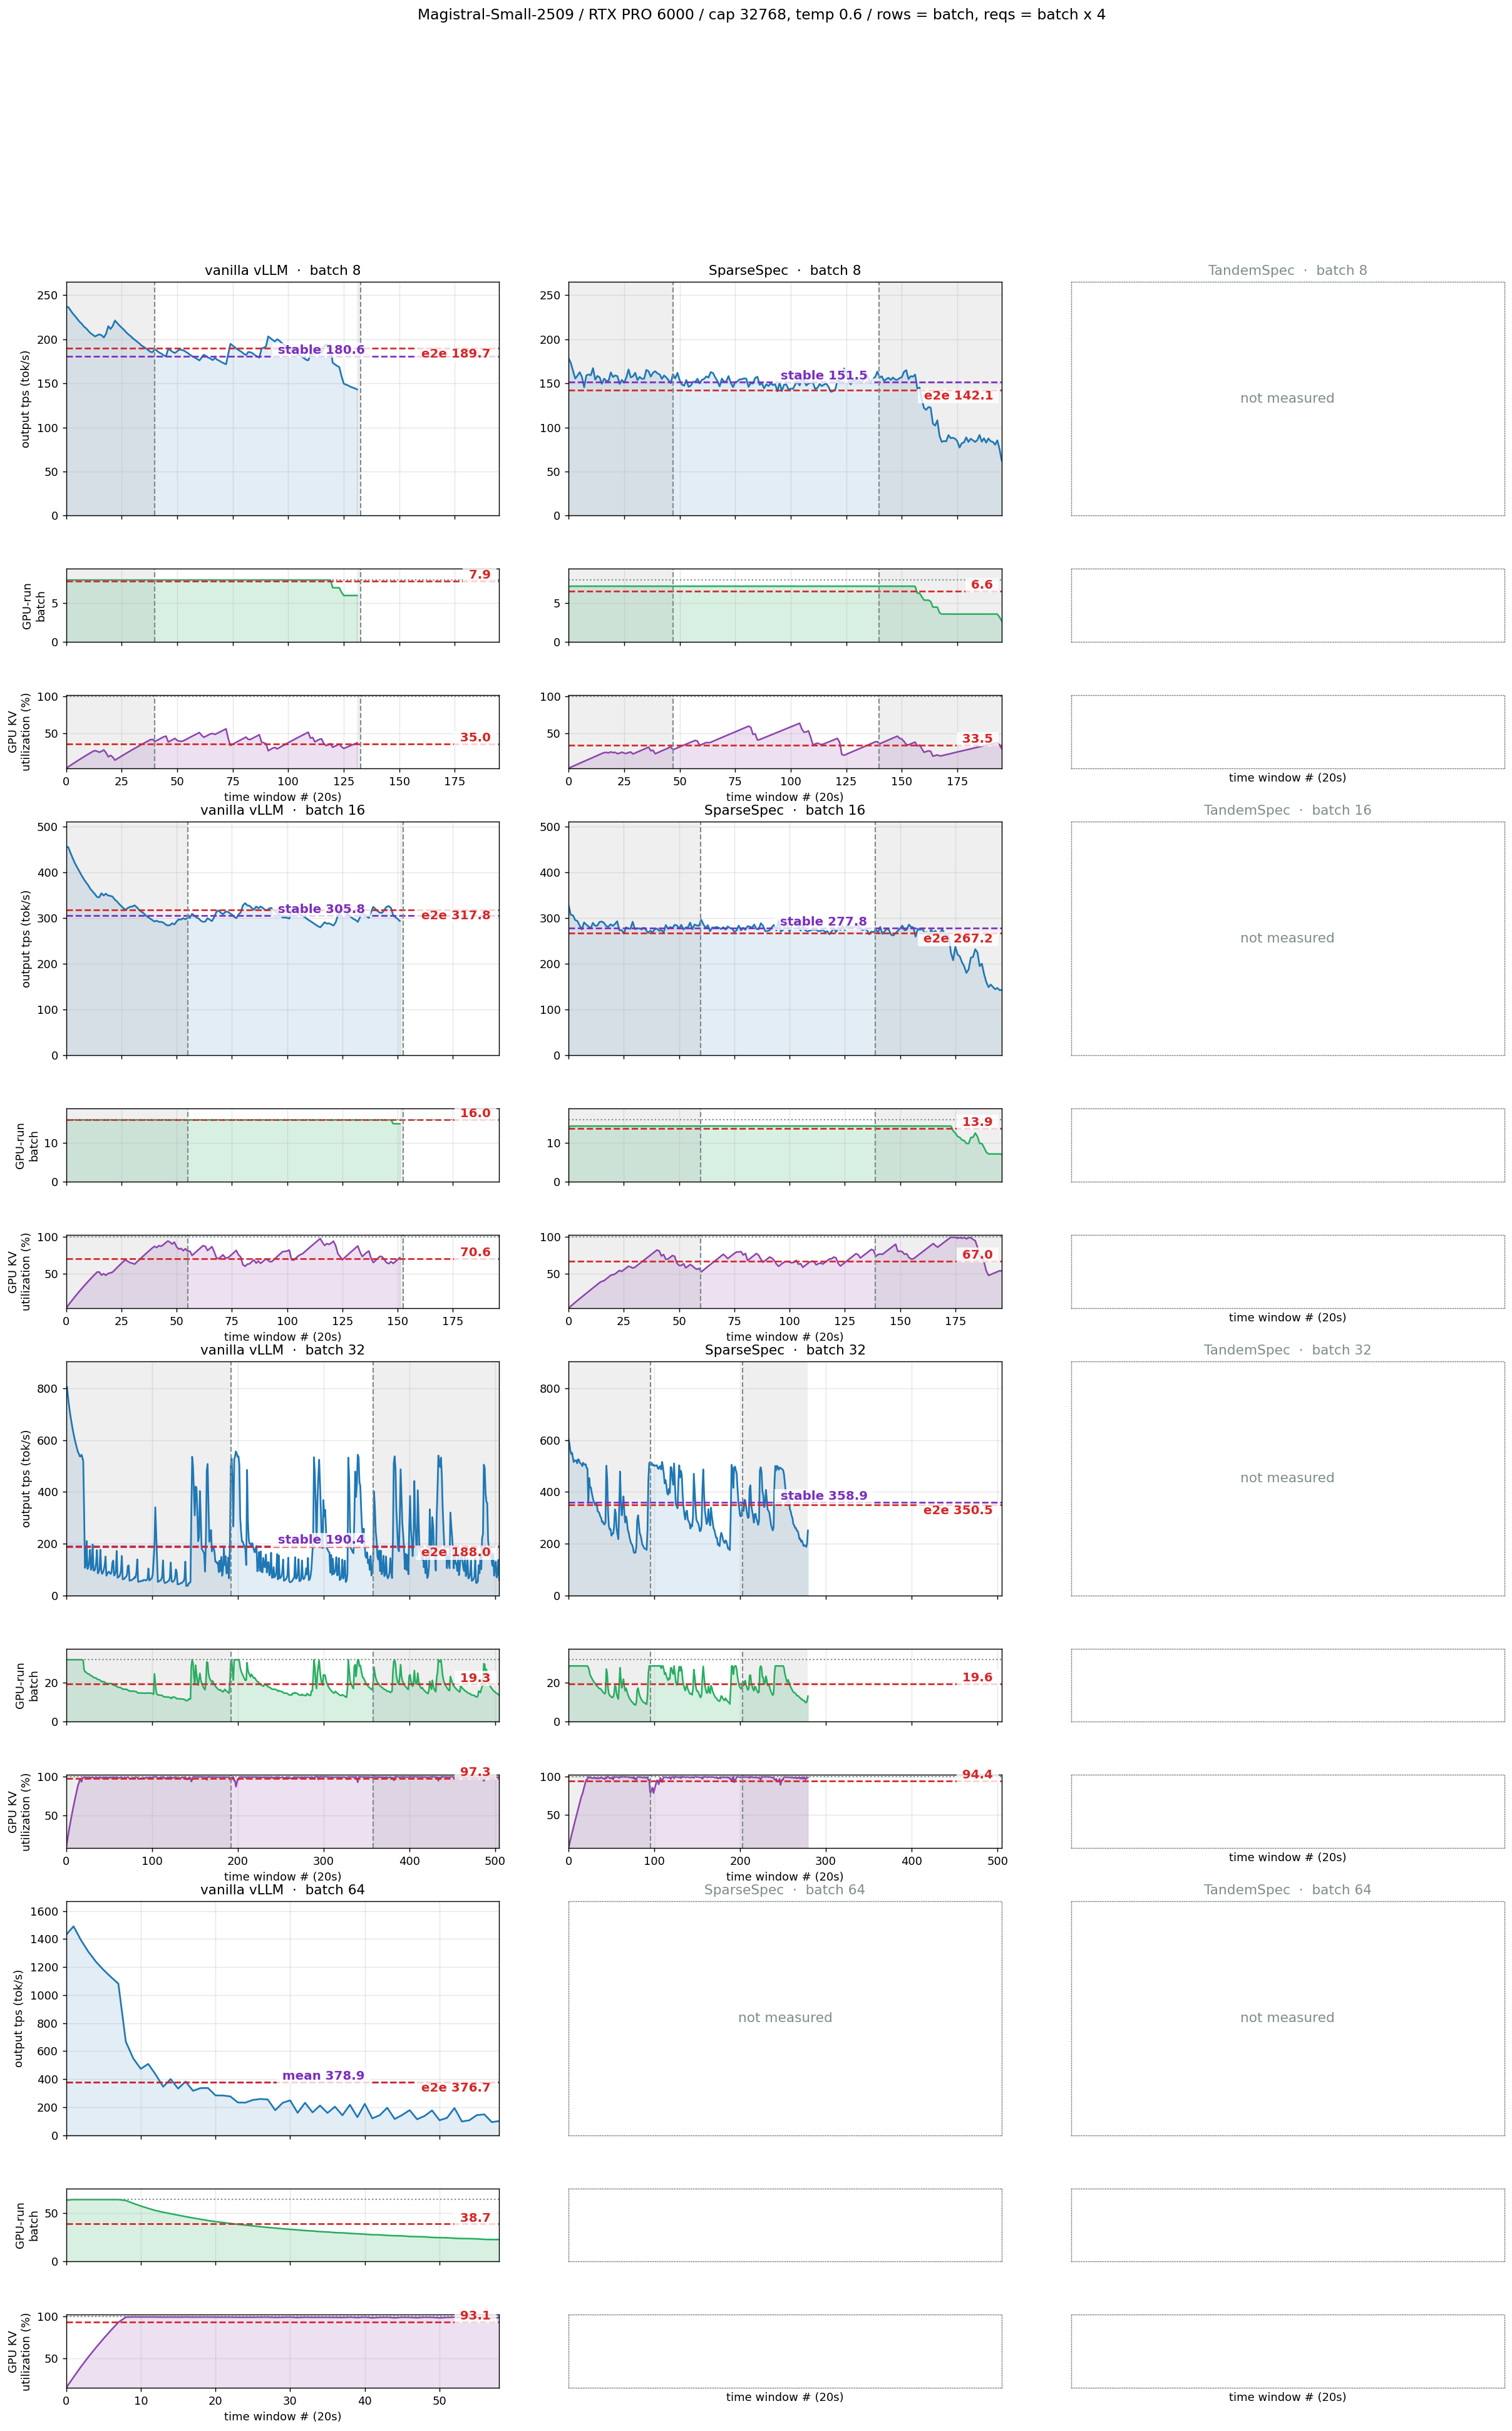
| 3.1.5.1 | 8 | 180.6 | 151.5 | 0.84 | 35.0% |
| 3.1.5.2 | 16 | 305.8 | 277.8 | 0.91 | 70.6% |
| 3.1.5.3 | 32 | 진행 중 | 대기 | — | 96.1% |
batch 를 올리면 KV utilization 과 배수가 같이 오르지만 아직 1 을 넘지 못했다. stable window 는 앞 batch 개 완료(warmup)를 빼고 시작하며, 요청수 − batch 에서 중단한 run 은 cooldown 이 없어 뒤를 자르지 않는다.
| cap 39,936 고정판 (스윕 이전) | vanilla b8r32 | SparseSpec b8r32 | |
|---|---|---|---|
| 3.1.7.1 | stable tps | 184.2 | 153.4 (0.83배) |
| 3.1.7.2 | acceptance rate | — | 78.41% (verify step 80,377, 504,124 / 642,896) |
| 3.1.7.3 | 출력 길이 중앙값 | 14,896 | 16,644 |
breakdown 뷰어
BD_COARSE=1 phase timeline. 조건과 읽는 법은 3.2 Granite 와 같다.
| 조건 | 값 | |
|---|---|---|
| 3.1.10.1 | 모델 · 노드 | Magistral-Small-2509 (text-only, 40층 · kv 8) · n88 H200 1장 |
| 3.1.10.2 | 컨텍스트 | 32,768 token · decode 16 token · warmup 1 · iters 1 |
| 시스템 | prefill (iter0) | decode | phase row | 시간이 쌓이는 곳 | |
|---|---|---|---|---|---|
| 3.1.11.1 | HeadInfer | 5.93 s | 733 ms/tok | 16,978 | PCIe h2d 9.46 s · d2h 1.97 s (GPU attn 2.39 s) |
| 3.1.11.2 | NEO | 3.7 s | 139 ms/tok | 3,554 | CPU pacpu 1.88 s (PF 5.97 s · DC 2.49 s) |
pseudo-layer 40 × 8 = 320 이라 Granite(512)보다 PCIe 항목이 적다(PCIe 11,200 vs 17,920). 층수 × kv head 수가 그대로 전송 횟수다.
n88(H200)에서 네 시스템 확인 완료. 수정 내용은 2.5 코드 수정, 판정은 정확성 기준(속도는 H200 값이라 적지 않음).
| 시스템 | 상태 | 적용한 수정 | 판정 근거 | |
|---|---|---|---|---|
| 3.2.2.1 | vLLM 엔진 | 통과 | 없음 | registry 에 있고 attention_multiplier 를 읽음 |
| 3.2.2.2 | HeadInfer | 통과 | registry 한 줄 | 64층 × 8 kv = 512 pseudo-layer 로 동작 |
| 3.2.2.3 | SparseSpec | 통과 | attention scale override | acceptance 52.35% → 86.92% |
| 3.2.2.4 | NEO | 통과 | granite type · scale · pacpu 64/32/8 | 첫 토큰이 반복·특수문자에서 정상 토큰으로 바뀜 |
서브모듈 baseline_update 재확인 (2026-09-22, n88)
- 기(상황) 패치를 서브모듈로 옮긴 뒤 같은 노드에서 같은 26-token 프롬프트(
chat_template.jinja적용)로 다시 돌렸다. vanilla transformers 를 대조군으로 - 승(증상) 세 경로의 token id 가 완전히 일치. vanilla 32 tok = HeadInfer 32 tok, NEO 는 생성한 17 tok 전부 동일
- 전(원인) 셋 다 greedy 라 일치 = 세 구현이 옳다. 통상 경로로 빠진 것이 아님은 아래 속도·경로로 확인
- 결(조치) 스크립트
jh_script/claude_script/granite_baseline_check/. neo env 의 transformers 는chat_template.jinja를 못 읽으므로 직접 넣는다
| forward | KV 위치 | 속도 | ||
|---|---|---|---|---|
| 3.2.5.1 | vanilla | forward (기본) | 전부 GPU | 52 ms/tok |
| 3.2.5.2 | HeadInfer | headinfer_attention_forward (layer_idx_base=504) | cpu=510 / gpu=2 | 429 ms/tok (8.3배 느림 = CPU 왕복의 증거) |
| 3.2.5.3 | NEO | swiftllm 자체 엔진 | [POOL] owned=1 k_pinned=True v_pinned=True | 65 ms/tok, softmax_scale=0.0078125 확인 |
breakdown 뷰어
BD_COARSE=1 phase timeline. phase 경계마다 cuda.synchronize() + perf_counter() 를 찍어 긴 컨텍스트에서도 돈다. 레인은 GPU · PCIe · CPU.
| 조건 | 값 | |
|---|---|---|
| 3.2.8.1 | 모델 · 노드 | Granite-4.2-30B · n88 H200 1장 |
| 3.2.8.2 | 컨텍스트 · decode | 32,768 token (lb_docs_synth/doc0.txt) · 16 token, warmup 1 · iters 1 |
| 시스템 | prefill (iter0) | decode | phase row | 시간이 쌓이는 곳 | |
|---|---|---|---|---|---|
| 3.2.9.1 | HeadInfer | 8.71 s | 1,171 ms/tok | 27,154 | PCIe h2d 15.1 s · d2h 3.1 s (GPU attn 3.8 s) |
| 3.2.9.2 | NEO | 5.1 s | 218 ms/tok | 5,666 | CPU pacpu 3.0 s (PF 7.95 s · DC 3.85 s) |
HeadInfer 는 토큰마다 KV 를 CPU 에서 다시 끌어와 PCIe 18.2 초가 GPU attention 3.8 초를 압도한다.
HeadInfer 의 h2d/d2h 는 BD_PREALLOC_CACHE=1 이 있어야 찍힌다. 빠뜨리면 PCIe·CPU 레인이 비고 전부 attn 으로 남아 계측 누락을 성능 특성으로 오독한다(2026-09-22 실제 발생).
RTX PRO 6000 측정 (cap 32,768)
긴 컨텍스트 준비와 생성 품질은 2.1 Granite. 한 GPU 에 한 판씩 순차. sampling 은 generation_config.json 기본값.
| 항목 | 값 | |
|---|---|---|
| 3.2.15.1 | batch · 요청 | 8 · 32 (pool 30문제 순환) |
| 3.2.15.2 | 출력 cap · sampling | 32,768 (MAXLEN 33,792) · temperature 1.0 · top_p 0.95 · seed 0 |
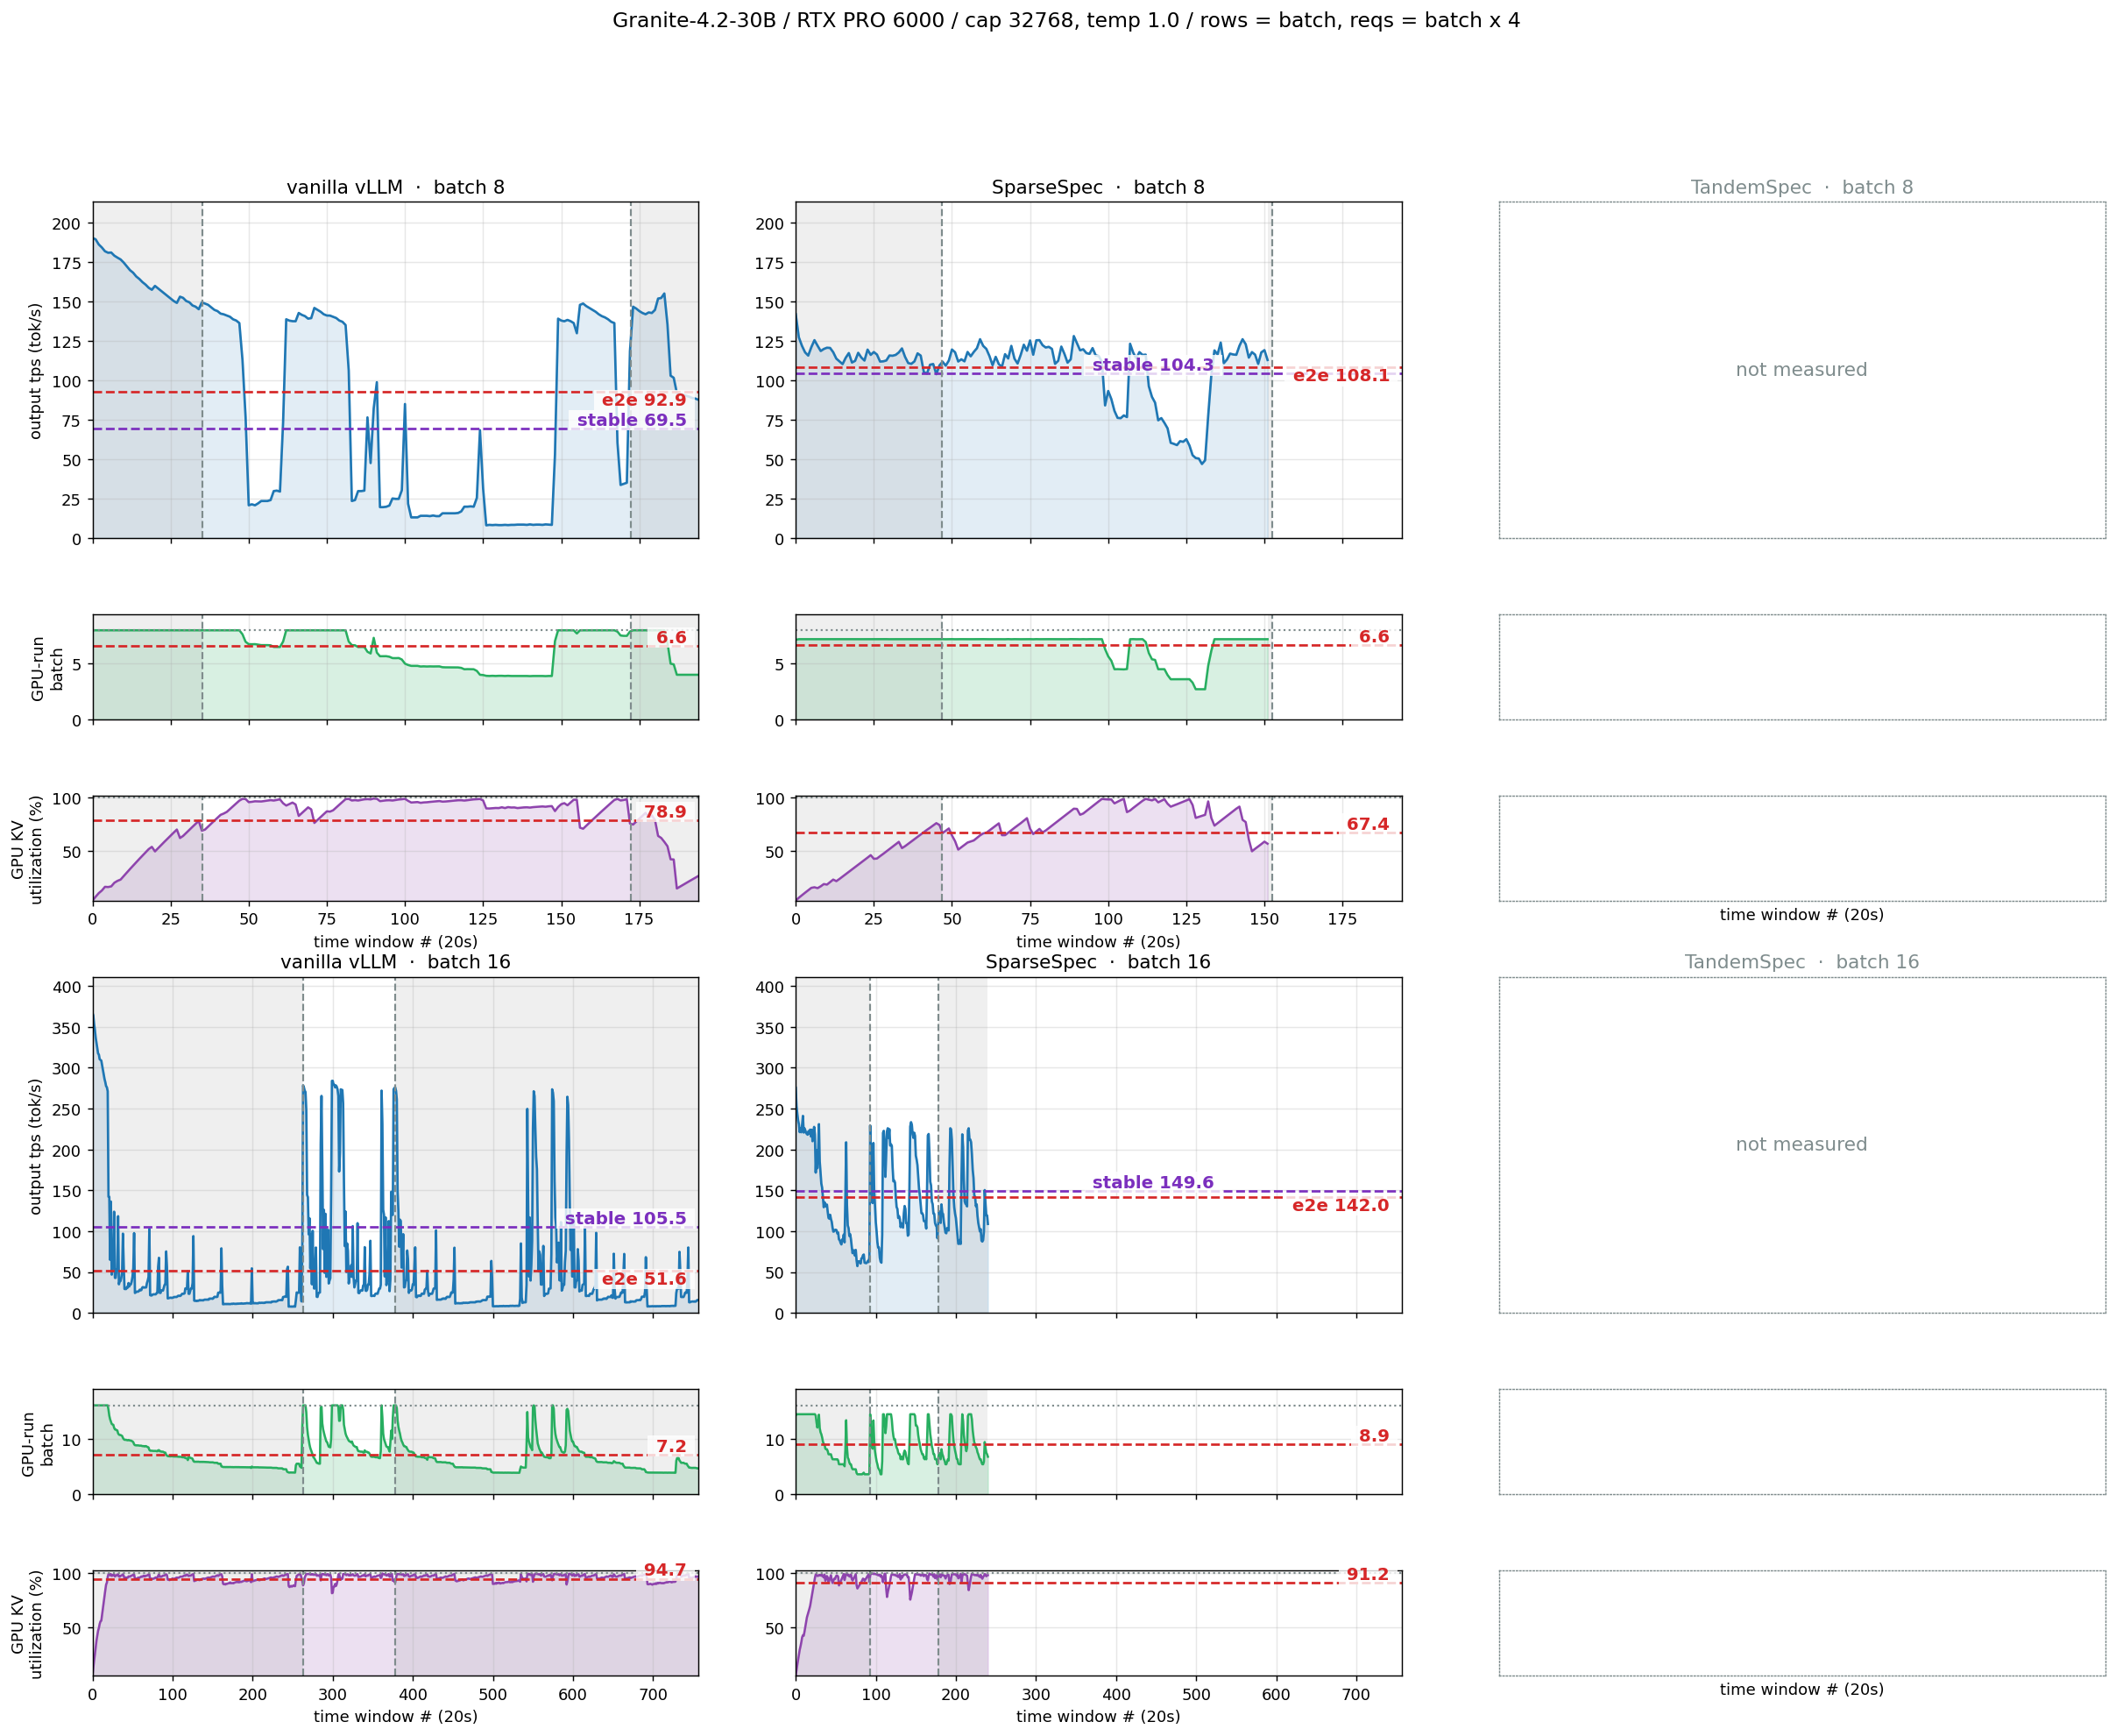
| 3.2.15.3 | arm | gra_van_b8r32_c32k 28/32 중단 (kv_util 100%, preempted) · gra_ss_b8r32_c32k 24/32 중단 |
| 값 | vanilla b8r32 (28/32) | SparseSpec | |
|---|---|---|---|
| 3.2.17.1 | stable tps | 69.5 tok/s | 104.3 tok/s (1.50배) |
| 3.2.17.2 | e2e tps | 92.9 tok/s | 108.1 tok/s |
| 3.2.17.3 | GPU KV utilization 평균 | 78.9% | 67.4% |
- 기(상황) 8 요청 × 32K × 256 KB = 65 GB 가 필요한데 KV pool 은 23.2 GB
- 승(증상) vanilla
kv_util이 1.000 에 닿고 preemption 발생,running8 → 6.67 - 전(원인) vanilla 가 무너지는 구간에 처음 들어간 판. KV 가 GPU 를 넘치면 SparseSpec 이 이긴다
- 결(조치) cap 8,192 → 32,768 로 평균 out_tok 6,490 → 11,946 (1.84×, 중앙값은 8,192 → 8,478). vanilla stable 172.7 → 93.1, KV util 26.5% → 82.3%
| 폐기한 판 cap 8,192 | 내용 | |
|---|---|---|
| 3.2.19.1 | 폐기 사유 | 32개 중 20개가 cap 에 걸려 length 종료. KV 가 쌓이기 전에 끝나 f 가 0.11 |
| 3.2.19.2 | 남긴 수치 | vanilla stable 172.7 · SparseSpec 118.8 (0.69배), acceptance 70.42% |
| 3.2.19.3 | scale override 효과 | Nebius 트리에 override 가 없던 첫 판 acceptance 15.36% · tps 39.5 → 이식 후 71.09% · 118.8 (_ABORTED_no_scale_override 보존) |
| 3.2.19.4 | 파일 | cs/run/granite/gra_van_b8r32_20260920_105100, gra_ss_b8r32_20260920_120712 |
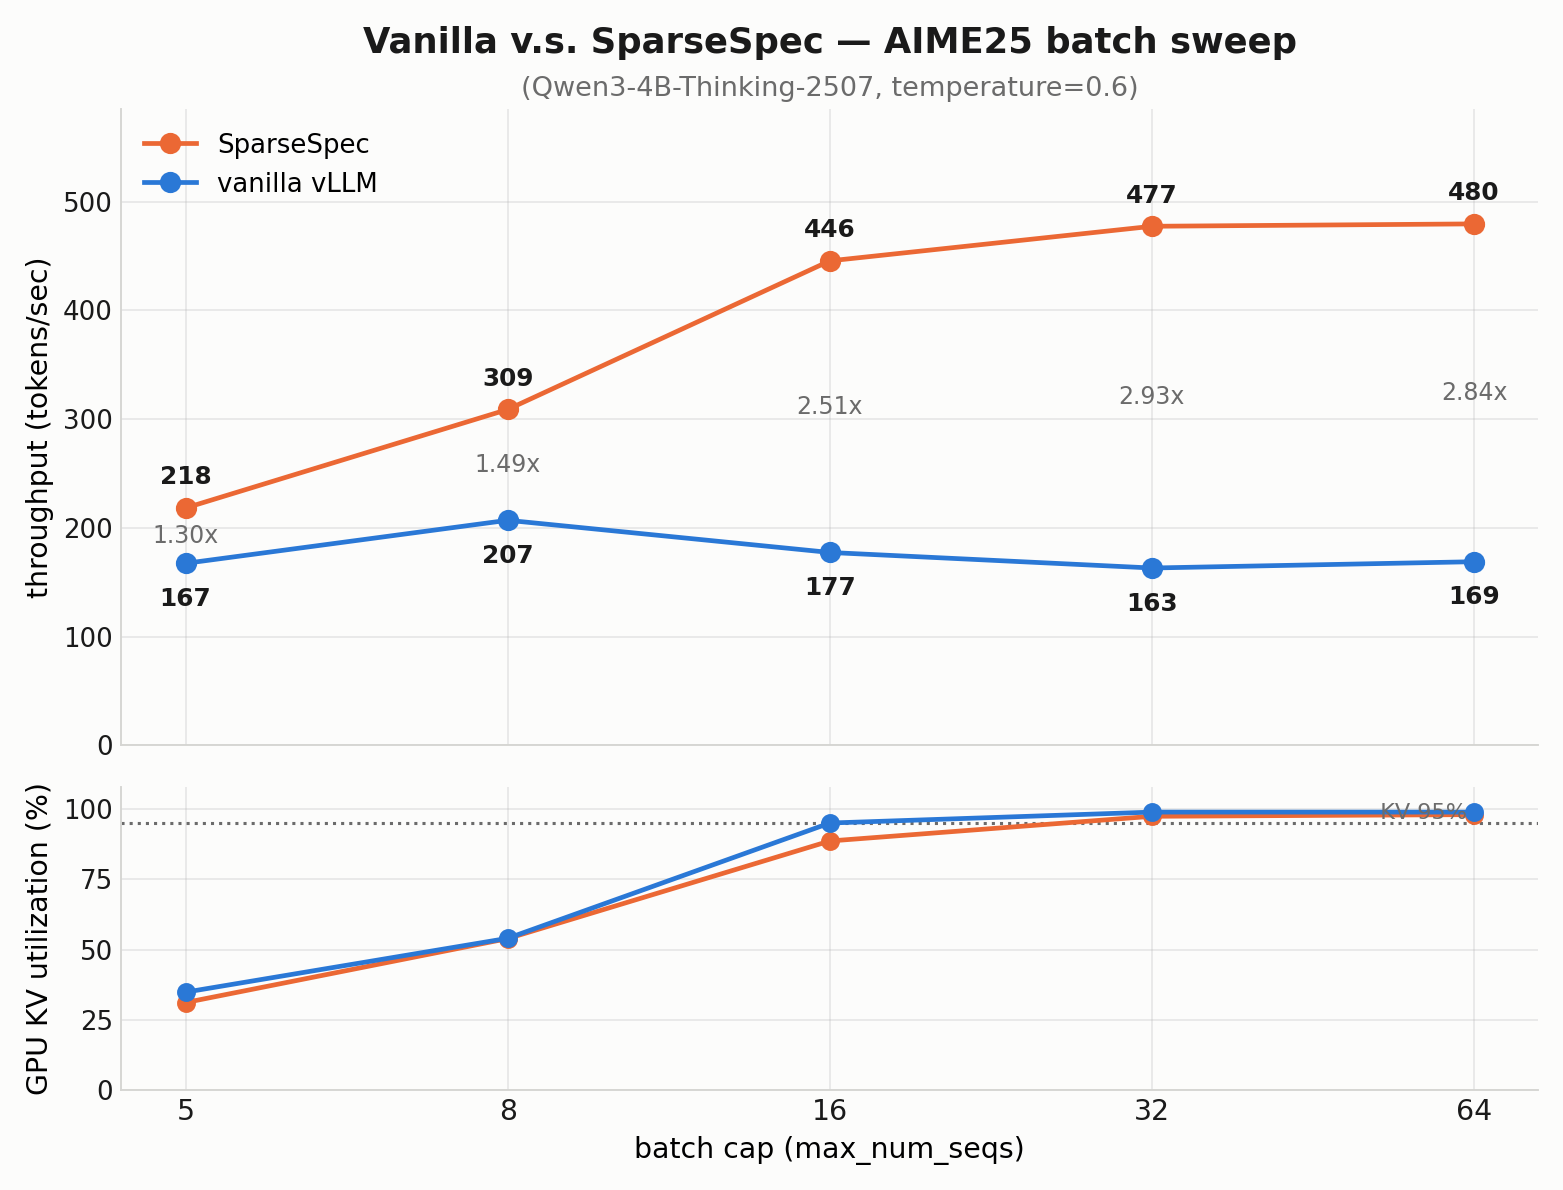
논문 조건을 그대로 두고 GPU 만 Blackwell 로 바꾼 대조군. 논문(L40S)은 b8 1.49배 · b16 2.51배 · b32 2.93배.
| 항목 | 값 | |
|---|---|---|
| 3.3.2.1 | 모델 | 36 layer · 32 q · 8 kv · head_dim 128 · weight 7.6 GB |
| 3.3.2.2 | batch · 요청 · cap | 8 · 32 (24개에서 중단, 뒤 8개는 cooldown) · 81,920 (MAXLEN 83,968) |
| 3.3.2.3 | sampling · pool | temperature 0.6 · top_p 0.95 · top_k 20 · seed 0 · Qwen3 template 30문제 |
| 값 | vanilla b8r32 | SparseSpec b8r32 | |
|---|---|---|---|
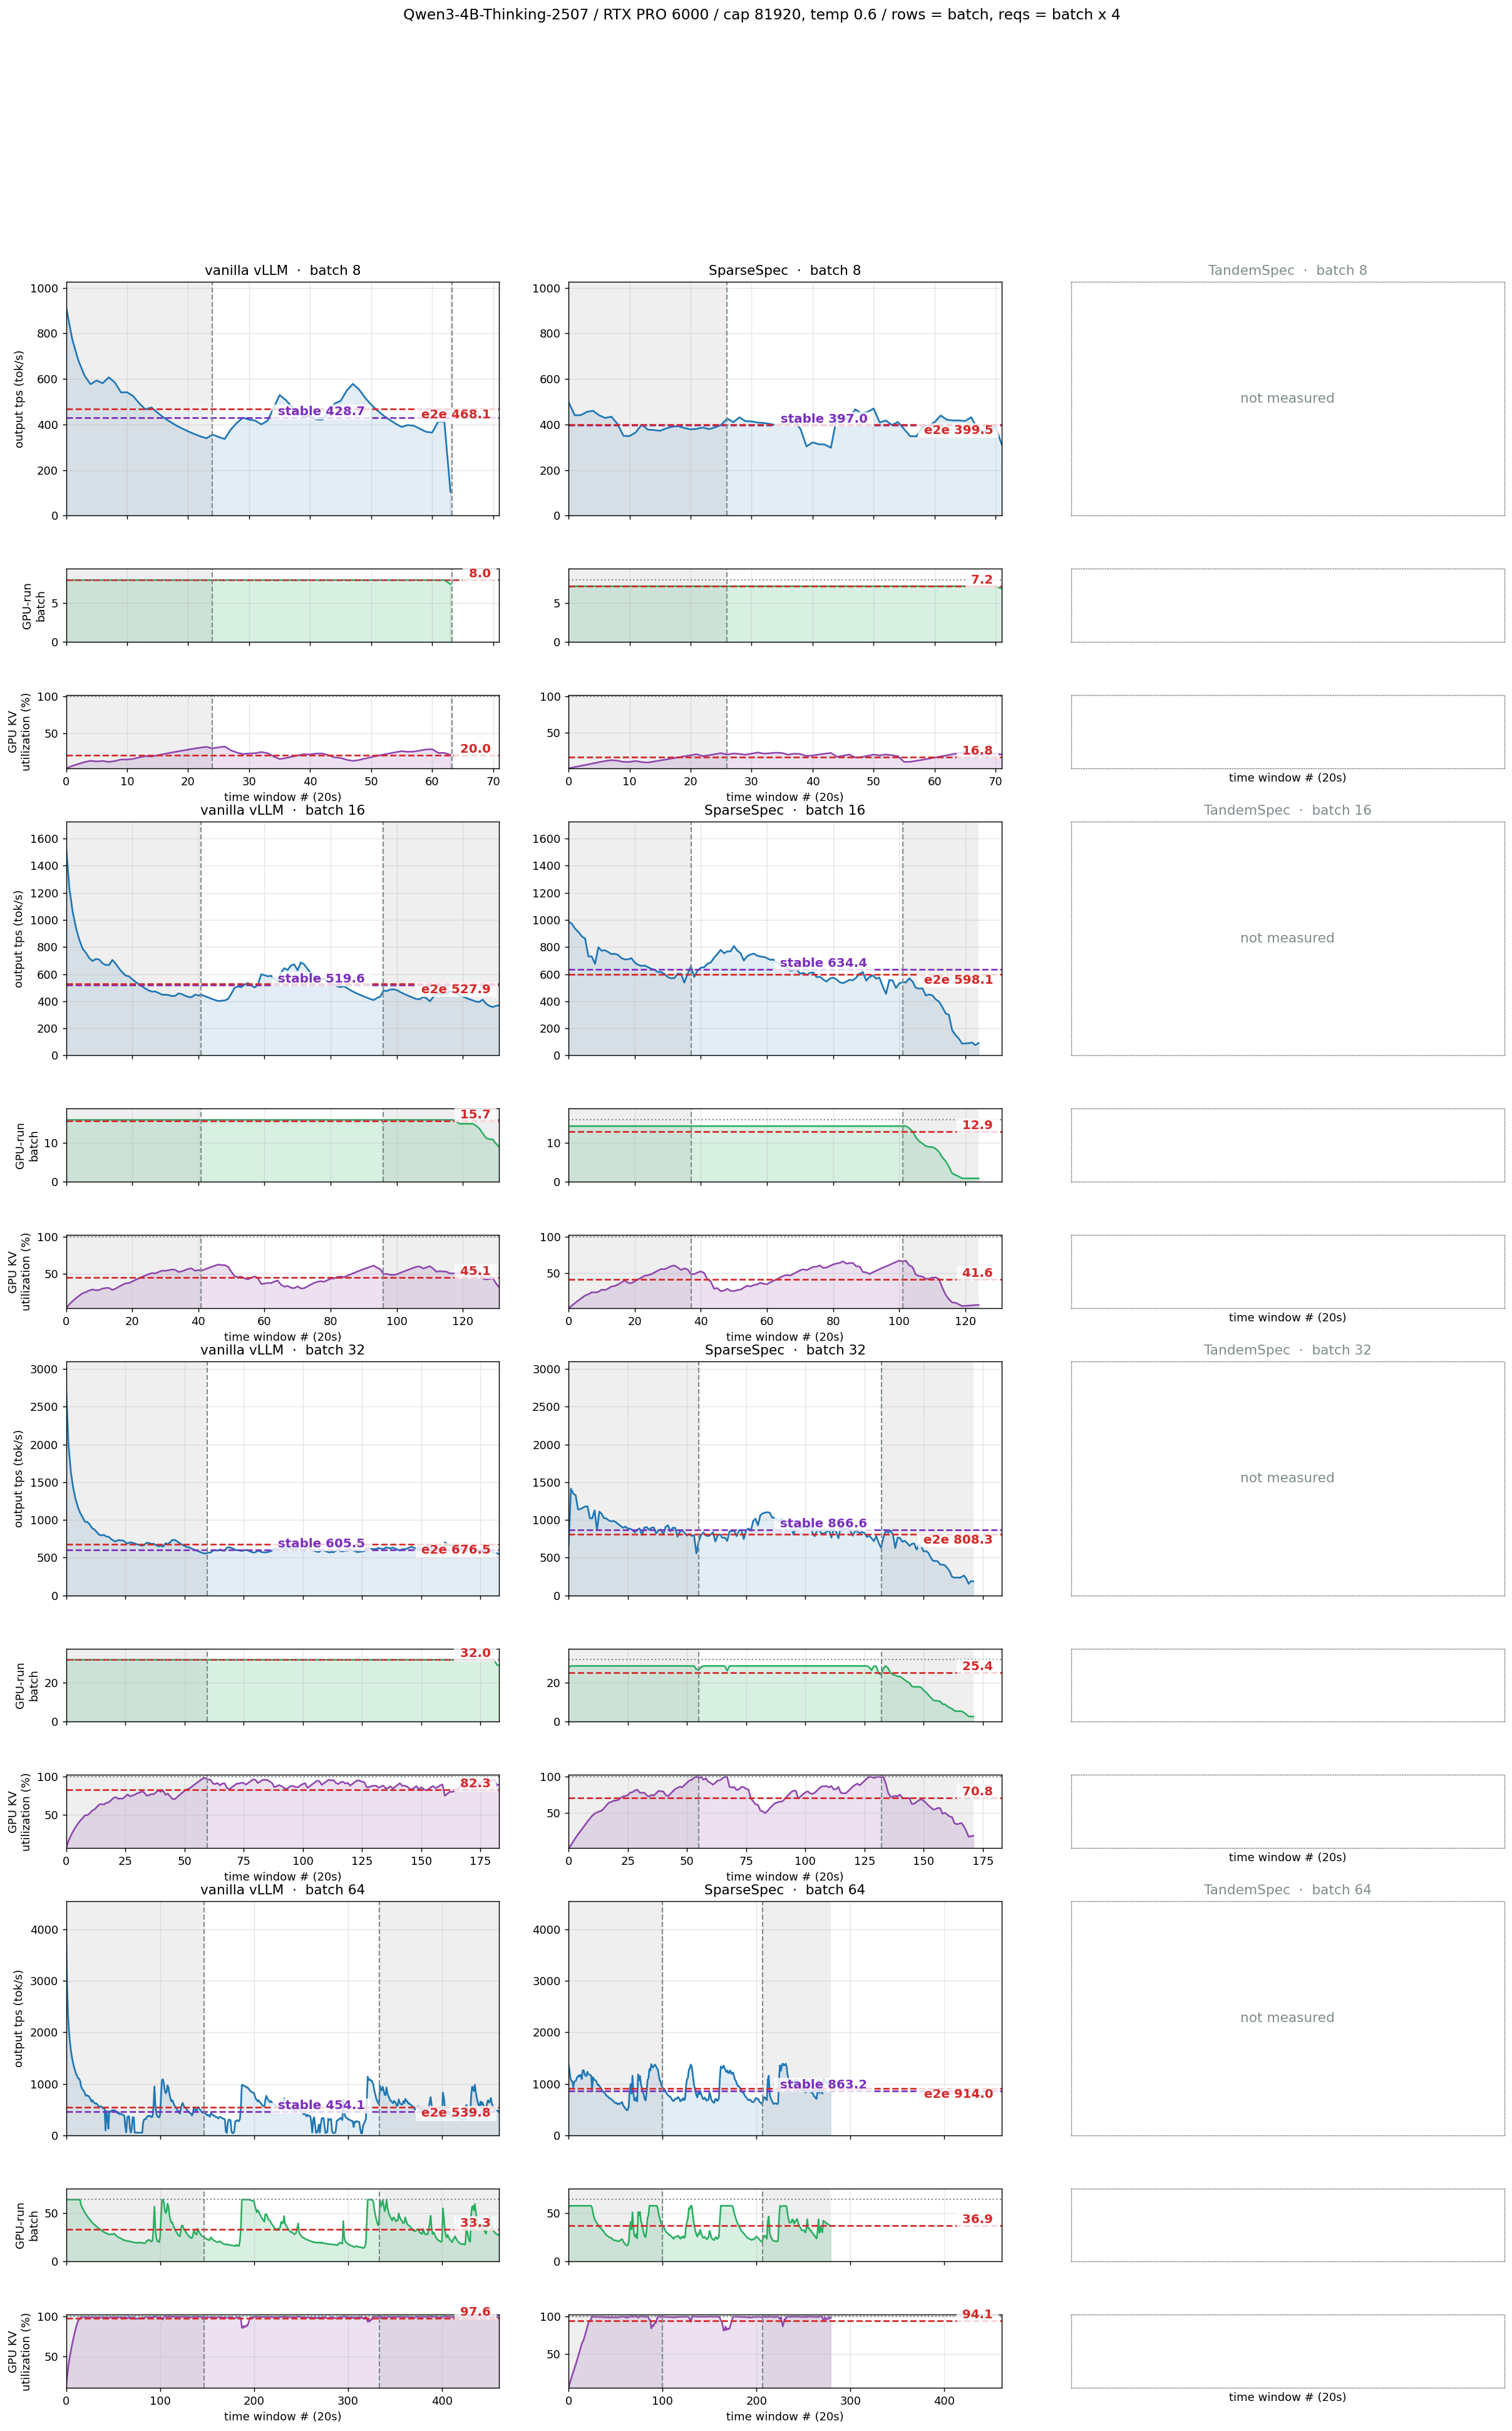
| 3.3.4.1 | stable tps | 424.4 tok/s | 400.9 tok/s (0.94배) |
| 3.3.4.2 | e2e tps | 468.1 | 394.4 |
| 3.3.4.3 | GPU KV utilization 평균 | 20.0% | 15.6% (최대 23.0%) |
| 3.3.4.4 | acceptance rate | — | 72.20% |
| 3.3.4.5 | 출력 길이 | 중앙값 18,910 (6,734 ~ 41,604), 25개 전부 EOS | 완주 후 집계 |
- 기(상황)
f가설(vanilla iteration 중 attention 비율)은 상주 KV 절대량이 같으면 같은 배수를 예측한다 - 승(증상) 논문 L40S b8 은 상주 KV 약 17.4 GB 에서 1.49, 우리 PRO 6000 b8 은 약 16.9 GB 에서 0.94
- 전(원인) 미규명. 후보는 Blackwell persistent attention kernel 의 CTA 절반, CUDA graph 미적용 iteration(32~38%, +20 ms), round 당 iteration 10개
- 결(조치) L40S trace 에 같은 분석을 적용해 draft-only KV 기울기가 Ada 에서도 60% 인지 확인 (GPU 불필요,
800마운트 복구 필요)
vanilla 초반 tps 는 4B 593 · Magistral 239 · Granite 190. weight 가 작을수록 iteration 당 읽는 byte 가 적다.
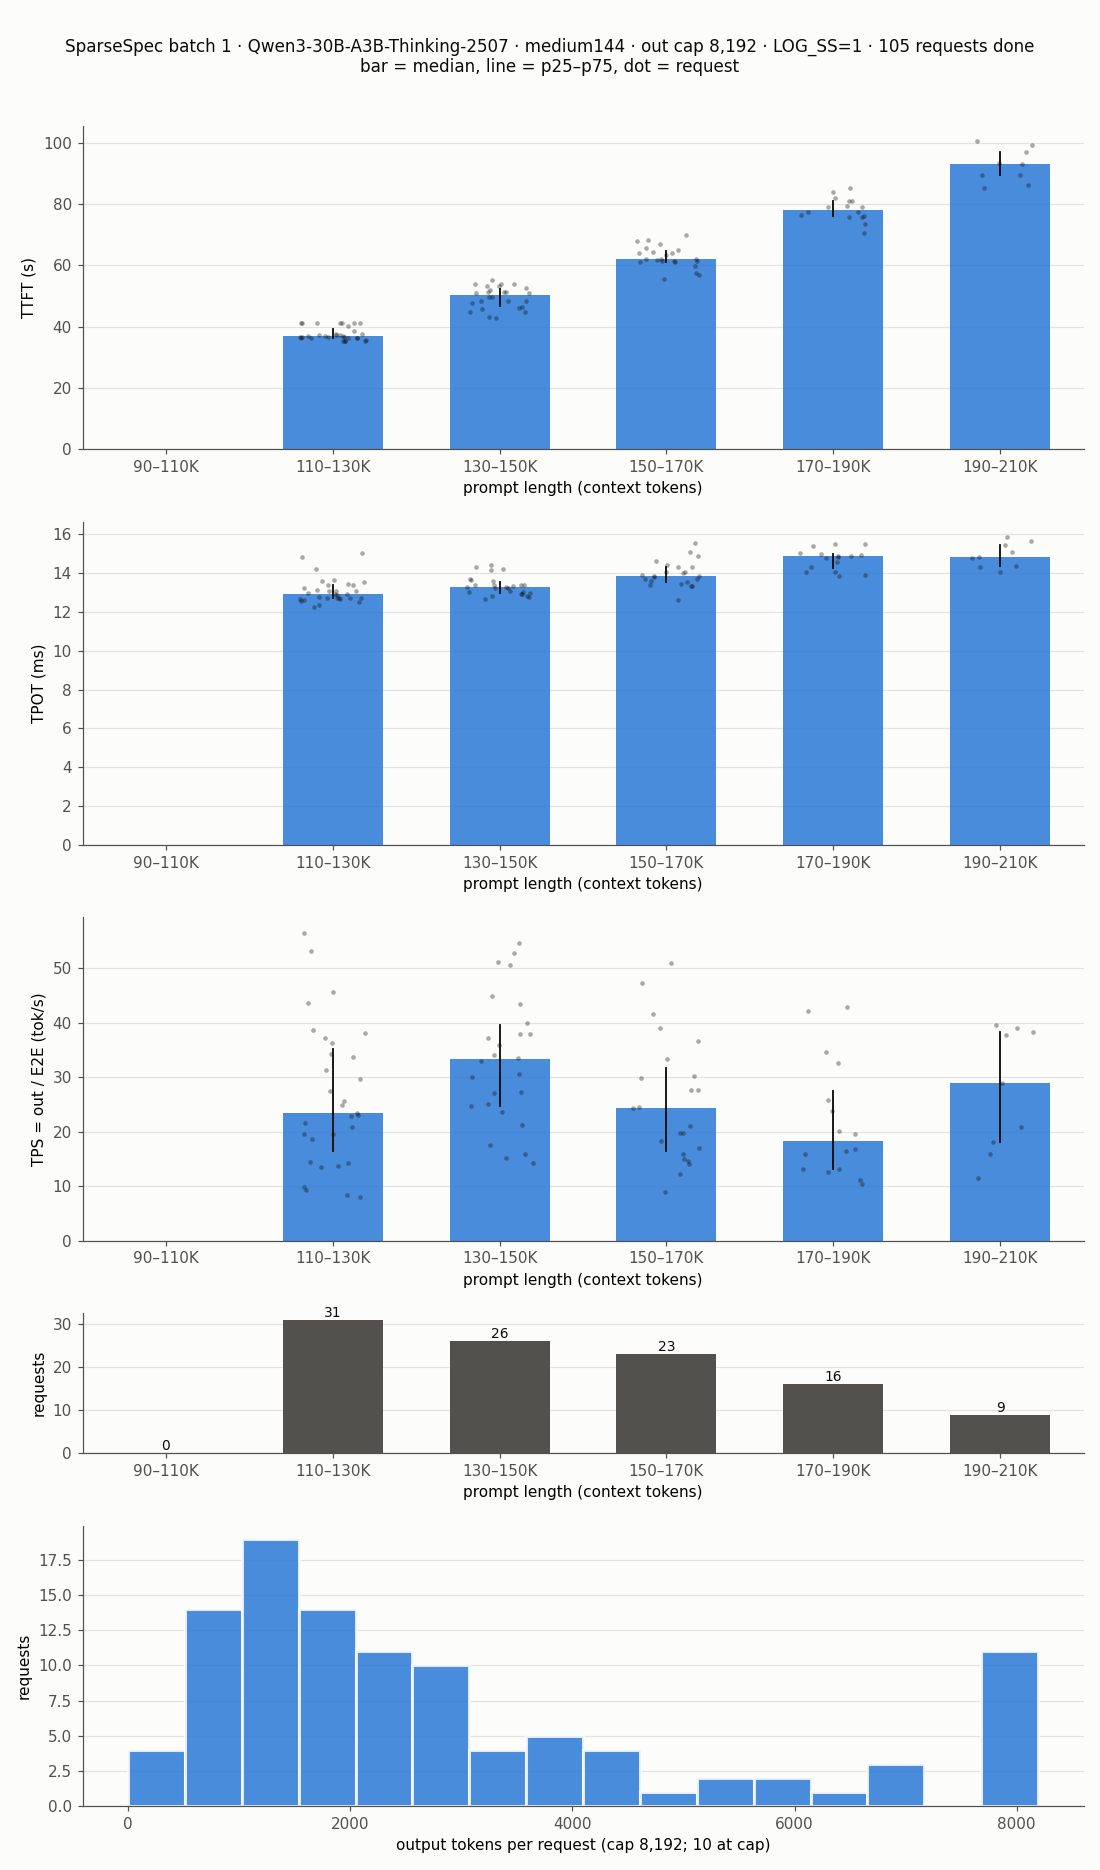
SparseSpec batch 1 · Qwen3-30B-A3B-Thinking-2507 base · medium144 · 출력 상한 8,192 · LOG_SS=1 — 105/144 에서 정지 (vanilla 판으로 GPU 를 넘기며 멈춤, 실패 0). 이전 LOG_SS=2 판은 계측 비용으로 TPOT 이 약 1.6배 부풀려져 폐기(Marvell_cloud/011·012, TPOT·E2E 사용 금지).
| 항목 | 값 | |
|---|---|---|
| 3.4.2.1 | 모델 | Qwen3-30B-A3B-Thinking-2507 (base, 창 262,144, YaRN 미사용), bf16 |
| 3.4.2.2 | 문서 | results/RTXPRO6000/longcontext/medium144_selection.json 144개 중 긴 순서로 105개 완료 |
| 3.4.2.3 | SparseSpec | commit 8246fb6 · batch 1 · chunk 2048 · spec_stride 7 · budget_ratio 0.05 · mem_fraction 0.85 · SSPEC_CPU_CAP_MULT=1 · SSPEC_MAX_SELECTED_KV=16384 |
| 3.4.2.4 | 생성 · 실행 | 자연 EOS · 상한 8,192 · temp 0.6 / top_p 0.95 / top_k 20 · seed 0 · Nebius 81.85.4.145 × 8, 문서당 프로세스 1개 |
| 3.4.2.5 | 지표 | TTFT = t_first − t_start · TPOT = (t_done − t_first)/(out − 1) · E2E = t_done − t_start |
| 3.4.2.6 | 결과 | /mnt/filesystem-p1/cs/run/medium144_ss_b1_cap8192_logss1/20260925_045942/ (summary.csv, 요청별 105행) |
갱신 블록 · 요약 (펼치기)
정지 (105/144) · 갱신 2026-09-25 15:24:45 KST · 시작 105 / 144 · 완료 105 · 실패 0
| set | n | Σ e2e s | Σ TTFT s | Σ decode s | Σ out tok | Σout/Σe2e tok/s | TTFT 평균/중앙 s | TPOT 평균/중앙 ms | out 중앙 | cap 도달 | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 완료 105 | 105 | 10,223.0 | 5,988.0 | 4,235.0 | 310,566 | 30.38 | 57.03 / 53.38 | 13.75 / 13.57 | 2,141 | 10 |
| 완료 105 | Σ out tok | Σout/Σe2e | TTFT 평균/중앙 | TPOT 평균/중앙 | out 중앙 | cap 도달 | |
|---|---|---|---|---|---|---|---|
| 3.4.4.1 | 105 | 310,566 | 30.38 tok/s | 57.03 / 53.38 s | 13.75 / 13.57 ms | 2,141 | 10 |
SparseSpec 재측정 · temperature 0 (greedy) · chunk 1024 · YaRN 끔 · 출력 상한 8,192 · LOG_SS=1 · 문서 20개 (측정 16 + warm-up 4) · 완료.
| 항목 | 값 | |
|---|---|---|
| 3.5.2.1 | 모델 · 엔진 | Qwen3-30B-A3B-Thinking-2507 base bf16 · SparseSpec 8246fb6 · kv_cache pillar · admit_policy offloading · async_cpu · cuda_graph · mem_fraction 0.85 |
| 3.5.2.2 | sampling · spec | temperature 0 → is_greedy_sampling(argmax) · seed 0 · spec_stride 7 · budget_ratio 0.05 · num_min_budget 128 · chunk 1024 |
| 3.5.2.3 | 환경변수 | LOG_SS=1 · SSPEC_REQ_TIMING=1 · SSPEC_CPU_CAP_MULT=1 · SSPEC_MAX_DRAFT_KV=262144 · SSPEC_MAX_SELECTED_KV=16384 · SSPEC_MAX_VERIFY_KV=524288 · SSPEC_FIXED_OUTPUT=8192 |
| 3.5.2.4 | 문서 · 분배 | 측정 16개 146,609~205,995 tok (긴 것과 짧은 것을 짝지어 GPU 당 2개) · warm-up 4개 128,996~143,804 tok (GPU 0~3, 4~7 재사용) |
| 3.5.2.5 | 실행 | GPU 당 프로세스 1개 · batch 1 · warm-up 1 → 측정 2 순차 · clip_length = 최장 prompt + 8,192 · core 24g~24g+23 |
| 3.5.2.6 | 결과 | /mnt/filesystem-p1/cs/run/ss20_temp0_c1024/20260925_070231/ (shards.json, per_request.csv) · 재현 판 ss20_temp0_c1024_rep2/20260925_072725/ (compare_vs_rep1.csv) |
| 측정 16/16 | Σ out tok | Σout/Σe2e | TTFT 평균/중앙 | TPOT 평균/중앙 | out 중앙 | cap 도달 | |
|---|---|---|---|---|---|---|---|
| 3.5.3.1 | 16 | 93,790 | 38.68 tok/s | 73.41 / 71.28 s | 13.50 / 13.59 ms | 8,192 | 9 |
- 기(상황) temperature 0 재현성: 같은 문서·GPU 배정·설정으로 한 번 더 돌려 요청별 출력 token id 전체를 비교했다 (재판 8 GPU 모두
EXIT=0) - 승(증상) 24개 중 23개 전체 일치 (측정 16개 중 15개). GPU 7
670bf1c4(167,246 tok) 만 1,498번째 token 에서 갈림 —… So the뒤가correct/cause - 전(원인) 미규명.
LOG_SS=1이라 logit 은 남지 않았다. 최종 답은 둘 다 (C), 출력 길이 1,956 / 1,855 - 결(조치) 요청별 비교표는
compare_vs_rep1.csv, 축약 전 원문 3.5
재현성 확인 · 갱신 2026-09-25 16:40:53 KST · 재판 종료 GPU 8 / 8 · token 비교 완료 24 / 24 요청 → 전부 같음 23 (측정 15 / 16)
출력 token 분포 (실시간) — 아래 접힌 요청별 표를 읽어 그린다.
요청별 표 24행 (펼치기)
완료 · 갱신 2026-09-25 16:19:38 KST · 요청 24 / 24 처리 · 종료 GPU 8 / 8
| idx | doc id | role | 상태 | temperature | GPU | 순서 | prompt tok | out tok | TTFT s | TPOT ms | E2E s | TPS | 종료 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 67246413bb02136c067d7374 | measured | 완료 | 0 | 0 | 2/3 | 205,995 | 8,192 | 100.92 | 14.06 | 216.1 | 37.91 | cap | |
| 1 | 66f3a311821e116aacb2de19 | measured | 완료 | 0 | 1 | 2/3 | 201,852 | 2,350 | 98.56 | 14.34 | 132.3 | 17.77 | eos | |
| 2 | 670cf52abb02136c067d2728 | measured | 완료 | 0 | 2 | 2/3 | 193,962 | 8,192 | 89.41 | 13.89 | 203.2 | 40.31 | cap | |
| 3 | 670bffa2bb02136c067d23b5 | measured | 완료 | 0 | 3 | 2/3 | 193,670 | 8,192 | 89.37 | 13.90 | 203.2 | 40.32 | cap | |
| 4 | 6724c83fbb02136c067d7962 | measured | 완료 | 0 | 4 | 2/3 | 190,025 | 2,549 | 86.42 | 14.19 | 122.6 | 20.80 | eos | |
| 5 | 670bf6ddbb02136c067d2379 | measured | 완료 | 0 | 5 | 2/3 | 181,792 | 8,192 | 78.73 | 13.45 | 188.9 | 43.37 | cap | |
| 6 | 66ec2755821e116aacb1b6f2 | measured | 완료 | 0 | 6 | 2/3 | 177,620 | 8,192 | 75.42 | 13.37 | 185.0 | 44.29 | cap | |
| 7 | 67246903bb02136c067d74f2 | measured | 완료 | 0 | 7 | 2/3 | 176,979 | 1,893 | 75.19 | 14.10 | 101.9 | 18.58 | eos | |
| 8 | 670bf1c4bb02136c067d2341 | measured | 완료 | 0 | 7 | 3/3 | 167,246 | 1,956 | 67.38 | 14.12 | 95.0 | 20.59 | eos | |
| 9 | 67246a00bb02136c067d759f | measured | 완료 | 0 | 6 | 3/3 | 162,716 | 3,995 | 64.28 | 13.23 | 117.1 | 34.11 | eos | |
| 10 | 6725e351bb02136c067d8758 | measured | 완료 | 0 | 5 | 3/3 | 158,191 | 8,192 | 61.41 | 12.95 | 167.4 | 48.92 | cap | |
| 11 | 67286698bb02136c067d9223 | measured | 완료 | 0 | 4 | 3/3 | 157,394 | 1,423 | 61.72 | 13.73 | 81.3 | 17.51 | eos | |
| 12 | 6725d898bb02136c067d82d6 | measured | 완료 | 0 | 3 | 3/3 | 157,232 | 5,896 | 61.71 | 13.09 | 138.8 | 42.46 | eos | |
| 13 | 67039cfabb02136c067cd04e | measured | 완료 | 0 | 2 | 3/3 | 151,861 | 8,192 | 56.66 | 12.46 | 158.7 | 51.60 | cap | |
| 14 | 672464aebb02136c067d73e6 | measured | 완료 | 0 | 1 | 3/3 | 148,495 | 8,192 | 54.60 | 12.64 | 158.2 | 51.79 | cap | |
| 15 | 66f95e11bb02136c067c5370 | measured | 완료 | 0 | 0 | 3/3 | 146,609 | 8,192 | 52.81 | 12.53 | 155.5 | 52.70 | cap | |
| 16 | 672494e5bb02136c067d7697 | warmup | 완료 | 0 | 0 | 1/3 | 143,804 | 3,494 | 53.82 | 12.72 | 98.2 | 35.57 | eos | |
| 16 | 672494e5bb02136c067d7697 | warmup | 완료 | 0 | 4 | 1/3 | 143,804 | 3,494 | 53.48 | 12.65 | 97.7 | 35.77 | eos | |
| 17 | 6723a0a7bb02136c067d7040 | warmup | 완료 | 0 | 1 | 1/3 | 141,416 | 8,192 | 52.46 | 12.30 | 153.3 | 53.45 | cap | |
| 17 | 6723a0a7bb02136c067d7040 | warmup | 완료 | 0 | 5 | 1/3 | 141,416 | 8,192 | 52.16 | 12.32 | 153.1 | 53.52 | cap | |
| 18 | 670aac92bb02136c067d218a | warmup | 완료 | 0 | 2 | 1/3 | 138,801 | 8,192 | 49.80 | 12.26 | 150.2 | 54.53 | cap | |
| 18 | 670aac92bb02136c067d218a | warmup | 완료 | 0 | 6 | 1/3 | 138,801 | 8,192 | 49.79 | 12.28 | 150.4 | 54.46 | cap | |
| 19 | 6725d977bb02136c067d8373 | warmup | 완료 | 0 | 3 | 1/3 | 128,996 | 356 | 45.02 | 14.18 | 50.1 | 7.11 | eos | |
| 19 | 6725d977bb02136c067d8373 | warmup | 완료 | 0 | 7 | 1/3 | 128,996 | 356 | 44.92 | 14.14 | 49.9 | 7.13 | eos |
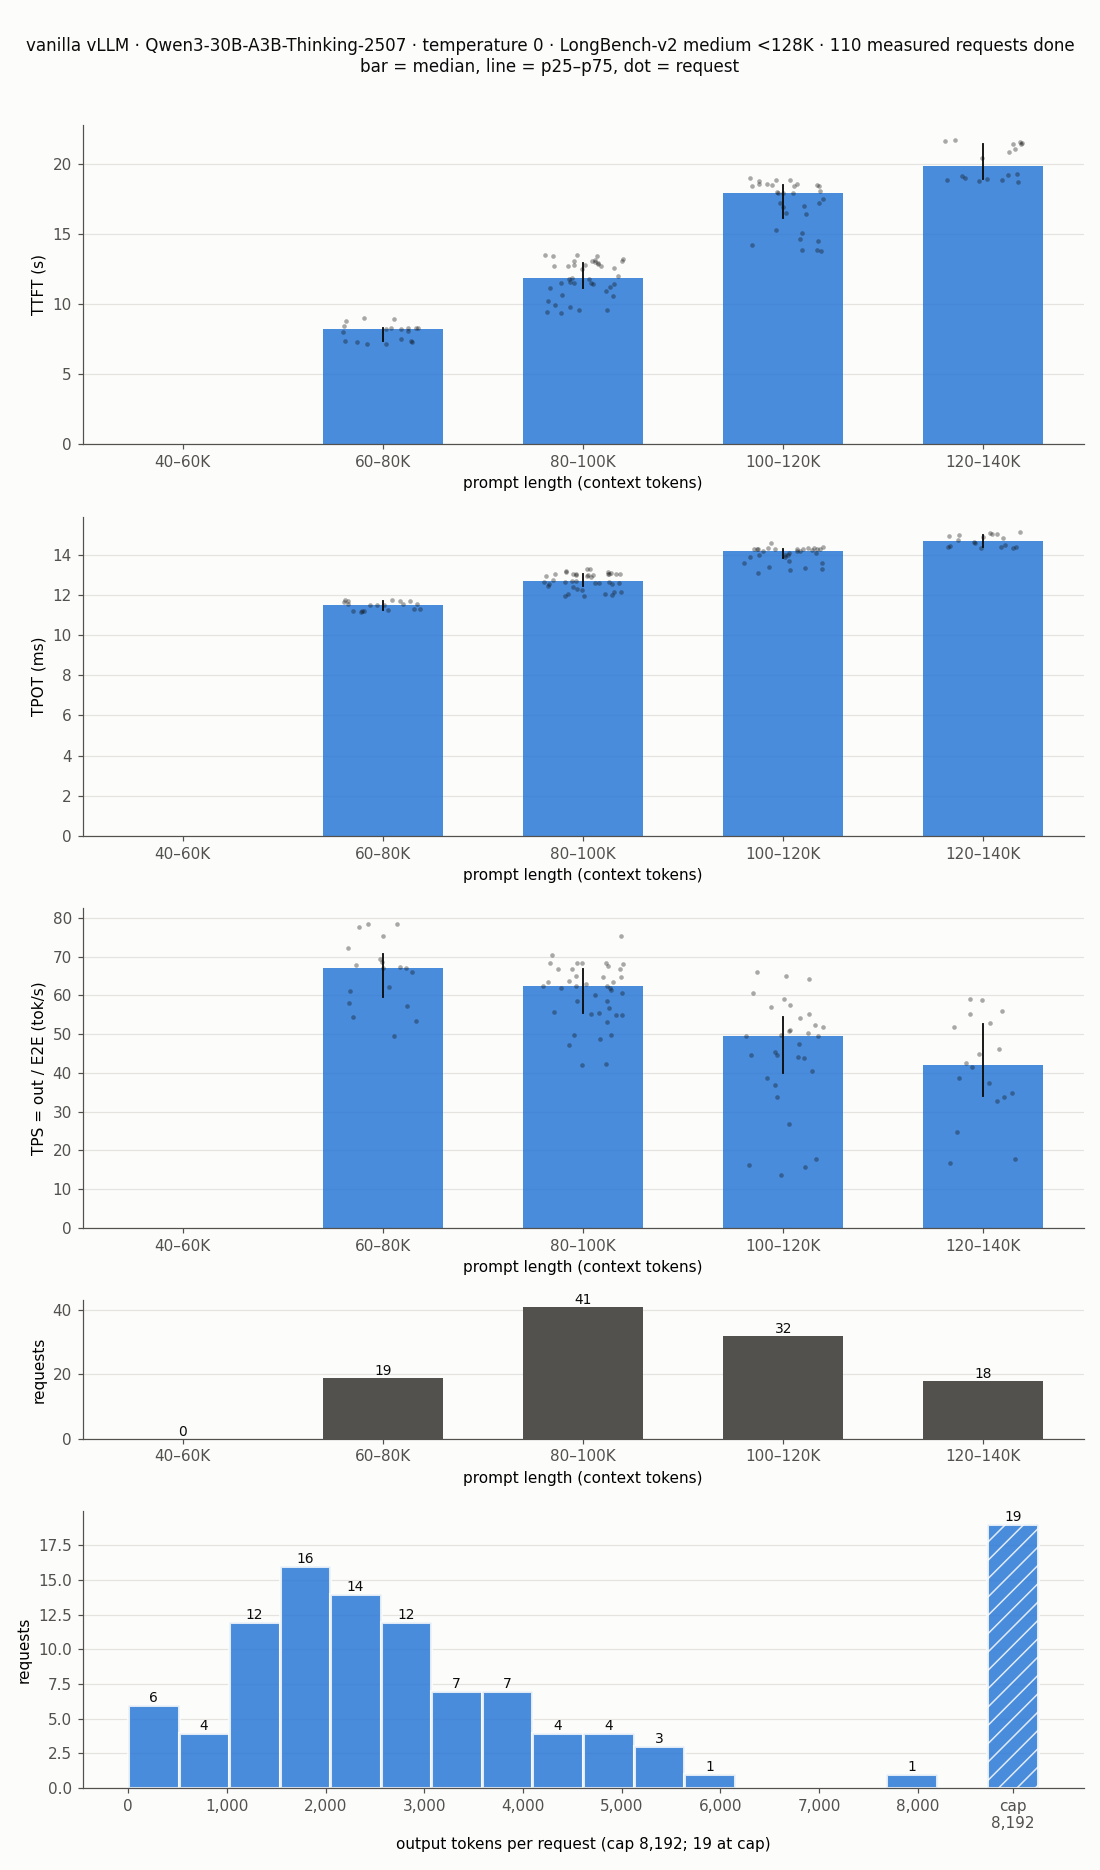
vanilla vLLM · Qwen3-30B-A3B-Thinking-2507 · temperature 0 · 출력 상한 8,192 · LongBench-v2 medium 라벨 128K 미만 126개 (42K~130K) · GPU 8장 · 완료. 계획서 Medium 구간(170K~194K)이 아니다.
| 항목 | 값 | |
|---|---|---|
| 3.6.2.1 | 엔진 | CompressSpec 서브모듈 vLLM 0.14.1.dev236 (RULER_MODE=vanilla, 압축 경로 없음), env draft, FLASHINFER |
| 3.6.2.2 | 모델 | Qwen3-30B-A3B-Thinking-2507 base (YaRN 없음, max_model_len 262,144), bf16, block 32 |
| 3.6.2.3 | 문서 · 분배 | length=medium · prompt < 131,072 tok · 126개. warm-up = 가장 짧은 16개 GPU 당 2개, 측정 110개 (GPU 간 prompt 합 1.33M~1.40M 균등) |
| 3.6.2.4 | sampling · 생성 | temperature=0 (EXP_TEMP=0 확인) · seed 0 · 자연 EOS · 상한 8,192 · prefix caching 끔 · chunked prefill 기본(16,384) |
| 3.6.2.5 | 계측 | RequestOutput.metrics. TTFT = first_token_ts − scheduled_ts · TPOT = (last − first)/(out − 1) · E2E = 요청 wall |
| 3.6.2.6 | 결과 | /mnt/filesystem-p1/cs/run/vanilla126_temp0_cap8192/20260925_061459/ (per_request.csv, totals.csv) |
| set | n | Σ out tok | Σout/Σe2e | TTFT 평균/중앙 | TPOT 평균/중앙 | out 중앙 | cap 도달 | |
|---|---|---|---|---|---|---|---|---|
| 3.6.3.1 | measured | 110 | 388,833 | 57.81 tok/s | 14.05 / 13.15 s | 13.18 / 13.08 ms | 2,633 | 19 |
| 3.6.3.2 | warm-up (제외) | 16 | 48,513 | 41.40 tok/s | 5.01 / 4.77 s | 10.33 / 10.25 ms | 2,257 | 1 |
출력 token 분포 (실시간) — 아래 접힌 요청별 표를 읽어 그린다.
요청별 표 126행 (펼치기)
완료 (2026-09-25 15:36 KST, 8 GPU 모두 EXIT=0) · 갱신 2026-09-25 15:47:19 KST · 완료 126 / 126 (측정 110 / 110, warm-up 16 / 16)
| idx | doc id | role | temperature | prompt tok | GPU | out tok | TTFT s | TPOT ms | E2E s | TPS | 종료 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 66f568dc821e116aacb33995 | measured | 0 | 130,293 | 0 | 1,516 | 21.60 | 15.00 | 44.8 | 33.86 | stop | |
| 1 | 6725da56bb02136c067d841b | measured | 0 | 129,022 | 1 | 2,993 | 21.39 | 14.96 | 66.6 | 44.93 | stop | |
| 2 | 6725d92bbb02136c067d833c | measured | 0 | 129,012 | 2 | 5,631 | 21.45 | 15.05 | 106.6 | 52.83 | stop | |
| 3 | 6725d977bb02136c067d8373 | measured | 0 | 128,996 | 3 | 5,183 | 21.54 | 15.03 | 99.8 | 51.92 | stop | |
| 4 | 6725dda1bb02136c067d8654 | measured | 0 | 128,994 | 4 | 8,192 | 21.69 | 15.13 | 146.0 | 56.10 | cap | |
| 5 | 66fad00bbb02136c067c76ce | measured | 0 | 128,725 | 5 | 2,559 | 21.41 | 14.93 | 60.0 | 42.63 | stop | |
| 6 | 66f4f87b821e116aacb31d62 | measured | 0 | 127,669 | 6 | 1,949 | 21.01 | 14.86 | 50.4 | 38.66 | stop | |
| 7 | 66ec4e43821e116aacb1cb54 | measured | 0 | 127,011 | 7 | 1,525 | 20.86 | 14.80 | 43.8 | 34.80 | stop | |
| 8 | 6719dc46bb02136c067d470b | measured | 0 | 125,493 | 7 | 1,725 | 20.39 | 14.70 | 46.1 | 37.39 | stop | |
| 9 | 6723a770bb02136c067d7233 | measured | 0 | 121,332 | 6 | 8,192 | 19.14 | 14.65 | 139.5 | 58.71 | cap | |
| 10 | 67192e81bb02136c067d427f | measured | 0 | 121,232 | 5 | 467 | 19.20 | 14.38 | 26.3 | 17.73 | stop | |
| 11 | 6719185cbb02136c067d40ab | measured | 0 | 120,902 | 4 | 434 | 19.25 | 14.37 | 25.9 | 16.76 | stop | |
| 12 | 671b2e2dbb02136c067d515b | measured | 0 | 120,671 | 3 | 2,696 | 19.00 | 14.43 | 58.3 | 46.24 | stop | |
| 13 | 672468b1bb02136c067d74bd | measured | 0 | 120,361 | 2 | 8,192 | 18.88 | 14.58 | 138.7 | 59.07 | cap | |
| 14 | 6719167dbb02136c067d4025 | measured | 0 | 120,186 | 1 | 734 | 18.79 | 14.33 | 29.7 | 24.71 | stop | |
| 15 | 6718a43fbb02136c067d3ca8 | measured | 0 | 120,136 | 0 | 1,176 | 18.71 | 14.34 | 36.0 | 32.64 | stop | |
| 16 | 671b99e5bb02136c067d583d | measured | 0 | 120,076 | 6 | 1,990 | 18.84 | 14.37 | 47.8 | 41.60 | stop | |
| 17 | 671b5d49bb02136c067d55fb | measured | 0 | 120,031 | 1 | 5,285 | 18.82 | 14.47 | 95.7 | 55.25 | stop | |
| 18 | 671b2822bb02136c067d5020 | measured | 0 | 119,968 | 2 | 8,192 | 18.85 | 14.56 | 138.5 | 59.15 | cap | |
| 19 | 67189156bb02136c067d3b8d | measured | 0 | 119,807 | 3 | 2,281 | 18.80 | 14.36 | 51.9 | 43.91 | stop | |
| 20 | 671b58e8bb02136c067d5525 | measured | 0 | 119,787 | 4 | 464 | 18.95 | 14.30 | 26.0 | 17.85 | stop | |
| 21 | 67192057bb02136c067d41b4 | measured | 0 | 119,563 | 5 | 324 | 18.82 | 14.29 | 23.9 | 13.59 | stop | |
| 22 | 66ed23ce821e116aacb1ee84 | measured | 0 | 119,453 | 0 | 1,808 | 18.55 | 14.33 | 44.7 | 40.42 | stop | |
| 23 | 66ef8aa3821e116aacb22db5 | measured | 0 | 119,150 | 7 | 2,820 | 18.51 | 14.34 | 59.3 | 47.55 | stop | |
| 24 | 6719ef50bb02136c067d4911 | measured | 0 | 118,992 | 6 | 1,632 | 18.51 | 14.30 | 42.2 | 38.64 | stop | |
| 25 | 6719d65ebb02136c067d45dc | measured | 0 | 118,918 | 1 | 376 | 18.38 | 14.27 | 24.1 | 15.60 | stop | |
| 26 | 67191791bb02136c067d406c | measured | 0 | 118,801 | 2 | 814 | 18.45 | 14.26 | 30.5 | 26.73 | stop | |
| 27 | 6703bed0bb02136c067cd381 | measured | 0 | 118,350 | 3 | 2,310 | 18.43 | 14.28 | 51.8 | 44.61 | stop | |
| 28 | 66ebd3ba5a08c7b9b35e0446 | measured | 0 | 117,922 | 5 | 2,403 | 18.41 | 14.24 | 53.0 | 45.35 | stop | |
| 29 | 671a4444bb02136c067d4a40 | measured | 0 | 117,774 | 4 | 401 | 18.50 | 14.18 | 24.6 | 16.32 | stop | |
| 30 | 671b56cfbb02136c067d54e9 | measured | 0 | 117,521 | 0 | 3,116 | 17.93 | 14.25 | 62.7 | 49.67 | stop | |
| 31 | 6719c1febb02136c067d44db | measured | 0 | 117,341 | 7 | 1,196 | 18.03 | 14.17 | 35.4 | 33.83 | stop | |
| 32 | 671b530dbb02136c067d5454 | measured | 0 | 117,145 | 0 | 2,212 | 17.88 | 14.20 | 49.7 | 44.53 | stop | |
| 33 | 66f3c219821e116aacb2eb4e | measured | 0 | 116,387 | 5 | 5,805 | 17.97 | 14.25 | 101.1 | 57.43 | stop | |
| 34 | 66f016e6821e116aacb25497 | measured | 0 | 115,490 | 4 | 8,192 | 17.90 | 14.27 | 135.1 | 60.63 | cap | |
| 35 | 66f3d10b821e116aacb2f14f | measured | 0 | 115,088 | 3 | 2,899 | 17.50 | 14.08 | 58.7 | 49.41 | stop | |
| 36 | 66f26c5f821e116aacb2907c | measured | 0 | 114,302 | 6 | 2,016 | 17.20 | 14.00 | 45.8 | 44.04 | stop | |
| 37 | 66eb873c5a08c7b9b35dd849 | measured | 0 | 114,165 | 2 | 4,327 | 17.21 | 14.06 | 78.4 | 55.22 | stop | |
| 38 | 670646aebb02136c067cf85a | measured | 0 | 113,605 | 1 | 3,389 | 16.98 | 13.99 | 64.7 | 52.35 | stop | |
| 39 | 66f17aab821e116aacb2772d | measured | 0 | 113,319 | 7 | 3,063 | 16.89 | 13.96 | 60.0 | 51.05 | stop | |
| 40 | 66ed4274821e116aacb1f8f1 | measured | 0 | 111,985 | 1 | 2,653 | 16.51 | 13.86 | 53.6 | 49.51 | stop | |
| 41 | 66f2b5ec821e116aacb2b1ec | measured | 0 | 111,472 | 2 | 3,673 | 16.42 | 13.87 | 67.7 | 54.29 | stop | |
| 42 | 66ebdfb65a08c7b9b35e140a | measured | 0 | 107,137 | 7 | 2,536 | 15.25 | 13.57 | 50.0 | 50.76 | stop | |
| 43 | 670c090bbb02136c067d2404 | measured | 0 | 106,334 | 6 | 8,192 | 15.08 | 13.69 | 127.6 | 64.19 | cap | |
| 44 | 66ed1734821e116aacb1ead5 | measured | 0 | 104,304 | 3 | 8,192 | 14.61 | 13.56 | 126.1 | 64.99 | cap | |
| 45 | 66f3cca6821e116aacb2ef7c | measured | 0 | 103,346 | 4 | 2,255 | 14.45 | 13.31 | 44.8 | 50.31 | stop | |
| 46 | 66ec2df6821e116aacb1bb7b | measured | 0 | 102,746 | 5 | 2,417 | 14.21 | 13.27 | 46.6 | 51.84 | stop | |
| 47 | 66f2b11c821e116aacb2aeb6 | measured | 0 | 101,648 | 0 | 3,285 | 13.84 | 13.23 | 57.6 | 57.07 | stop | |
| 48 | 66ec542b821e116aacb1cc87 | measured | 0 | 101,600 | 0 | 8,192 | 13.82 | 13.39 | 123.8 | 66.14 | cap | |
| 49 | 66fa700bbb02136c067c6c06 | measured | 0 | 100,306 | 4 | 1,001 | 13.75 | 13.07 | 27.2 | 36.86 | stop | |
| 50 | 670fb882bb02136c067d2c1d | measured | 0 | 99,526 | 5 | 4,163 | 13.46 | 13.12 | 68.6 | 60.71 | stop | |
| 51 | 670fb8dfbb02136c067d2c48 | measured | 0 | 99,526 | 3 | 8,192 | 13.48 | 13.26 | 122.4 | 66.93 | cap | |
| 52 | 670fbb1fbb02136c067d2ca4 | measured | 0 | 99,525 | 6 | 8,192 | 13.42 | 13.26 | 122.4 | 66.92 | cap | |
| 53 | 670fbae0bb02136c067d2c79 | measured | 0 | 99,514 | 7 | 4,726 | 13.40 | 13.14 | 75.8 | 62.34 | stop | |
| 54 | 66ec31eb821e116aacb1bf28 | measured | 0 | 98,665 | 1 | 1,249 | 13.12 | 12.97 | 29.6 | 42.14 | stop | |
| 55 | 66f3cb88821e116aacb2eeb9 | measured | 0 | 98,167 | 2 | 8,192 | 13.05 | 13.17 | 121.2 | 67.57 | cap | |
| 56 | 6725dcb2bb02136c067d85b7 | measured | 0 | 98,136 | 5 | 2,603 | 13.06 | 12.98 | 47.2 | 55.19 | stop | |
| 57 | 6725dd39bb02136c067d861b | measured | 0 | 98,059 | 4 | 3,725 | 13.18 | 13.01 | 62.0 | 60.10 | stop | |
| 58 | 6725dc6abb02136c067d8586 | measured | 0 | 98,054 | 3 | 2,552 | 13.04 | 12.98 | 46.5 | 54.92 | stop | |
| 59 | 67286533bb02136c067d919f | measured | 0 | 97,958 | 0 | 4,906 | 12.87 | 13.05 | 77.2 | 63.55 | stop | |
| 60 | 672864b4bb02136c067d916c | measured | 0 | 97,928 | 6 | 4,238 | 12.99 | 13.03 | 68.5 | 61.85 | stop | |
| 61 | 6725dc28bb02136c067d8555 | measured | 0 | 97,767 | 7 | 1,857 | 12.94 | 12.93 | 37.3 | 49.80 | stop | |
| 62 | 66f2a7a9821e116aacb2a721 | measured | 0 | 97,288 | 2 | 1,581 | 12.80 | 12.89 | 33.4 | 47.32 | stop | |
| 63 | 67286ab8bb02136c067d92e4 | measured | 0 | 96,856 | 1 | 8,192 | 12.68 | 13.08 | 120.2 | 68.17 | cap | |
| 64 | 66ec6582821e116aacb1cf7a | measured | 0 | 96,444 | 5 | 8,192 | 12.70 | 13.05 | 119.9 | 68.32 | cap | |
| 65 | 670fbf5abb02136c067d2d9c | measured | 0 | 96,360 | 4 | 8,192 | 12.78 | 13.05 | 120.0 | 68.28 | cap | |
| 66 | 670fbfa4bb02136c067d2dcb | measured | 0 | 96,355 | 3 | 8,192 | 12.67 | 13.05 | 119.9 | 68.33 | cap | |
| 67 | 670fbbd0bb02136c067d2d04 | measured | 0 | 96,350 | 0 | 4,556 | 12.52 | 12.93 | 71.7 | 63.51 | stop | |
| 68 | 670fbb78bb02136c067d2cd3 | measured | 0 | 96,330 | 6 | 8,192 | 12.59 | 13.05 | 119.8 | 68.38 | cap | |
| 69 | 66ed211f821e116aacb1ee0d | measured | 0 | 93,725 | 7 | 1,562 | 11.98 | 12.69 | 32.1 | 48.66 | stop | |
| 70 | 670cf163bb02136c067d26b6 | measured | 0 | 93,020 | 2 | 1,092 | 11.82 | 12.62 | 25.9 | 42.24 | stop | |
| 71 | 670cf1c0bb02136c067d26e5 | measured | 0 | 93,014 | 1 | 1,960 | 11.79 | 12.65 | 36.9 | 53.12 | stop | |
| 72 | 66f55ddb821e116aacb33761 | measured | 0 | 92,638 | 7 | 4,026 | 11.80 | 12.69 | 63.1 | 63.79 | stop | |
| 73 | 6725dbd1bb02136c067d8522 | measured | 0 | 91,401 | 5 | 2,580 | 11.51 | 12.54 | 44.1 | 58.44 | stop | |
| 74 | 67286795bb02136c067d92ab | measured | 0 | 91,384 | 4 | 3,291 | 11.59 | 12.57 | 53.2 | 61.84 | stop | |
| 75 | 6725dabfbb02136c067d8450 | measured | 0 | 91,383 | 3 | 5,081 | 11.52 | 12.64 | 75.9 | 66.92 | stop | |
| 76 | 6725db8bbb02136c067d84eb | measured | 0 | 91,375 | 0 | 3,393 | 11.39 | 12.58 | 54.4 | 62.42 | stop | |
| 77 | 6725db46bb02136c067d84b4 | measured | 0 | 91,371 | 2 | 3,508 | 11.47 | 12.58 | 55.8 | 62.84 | stop | |
| 78 | 6725db01bb02136c067d847f | measured | 0 | 91,368 | 1 | 7,840 | 11.44 | 12.72 | 111.4 | 70.35 | stop | |
| 79 | 66f8d4b3bb02136c067c45c2 | measured | 0 | 90,040 | 6 | 3,940 | 11.14 | 12.51 | 60.7 | 64.95 | stop | |
| 80 | 66f793f4bb02136c067c306e | measured | 0 | 89,491 | 5 | 3,175 | 11.18 | 12.43 | 50.9 | 62.34 | stop | |
| 81 | 66f19f04821e116aacb27bab | measured | 0 | 88,661 | 4 | 3,650 | 10.94 | 12.40 | 56.5 | 64.64 | stop | |
| 82 | 66ec4370821e116aacb1c905 | measured | 0 | 87,204 | 6 | 2,723 | 10.65 | 12.29 | 44.3 | 61.47 | stop | |
| 83 | 66efa5ea821e116aacb23268 | measured | 0 | 86,900 | 3 | 1,888 | 10.57 | 12.24 | 33.9 | 55.70 | stop | |
| 84 | 66f920d8bb02136c067c4b81 | measured | 0 | 85,321 | 7 | 1,766 | 10.20 | 12.14 | 31.9 | 55.34 | stop | |
| 85 | 66ec3aff821e116aacb1c52e | measured | 0 | 83,854 | 0 | 1,820 | 9.80 | 12.05 | 32.0 | 56.84 | stop | |
| 86 | 66ed364d821e116aacb1f47e | measured | 0 | 83,823 | 2 | 1,640 | 9.94 | 12.04 | 29.9 | 54.84 | stop | |
| 87 | 66fd4f54bb02136c067c9987 | measured | 0 | 82,588 | 1 | 1,211 | 9.56 | 11.95 | 24.3 | 49.87 | stop | |
| 88 | 66fa9ff6bb02136c067c71e0 | measured | 0 | 82,549 | 1 | 1,917 | 9.57 | 11.97 | 32.8 | 58.49 | stop | |
| 89 | 66f3fb15821e116aacb303dc | measured | 0 | 81,805 | 0 | 8,192 | 9.32 | 12.12 | 108.9 | 75.24 | cap | |
| 90 | 66ebd0ea5a08c7b9b35dff57 | measured | 0 | 81,534 | 2 | 2,736 | 9.41 | 11.93 | 42.3 | 64.68 | stop | |
| 91 | 66ec3352821e116aacb1c085 | measured | 0 | 79,482 | 7 | 1,319 | 8.96 | 11.75 | 24.7 | 53.40 | stop | |
| 92 | 66f3d738821e116aacb2f446 | measured | 0 | 79,328 | 3 | 1,390 | 8.98 | 11.74 | 25.5 | 54.51 | stop | |
| 93 | 66f379e8821e116aacb2d161 | measured | 0 | 78,631 | 6 | 1,633 | 8.80 | 11.71 | 28.1 | 58.11 | stop | |
| 94 | 66f3c806821e116aacb2ed77 | measured | 0 | 76,606 | 4 | 3,906 | 8.45 | 11.64 | 54.2 | 72.12 | stop | |
| 95 | 66ef1a4d821e116aacb229d5 | measured | 0 | 75,764 | 5 | 2,348 | 8.25 | 11.54 | 35.6 | 66.01 | stop | |
| 96 | 66f4cd2c821e116aacb316ef | measured | 0 | 75,728 | 5 | 979 | 8.25 | 11.49 | 19.7 | 49.64 | stop | |
| 97 | 670fb813bb02136c067d2bec | measured | 0 | 75,368 | 4 | 2,486 | 8.25 | 11.52 | 37.1 | 66.99 | stop | |
| 98 | 670fbd96bb02136c067d2d49 | measured | 0 | 75,366 | 7 | 2,613 | 8.21 | 11.52 | 38.6 | 67.74 | stop | |
| 99 | 670fb6a3bb02136c067d2b94 | measured | 0 | 75,351 | 6 | 8,192 | 8.21 | 11.71 | 104.4 | 78.50 | cap | |
| 100 | 670fb637bb02136c067d2b65 | measured | 0 | 75,349 | 3 | 8,192 | 8.26 | 11.70 | 104.4 | 78.50 | cap | |
| 101 | 66efaf70821e116aacb234bd | measured | 0 | 74,951 | 1 | 2,474 | 8.05 | 11.49 | 36.7 | 67.36 | stop | |
| 102 | 66f8c783bb02136c067c44b8 | measured | 0 | 74,474 | 2 | 2,795 | 7.98 | 11.47 | 40.3 | 69.42 | stop | |
| 103 | 66faa8efbb02136c067c7357 | measured | 0 | 70,998 | 0 | 3,833 | 7.34 | 11.29 | 50.8 | 75.45 | stop | |
| 104 | 66fc05b6bb02136c067c88e4 | measured | 0 | 70,982 | 0 | 2,049 | 7.34 | 11.23 | 30.6 | 67.05 | stop | |
| 105 | 66f950acbb02136c067c5021 | measured | 0 | 70,875 | 4 | 1,498 | 7.48 | 11.21 | 24.5 | 61.22 | stop | |
| 106 | 66f590fa821e116aacb33f35 | measured | 0 | 70,269 | 5 | 1,521 | 7.29 | 11.17 | 24.5 | 62.18 | stop | |
| 107 | 66ecfe1e821e116aacb1e41c | measured | 0 | 70,261 | 7 | 4,713 | 7.29 | 11.27 | 60.6 | 77.72 | stop | |
| 108 | 66ebc3165a08c7b9b35deb38 | measured | 0 | 69,798 | 2 | 1,168 | 7.16 | 11.14 | 20.4 | 57.38 | stop | |
| 109 | 66ebd2975a08c7b9b35e01e3 | measured | 0 | 69,796 | 6 | 2,166 | 7.15 | 11.17 | 31.5 | 68.73 | stop | |
| 110 | 66f56630821e116aacb3392b | warmup | 0 | 68,230 | 0 | 5,369 | 6.80 | 11.17 | 95.2 | 56.40 | stop | |
| 111 | 66ec0c4c821e116aacb1994a | warmup | 0 | 67,332 | 0 | 1,954 | 6.72 | 10.99 | 95.2 | 20.53 | stop | |
| 112 | 66f3cfa5821e116aacb2f096 | warmup | 0 | 65,882 | 1 | 2,237 | 6.43 | 10.93 | 61.4 | 36.42 | stop | |
| 113 | 66ed875e821e116aacb2023e | warmup | 0 | 62,782 | 1 | 2,278 | 5.93 | 10.70 | 61.4 | 37.09 | stop | |
| 114 | 66ec1aef821e116aacb1aa1a | warmup | 0 | 62,446 | 2 | 1,790 | 5.84 | 10.66 | 77.2 | 23.19 | stop | |
| 115 | 66f118e1821e116aacb26b79 | warmup | 0 | 60,942 | 2 | 4,360 | 5.64 | 10.64 | 77.2 | 56.49 | stop | |
| 116 | 66fe81dcbb02136c067ca2de | warmup | 0 | 55,854 | 3 | 1,666 | 4.87 | 10.27 | 112.0 | 14.87 | stop | |
| 117 | 66ec332a821e116aacb1c042 | warmup | 0 | 55,051 | 3 | 8,192 | 4.77 | 10.39 | 112.0 | 73.11 | cap | |
| 118 | 66f6b623bb02136c067c2646 | warmup | 0 | 55,049 | 4 | 3,083 | 4.77 | 10.24 | 52.6 | 58.63 | stop | |
| 119 | 66ece28e821e116aacb1db1f | warmup | 0 | 54,528 | 4 | 1,114 | 4.76 | 10.12 | 52.6 | 21.19 | stop | |
| 120 | 66f97d7fbb02136c067c56b2 | warmup | 0 | 53,550 | 5 | 3,645 | 4.53 | 10.17 | 65.7 | 55.44 | stop | |
| 121 | 66f4ce9e821e116aacb31731 | warmup | 0 | 53,003 | 5 | 1,932 | 4.53 | 10.05 | 65.7 | 29.39 | stop | |
| 122 | 66fba2bcbb02136c067c8112 | warmup | 0 | 50,708 | 6 | 3,746 | 4.21 | 10.02 | 78.2 | 47.88 | stop | |
| 123 | 670397b5bb02136c067ccec6 | warmup | 0 | 49,099 | 6 | 3,284 | 3.92 | 9.86 | 78.2 | 41.98 | stop | |
| 124 | 66f3e473821e116aacb2fa73 | warmup | 0 | 45,692 | 7 | 2,152 | 3.47 | 9.68 | 43.5 | 49.43 | stop | |
| 125 | 670493d4bb02136c067cdcd9 | warmup | 0 | 42,048 | 7 | 1,711 | 3.04 | 9.35 | 43.5 | 39.30 | stop |
Sweep
CompressSpec compaction 정책 스윕(Sweep Monitor)을 요약해 옮긴 것. 원본 페이지 전체(17 MB, 7탭·JS 그림)는 원본 보기 ↗ 에 그대로 있고, 사본은 dashboard_n01/sweep_monitor_src/job_9f4386c4_tmp/. 갱신은 2026-09-23 12:57 이후 없다(정적).
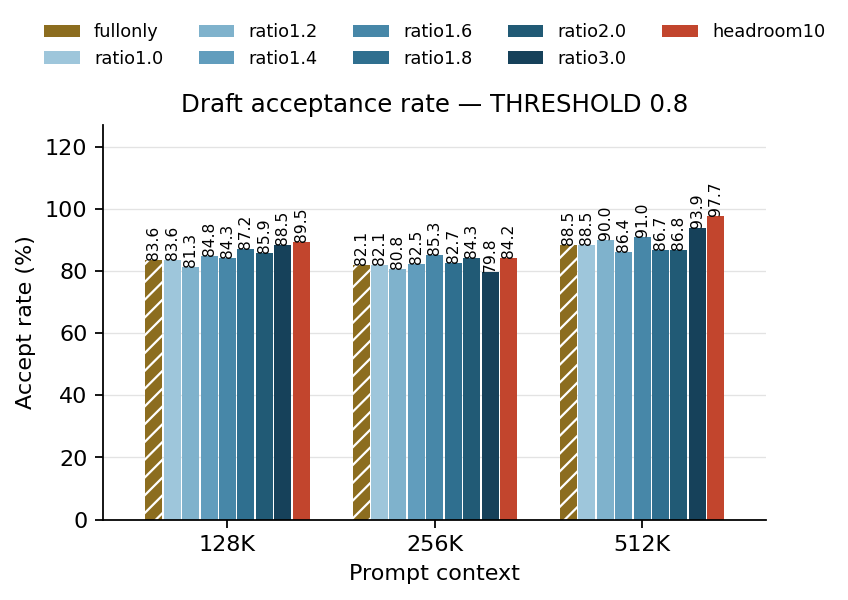
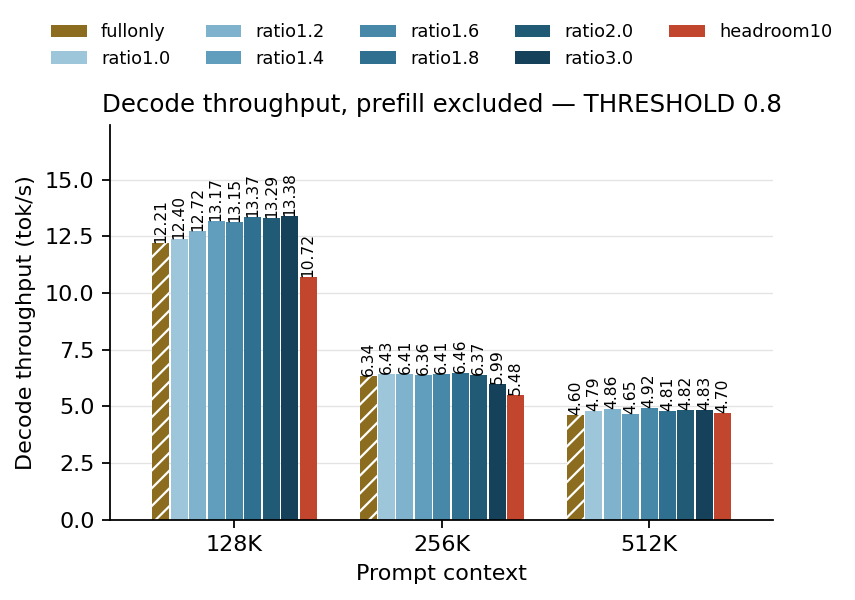
CompressSpec(GPU draft + CPU verify) · Qwen3-4B-Thinking-2507-yarn2.0 · LongBench-v2 · 128K·256K·420K · arm 9개 · COMPACT_THRESHOLD 0.8 · batch 1 · 요청 3개 · temp 0.8 / top_k 20 / top_p 0.95 / seed 0 · n82(256K) · n83(420K).
| 항목 | 값 | |
|---|---|---|
| 4.1.2.1 | arm | fullonly(diff off) · ratio1.0~3.0(diff on + 재압축 비율) · headroom10(풀이 찰 때 재압축) |
| 4.1.2.2 | 프롬프트 | 대역마다 원본이 그 길이에 가까운 문항. 256K 는 무절단, 128K·420K 는 본문만 잘라 질문·보기·형식 지시 보존 |
| 4.1.2.3 | 생성 상한 | 128K·256K 80,000 · 420K 70,000 (IGNORE_EOS=0) |
| 4.1.2.4 | KV | GPU_MEM_UTIL 0.85 → KV 582,528 token, num_gpu_blocks 3100, cpu_pool 80/200/450 GB |
| 4.1.2.5 | batch 1 인 이유 | 교착이 아니라 KV 용량. 420K 프롬프트 하나가 GPU KV 약 210,848 token 예산을 채운다 (가설 기각 기록은 4.6) |
완료 27셀 (THRESHOLD 0.8, 셀 = 대역 하나의 요청 3개 순차). fullonly 와 ratio1.0 은 정합이라 같은 값.
| ctx | fullonly | ratio1.0 | ratio1.2 | ratio1.4 | ratio1.6 | ratio1.8 | ratio2.0 | ratio3.0 | headroom10 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 4.1.4.1 | 128K accept % | 83.6 | 83.6 | 81.3 | 84.8 | 84.3 | 87.2 | 85.9 | 88.5 | 89.5 |
| 4.1.4.2 | 128K decode tok/s | 12.21 | 12.40 | 12.72 | 13.17 | 13.15 | 13.37 | 13.29 | 13.38 | 10.72 |
| 4.1.4.3 | 256K accept % | 82.1 | 82.1 | 80.8 | 82.5 | 85.3 | 82.7 | 84.3 | 79.8 | 84.2 |
| 4.1.4.4 | 256K decode tok/s | 6.34 | 6.43 | 6.41 | 6.36 | 6.41 | 6.46 | 6.37 | 5.99 | 5.48 |
| 4.1.4.5 | 420K accept % | 88.5 | 88.5 | 90.0 | 86.4 | 91.0 | 86.7 | 86.8 | 93.9 | 97.7 |
| 4.1.4.6 | 420K decode tok/s | 4.60 | 4.79 | 4.86 | 4.65 | 4.92 | 4.81 | 4.82 | 4.83 | 4.70 |
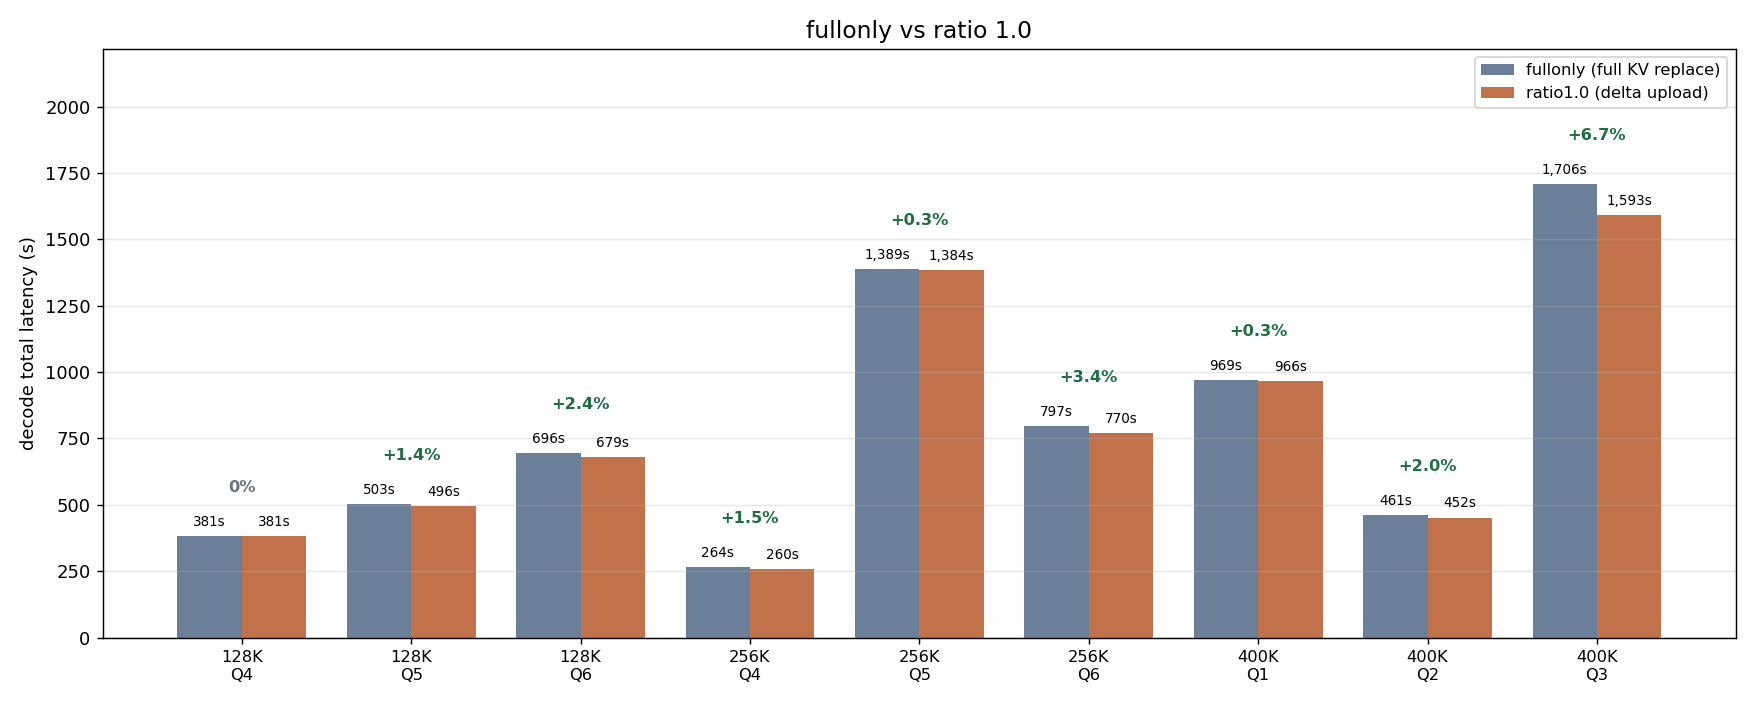
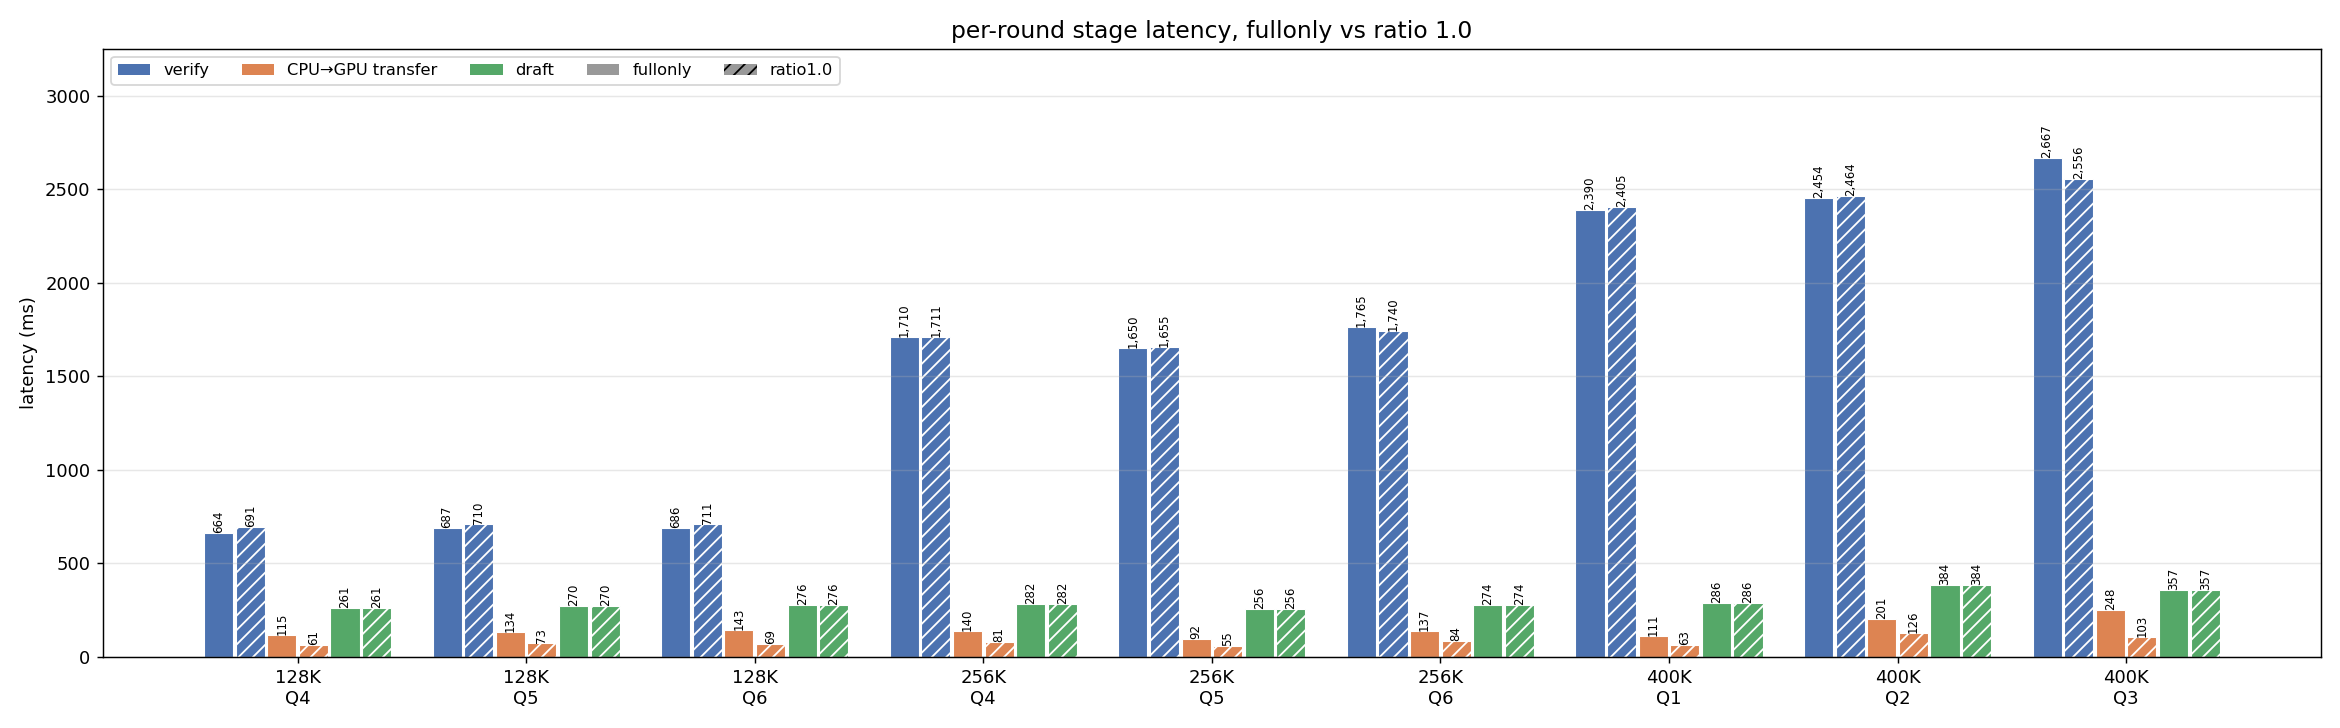
- 기(상황)
RCRATIO를 고정값이 아니라 그 자리에서 정하려면 delta 와 full 을 같은 자리에서 견줘야 한다 - 승(증상) 420K 는 keep 블록 순(829→1,195)이 accept 순(86.8→97.7%)과 일치. 256K 는 keep 폭이 52블록뿐이라 accept 이 흔들림(79.8~84.3%)
- 전(원인) accept 의 설명변수는 압축 비율이 아니라 절대 보존 블록 수의 log2(79벤치 13,983요청). 256K 에서 keep 비율이
ratio에 반응하지 않는 이유는 미규명(THRESHOLD 외의 선택 기준) - 결(조치) 비용 모델은 라운드당 비용 × 라운드 수(accept 함수)로 가른다. 변수 목록 원문은 원본 1.1 탭
09_rcratio_cost_variables.md
| 이미 아는 값 | 측정 | |
|---|---|---|
| 4.1.10.1 | reload | 블록당 약 0.19 ms. 512K NGB 3100·R1.5 → 5000·R3 에서 reload 중앙 0.330 → 0.118 s, decode −4.1% |
| 4.1.10.2 | delta 에만 붙는 CPU 비용 | 최적화 전 라운드당 약 186 ms → 후 28 ms (64K +32% → +8%, 128K +41% → +16%) |
| 4.1.10.3 | full-fallback | native layer_kv 48 → 124 ms. COMPACT_MAX_GPUBLK_UTIL 0.9 를 0 으로 끄면 512K accept 26.1 → 1.7% |
| 4.1.10.4 | GPU draft forward | 두 경로 1~6% 이내 동일. 모델에서 상쇄 |
| 4.1.10.5 | 모르는 값 | ratio → keep 전달 계수가 대역마다 다른 이유 · gather 커널 고정 오버헤드(블록 −55% 에 업로드 시간 −20%) · 장문맥 전송 노출 |
CompressSpec · Qwen3-30B-A3B-Thinking-2507-yarn2 · Nebius VM RTX PRO 6000 1장(8장 중 0번) · Xeon 6776P · 한 세션에 요청마다 arm 을 실어 모델 로드 1회로 29셀.
| 항목 | 값 | |
|---|---|---|
| 4.2.2.1 | 코어 | 소켓 0 만 · verify 서버 0-91(92코어) · GPU 드라이버 92-95. 메모리 대역폭 소켓당 251 GB/s(읽기) · STREAM Triad 239 GB/s |
| 4.2.2.2 | max_model_len · 출력 상한 | 524,288 · 20,000 token |
| 4.2.2.3 | sampling · batch | temp 0.6 · top_p 0.95 · top_k 20 · seed 0 · batch 1 |
| 4.2.2.4 | GPU KV | 244,992 token · 7,656 블록 · 블록 32 |
| 4.2.2.5 | 압축 | COMPACT_METHOD=block · THRESHOLD 0.8 · 풀 상한 0.9 |
| 4.2.2.6 | 프롬프트 | 128K 131072_Q1·Q2 · 256K 262144_Q1·Q2 · 400K 420000_Q4(multi_qa, 429,429 tok) · Q5(structured, 425,046 tok) |
| 4.2.2.7 | 코드 | feature/compaction-diff-upload-v2 · 001 01ceef4 · vllm d8a4c945 |
- 기(상황) 400K 는 처음에
420000_Q1(항생제 내성 CSV 표)을 썼다 - 승(증상) 모델이 목록을 반복 생성. 8-gram 고유율 35%, 최빈 8-gram 41회 → 반복 구간은 draft 가 전부 맞혀 accept 비교가 무의미
- 전(원인) structured 도메인의 생성 퇴화(4.1 L40S 400K Table QA 3문항과 같은 현상)
- 결(조치) RunPod 판
perdoc_512k.csv에서 eos 정상 종료가 확인된 Q4·Q5 로 교체. 420Kheadroom10은 선택 풀 7,976 > GPU 7,656 블록으로UPLOAD_OOM이라 막대에서 제외
정합 판정 (수정 후, 양 arm 001 01ceef4e6) | fullonly 라운드/토큰/accept합 | ratio1.0 | 판정 | |
|---|---|---|---|---|
| 4.2.4.1 | 128K Q1 | 174 / 2,671 / 2,658 | 174 / 2,671 / 2,658 | 일치 |
| 4.2.4.2 | 128K Q2 | 103 / 1,513 / 1,501 | 103 / 1,513 / 1,501 | 일치 |
| 4.2.4.3 | 256K Q1 | 242 / 3,544 / 3,501 | 242 / 3,544 / 3,501 | 일치 |
| 4.2.4.4 | 256K Q2 | 168 / 2,615 / 2,609 | 168 / 2,615 / 2,609 | 일치 |
라운드별 검증 창·accept 수열·보존 블록 수·KV 지문·draft 제안 token 까지 대조(PARITY OK). 착지 시점 가지치기 507회, 포기 0건.
| E2E | arm | 토큰 | 라운드 | prefill s | 생성 s | tok/s | 라운드당 s | |
|---|---|---|---|---|---|---|---|---|
| 4.2.6.1 | 128K Q1 | fullonly | 2,671 | 174 | 42.5 | 326.2 | 8.19 | 1.87 |
| 4.2.6.2 | 128K Q1 | ratio1.0 | 2,671 | 174 | 41.6 | 280.0 | 9.54 | 1.61 |
| 4.2.6.3 | 128K Q2 | fullonly | 1,513 | 103 | 43.4 | 183.5 | 8.25 | 1.80 |
| 4.2.6.4 | 128K Q2 | ratio1.0 | 1,513 | 103 | — | 169.0 | 8.95 | 1.66 |
| 4.2.6.5 | 256K Q1 | fullonly | 3,544 | 242 | 359.1 | 646.2 | 5.48 | 2.67 |
| 4.2.6.6 | 256K Q1 | ratio1.0 | 3,544 | 242 | — | 632.0 | 5.61 | 2.62 |
| 4.2.6.7 | 256K Q2 | fullonly | 2,615 | 168 | 대기 포함 | 441.9 | 5.92 | 2.63 |
| 4.2.6.8 | 256K Q2 | ratio1.0 | 2,615 | 168 | — | 435.0 | 6.01 | 2.60 |
128K 판은 진단 로그를 켠 상태라 라운드당 0.2초쯤 불리. 본 측정은 끈다.
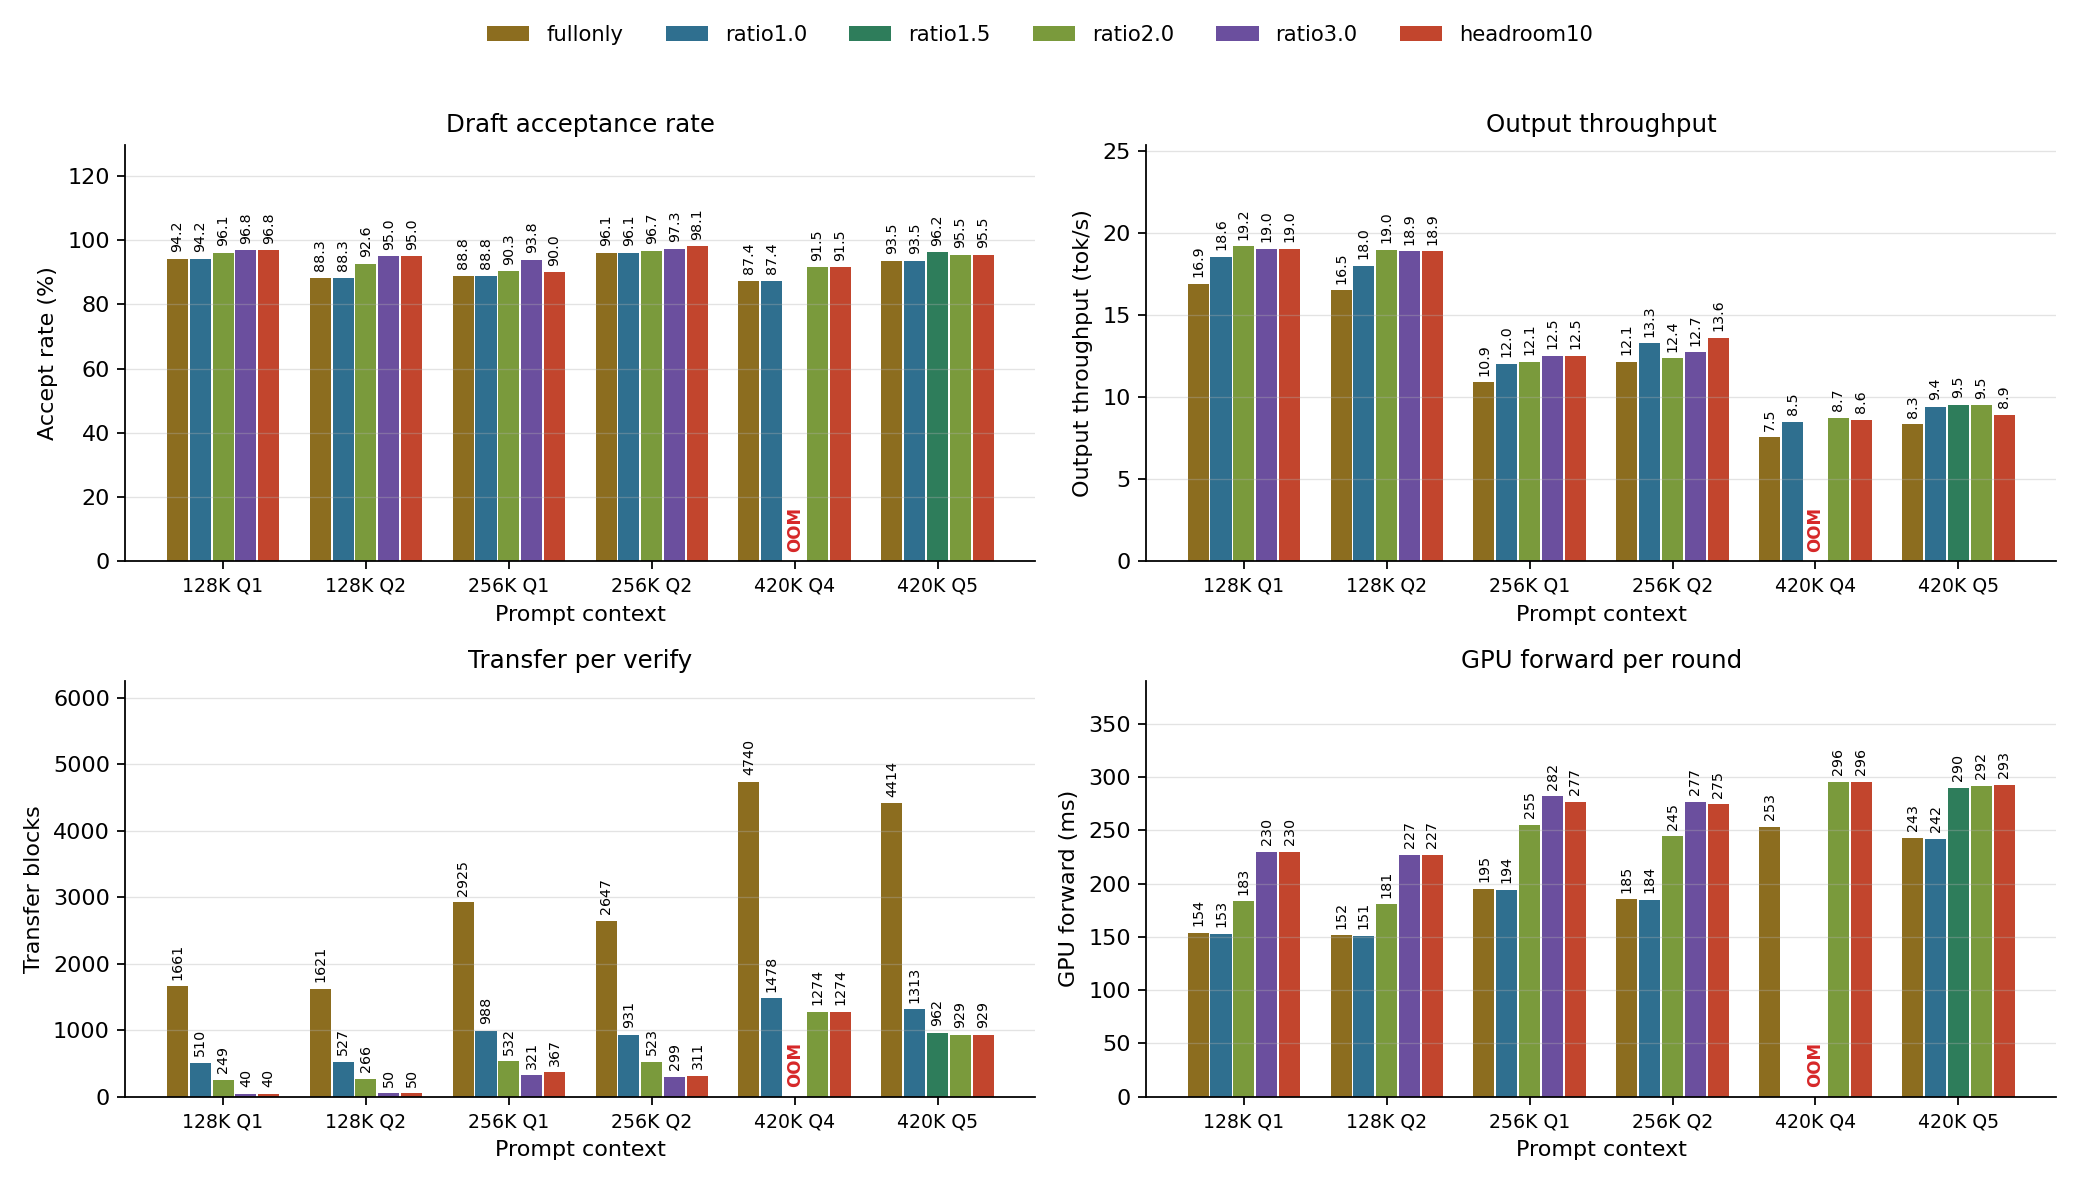
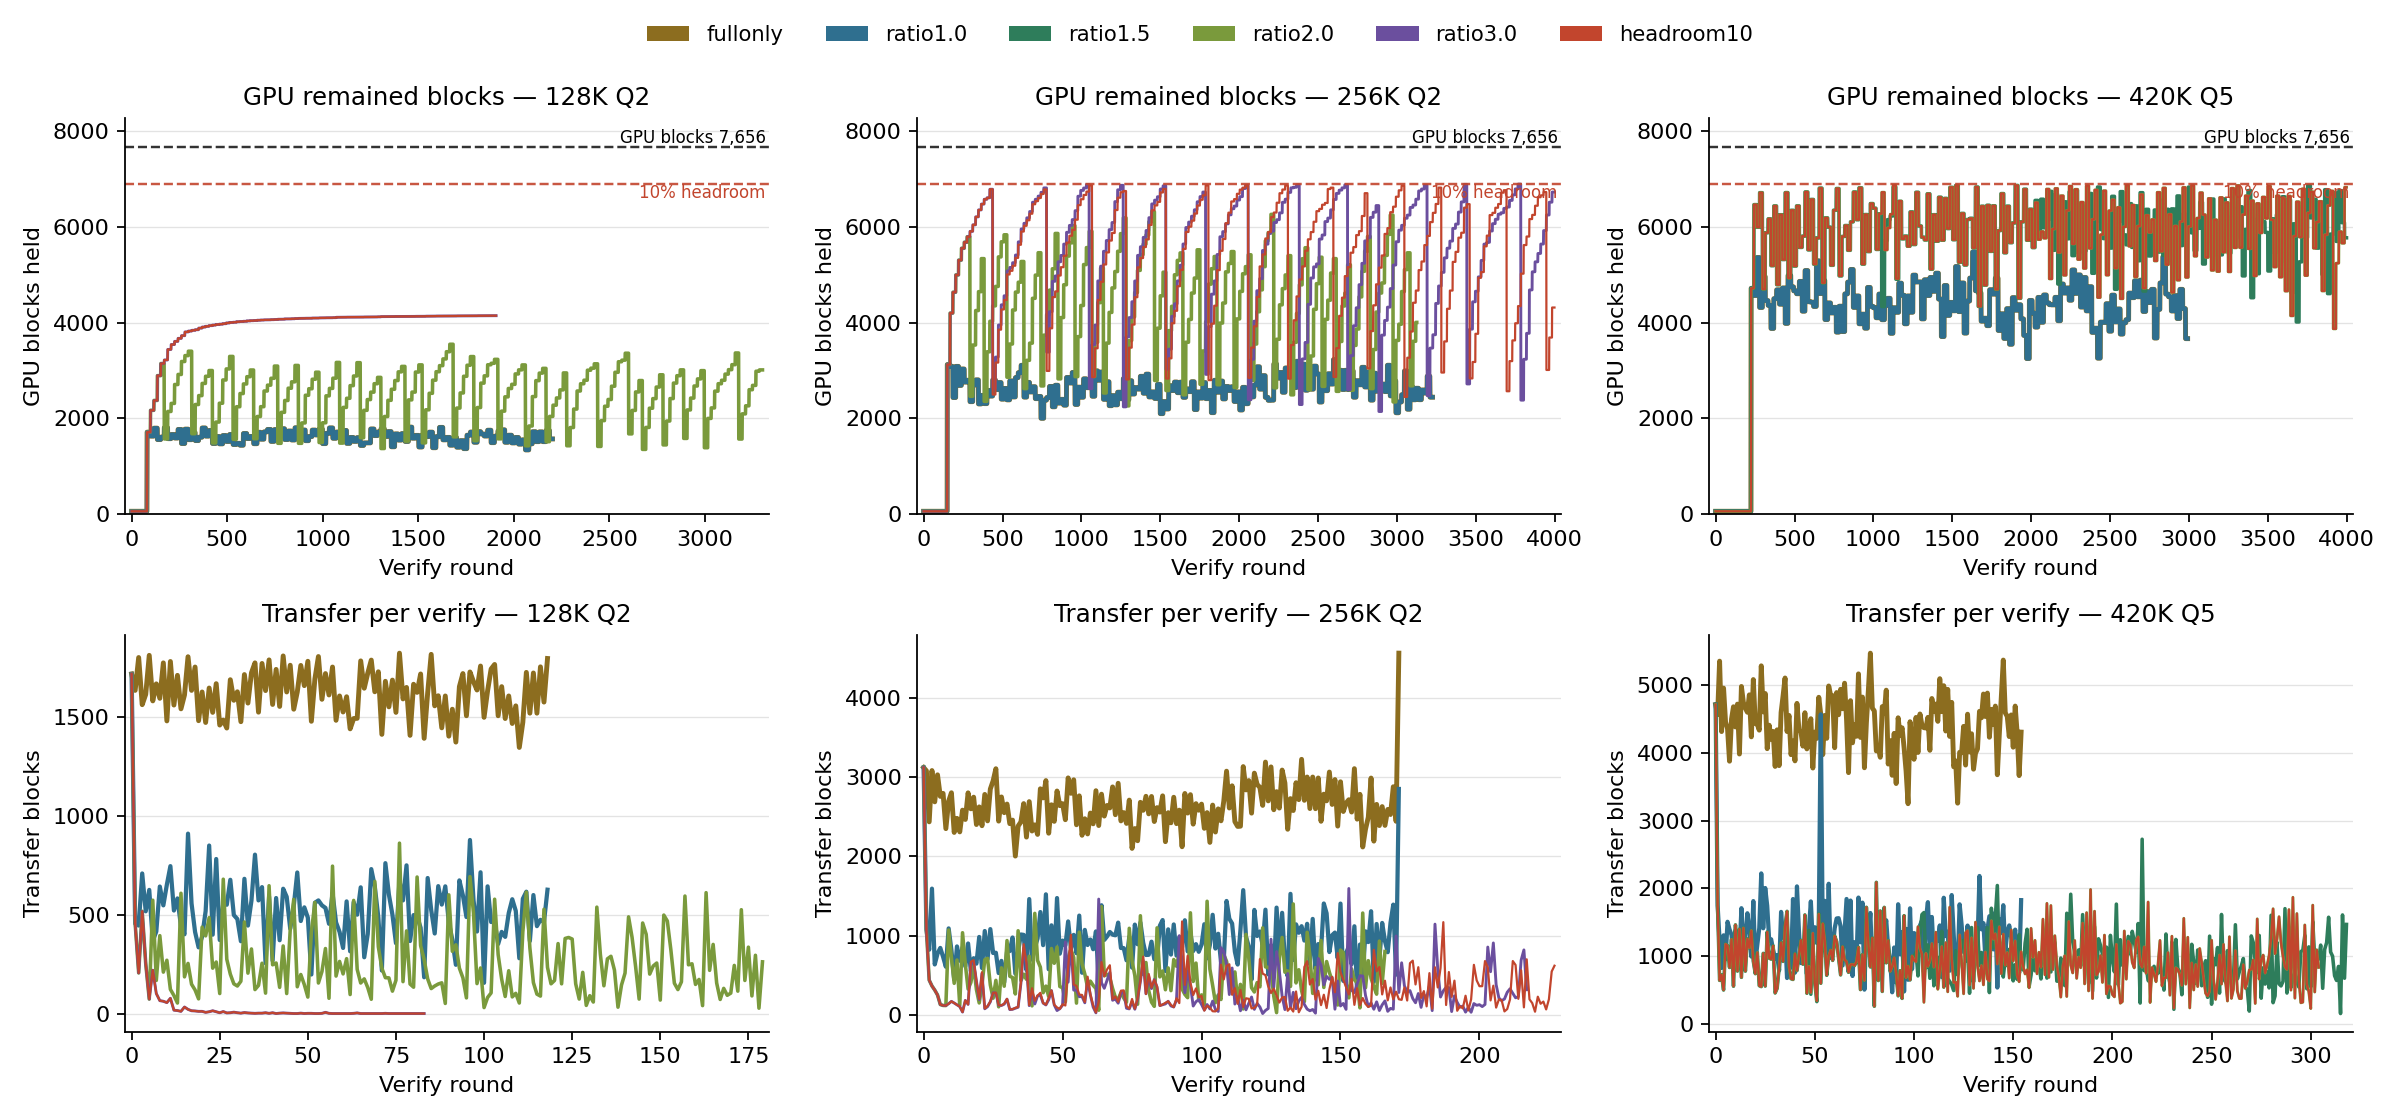
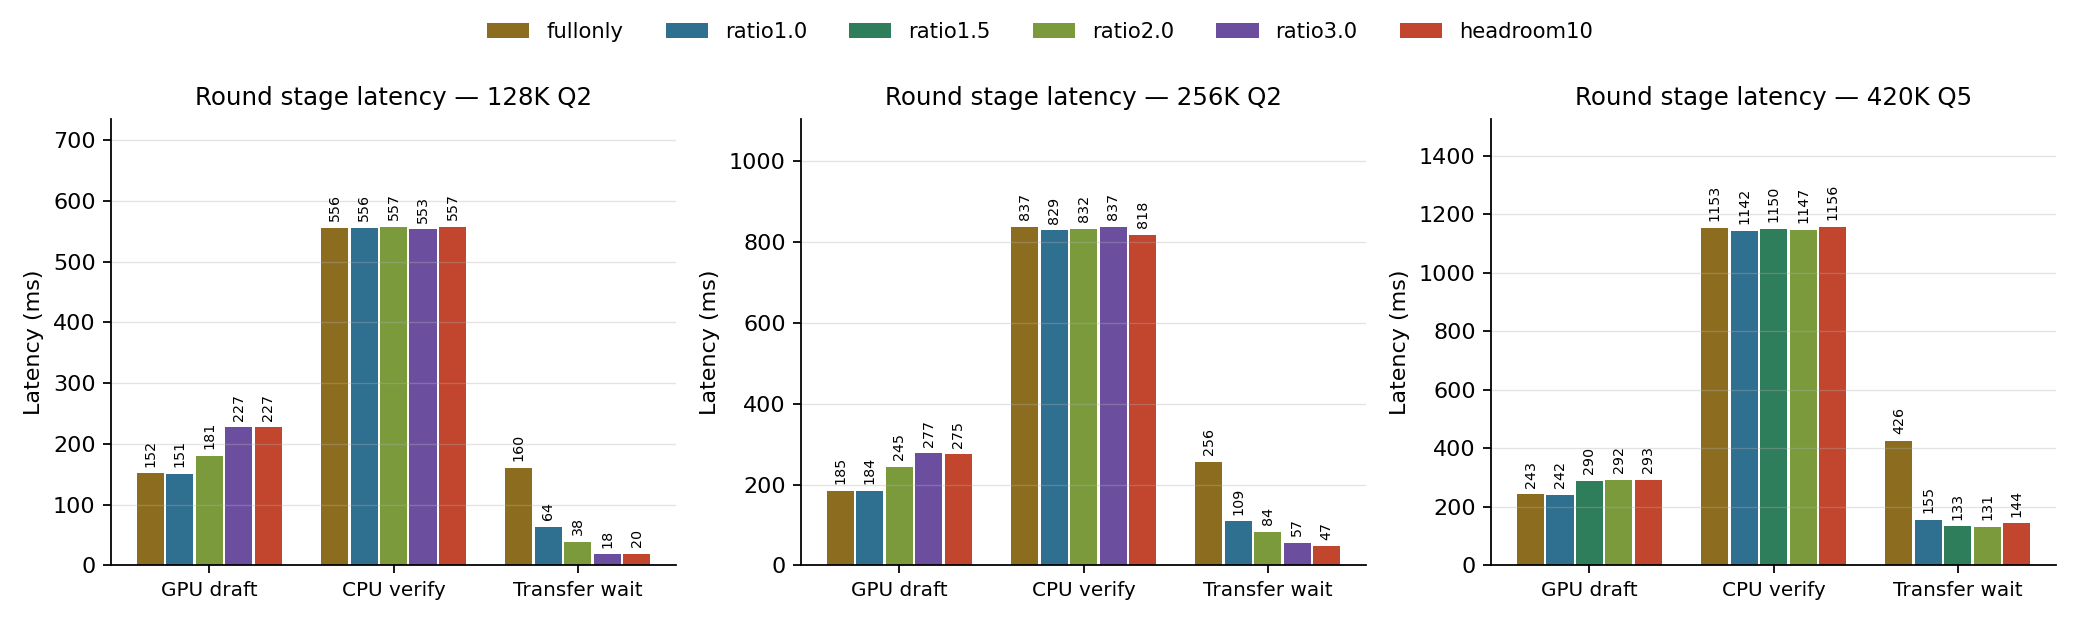
420K-Q4 ratio1.5 는 115번째 압축 라운드에서 CPU selection 9,422 > GPU budget 7,656 으로 OOM 처리. 셀별 곡선(accept·pool·delta·post 각 6장)과 stage 그림은 원본 1.1 탭.
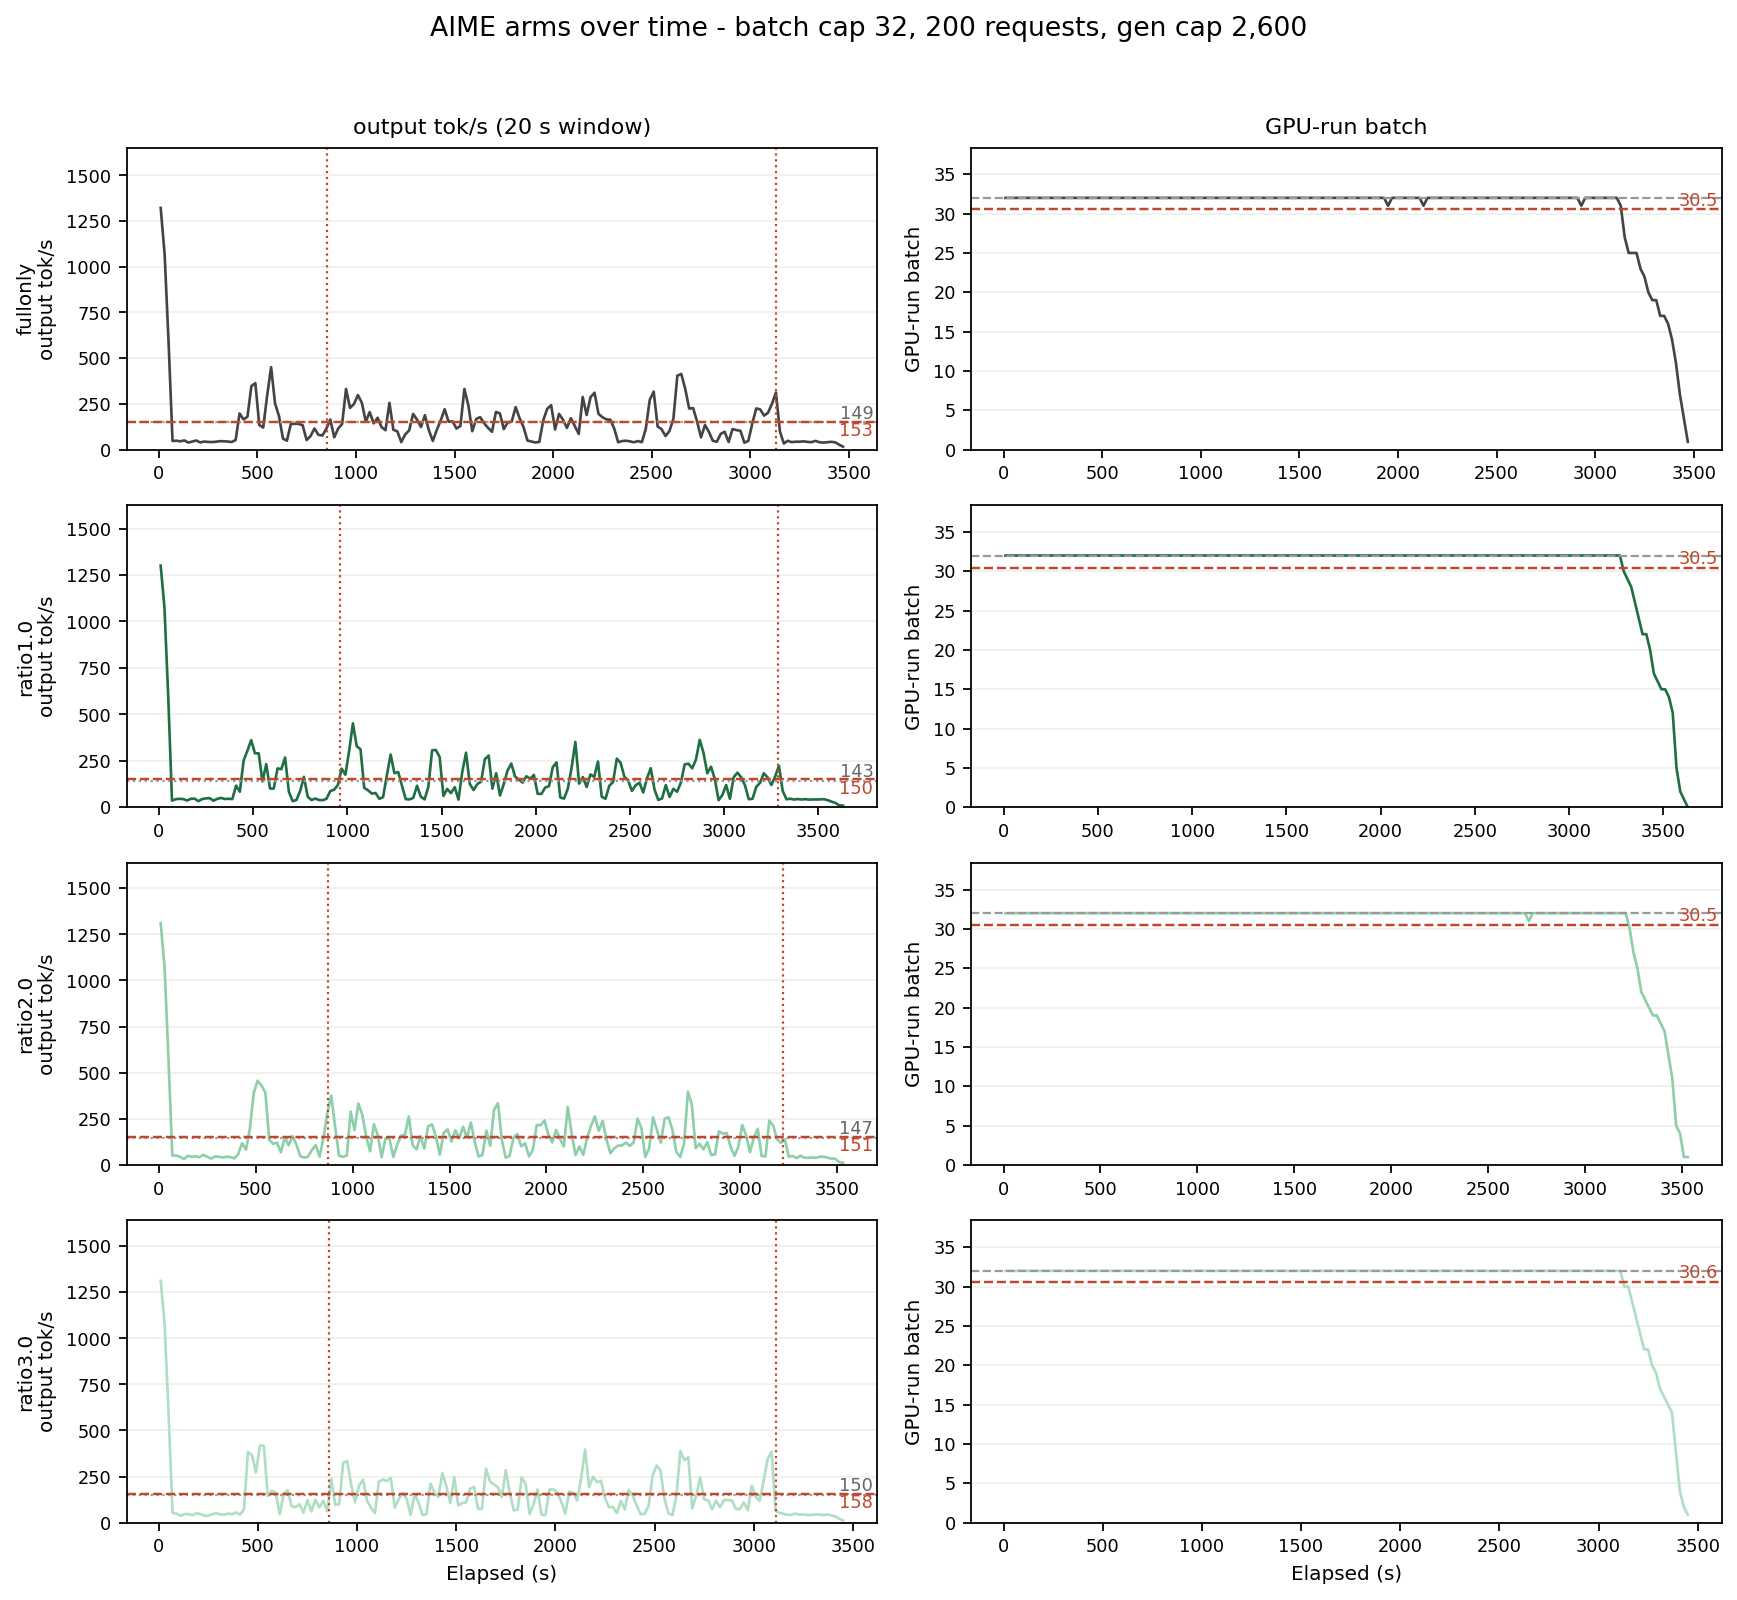
CompressSpec arm 비교 (L40S · Qwen3-4B, YaRN 미적용) — MathArena/aime_2025 30문제 순환 · THRESHOLD 0.5 · batch 32 · temp 0.6 · n82. 4.1 스윕과 벤치마크·모델 빌드가 다르고, 아래 SparseSpec 대 vanilla 와도 다른 실험(엔진이 다르다).
| 단계 | arm | 요청 | 생성 상한 | 라운드 | accept | 출력 token | 초 | gen tok/s | 판정 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 4.3.2.1 | aimep | ratio1.0 | 65 | 2,000 | 1,025 | 54.0% | 129,680 | 517 | 599.3 | ok |
| 4.3.2.2 | aimep | fullonly | 65 | 2,000 | 1,064 | 51.8% | 129,705 | 480 | 512.1 | ok |
| 4.3.2.3 | aimep2 | fullonly | 65 | 2,000 | 1,053 | 53.2% | 129,787 | 542 | 588.1 | ok |
| 4.3.2.4 | aime3 | ratio1.0 | 200 | 2,600 | 16,442 | 52.4% | 519,227 | 3,634 | 150.4 | ok |
| 4.3.2.5 | aime3 | fullonly | 200 | 2,600 | 16,285 | 53.0% | 519,244 | 3,477 | 153.9 | ok |
| 4.3.2.6 | aime3 | ratio2.0 | 200 | 2,600 | 15,396 | 56.6% | 519,215 | 3,704 | 151.8 | ok |
| 4.3.2.7 | aime3 | ratio3.0 | 200 | 2,600 | 14,951 | 58.6% | 519,192 | 3,663 | 158.2 | ok |
| 4.3.2.8 | aime1 | ratio1.0 | 200 | 40,960 | 13 | — | 0 | 396 | — | fail: util 0.85 cuda-oom (sampler sort, 여유 52 MiB) |
- 기(상황) batch 32 에서 ratio1.0 과 fullonly 의 token 열이 65요청 중 다수 갈렸다
- 승(증상) fullonly 대 fullonly(같은 설정 재실행)도 갈린다 — 자기 재현 실패
- 전(원인) arm 이 아니라 batch. batch > 1 이면 드라이버가 요청을 동시에 처리해 순서가 비결정
- 결(조치) batch 32 에서는 token 단위 정합을 arm 비교의 관문으로 쓰지 않는다. CPU verify 는 KV 업로드 라운드에만 호출되므로(1,062 = full 60 + diff) 짧은 컨텍스트 셀의 처리량은 CompressSpec 처리량이 아니다(미해결)
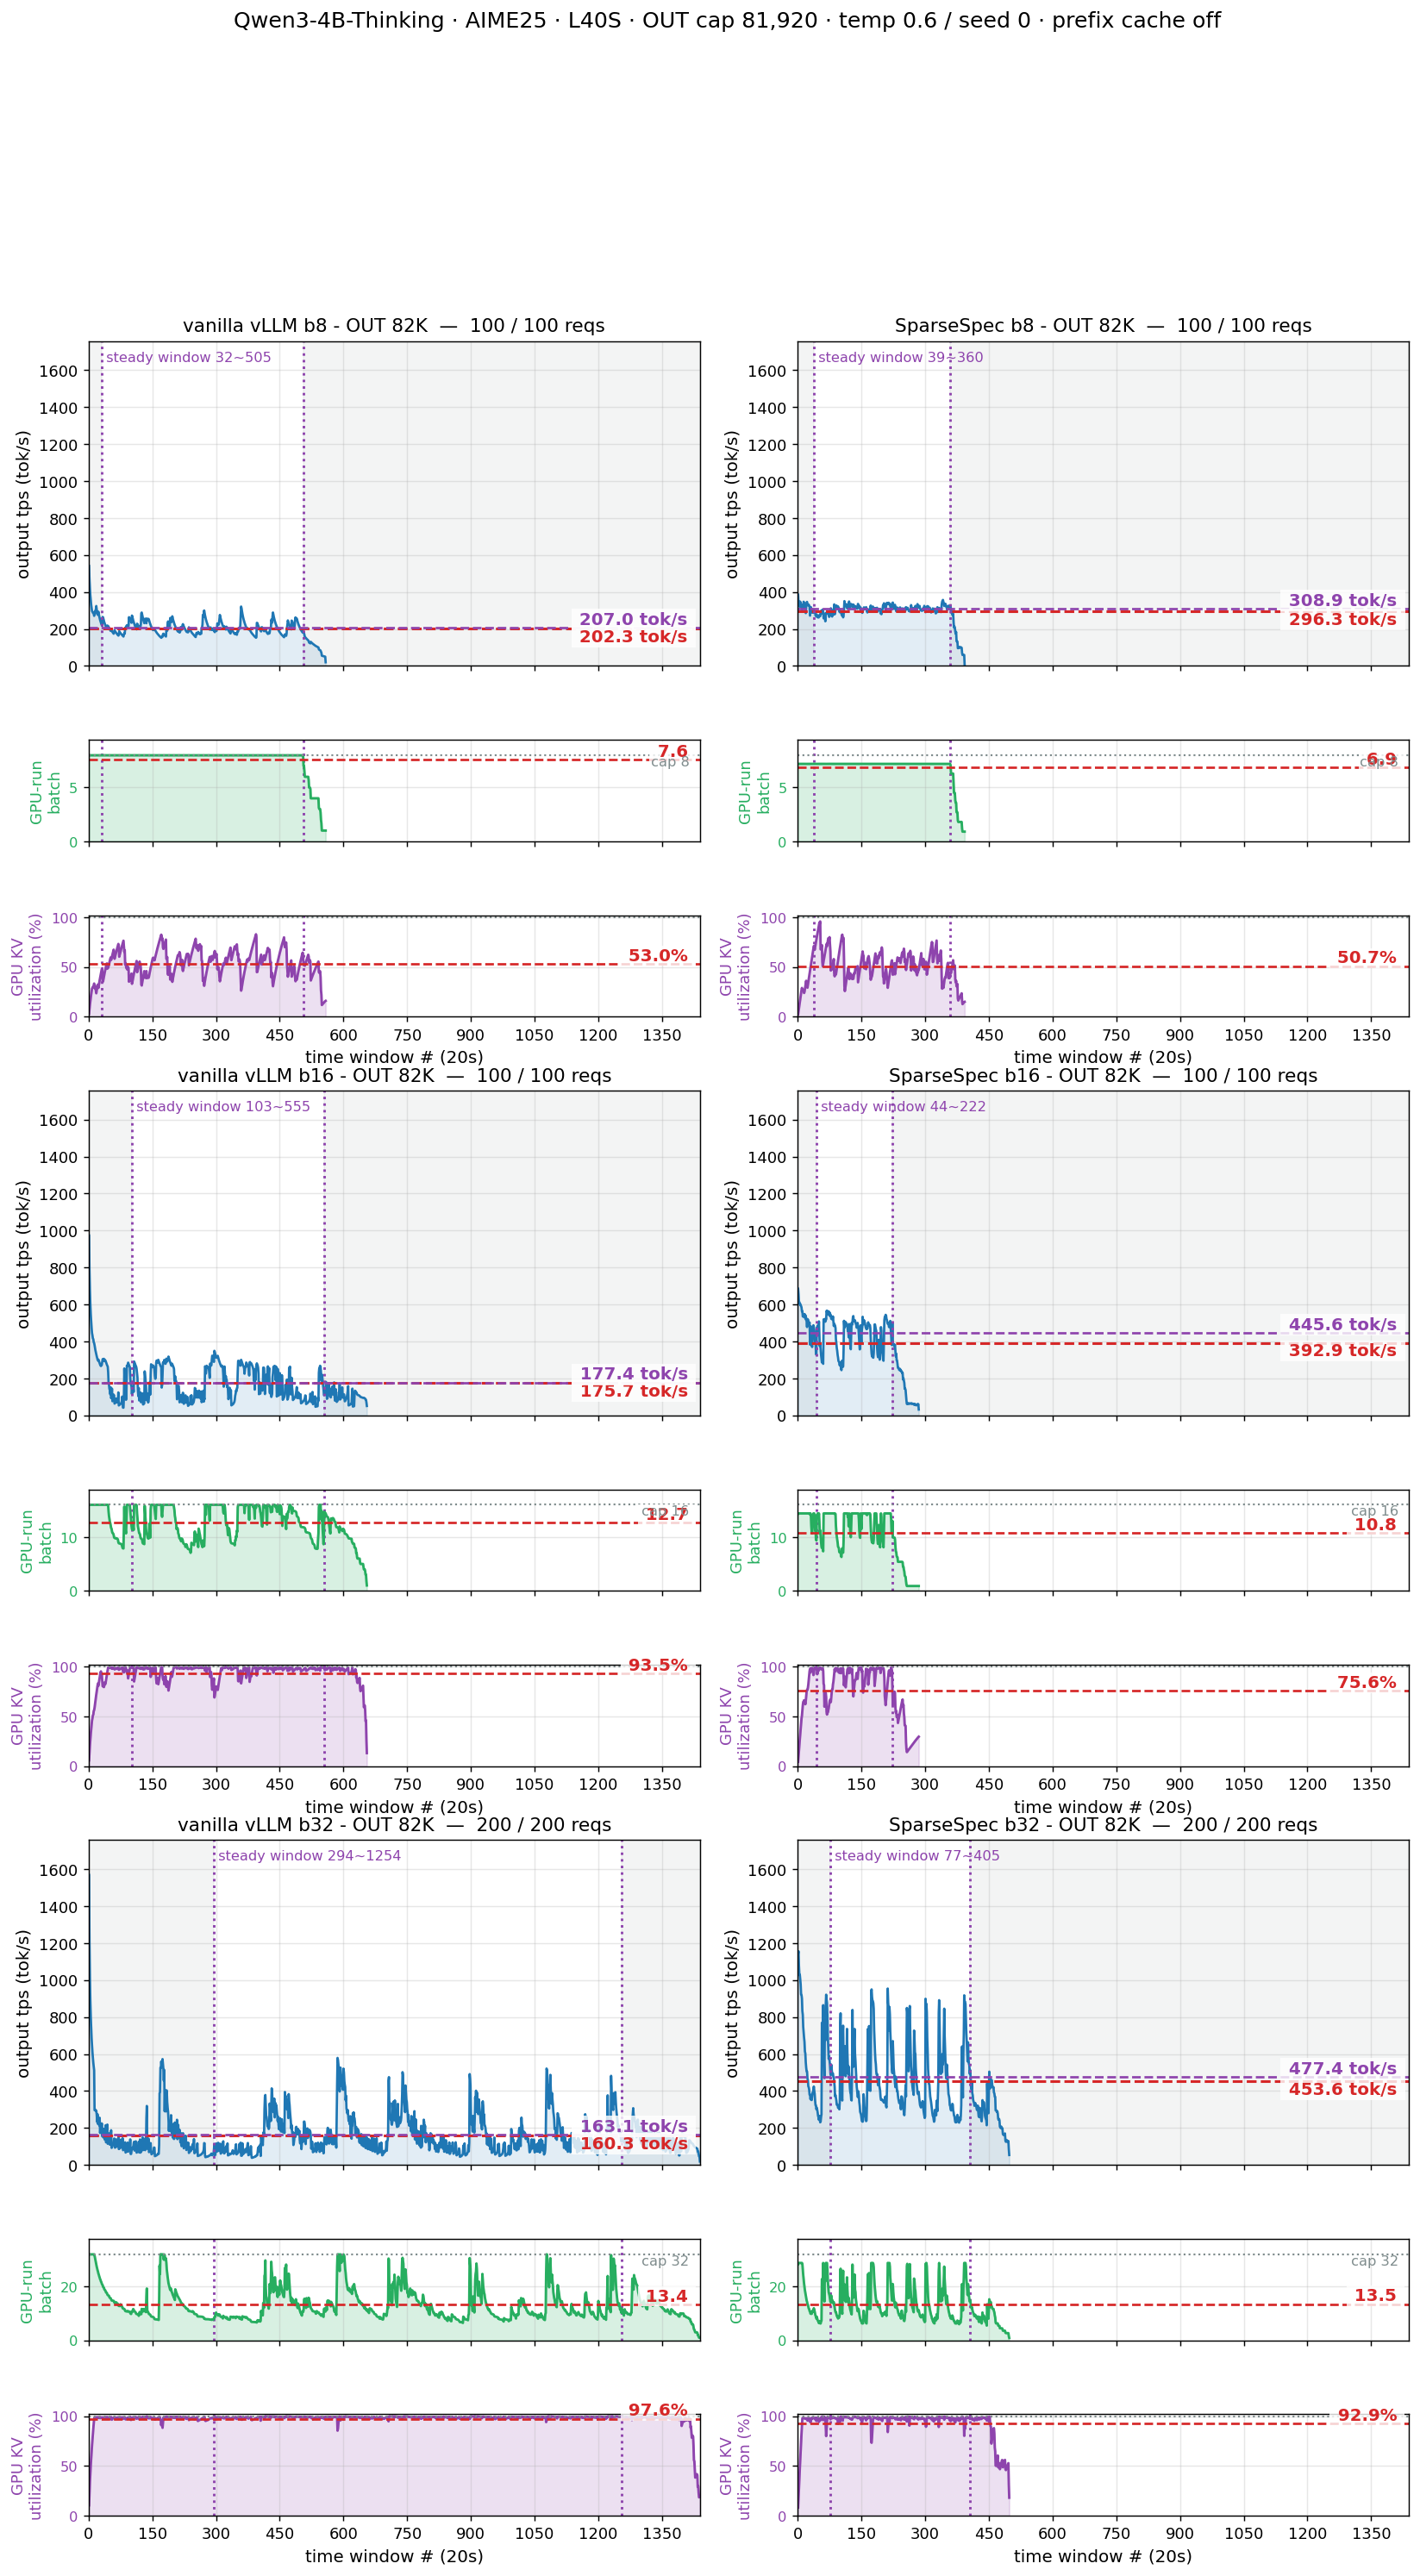
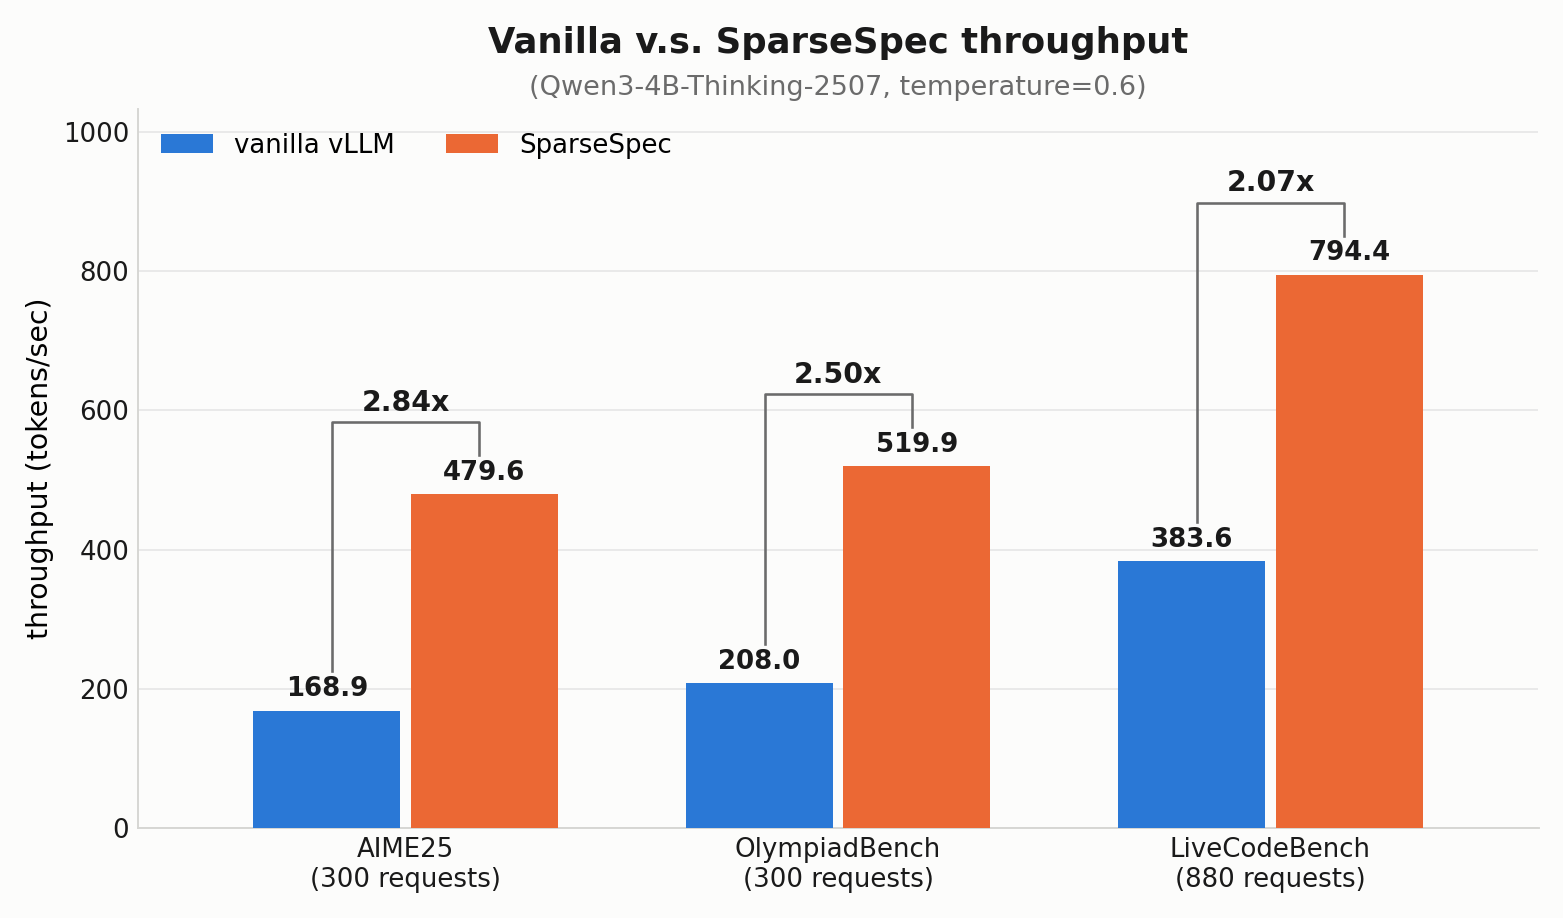
SparseSpec 대 vanilla vLLM (baseline · L40S · Qwen3-4B) — AIME25 · OUT cap 81,920 · temp 0.6 / seed 0. 전 셀 완주(b8·b16 100/100, b32 200/200).
RTX PRO 6000 · Qwen3-30B-A3B · AIME 처리량 (RunPod) — vanilla vLLM 0.14.0 대 SparseSpec. 요청 200 / batch 32 · 출력 40K · temp 0.6 · prefix caching OFF · gpu_memory_utilization 0.85. 판정은 e2e(총 token ÷ 총 wall)와 누적 곡선, 순간값 비교 금지. 결과는 결과 탭 3.x 와 클러스터 16_D2_qwen3-30B-A3B-benchmark_tps.
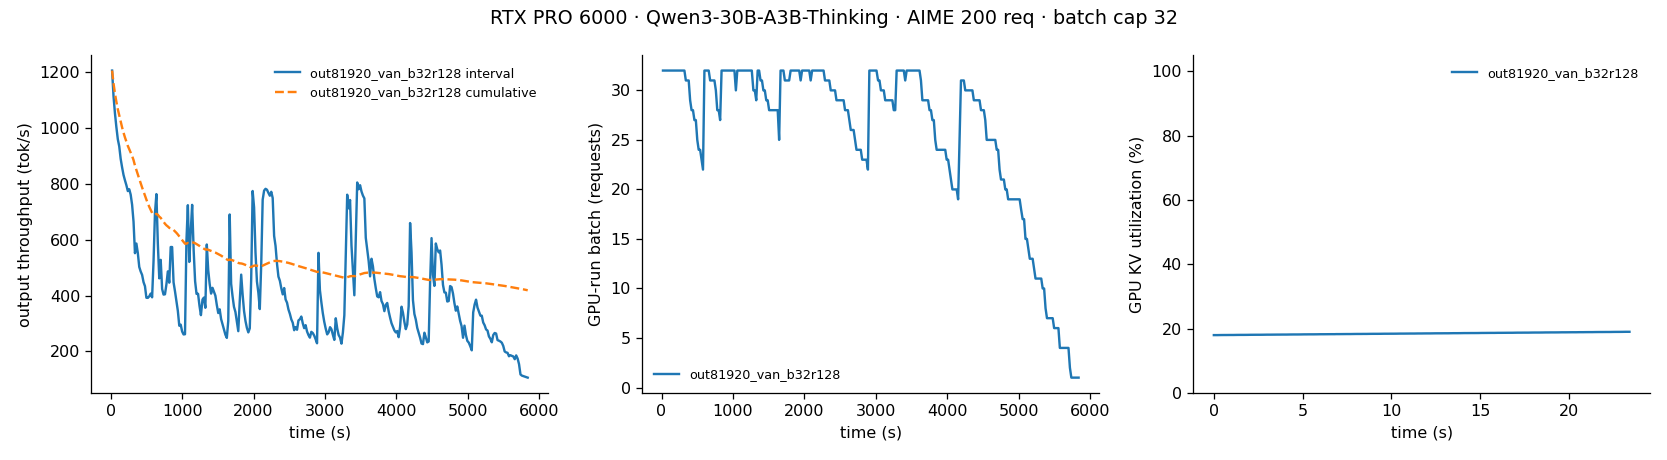
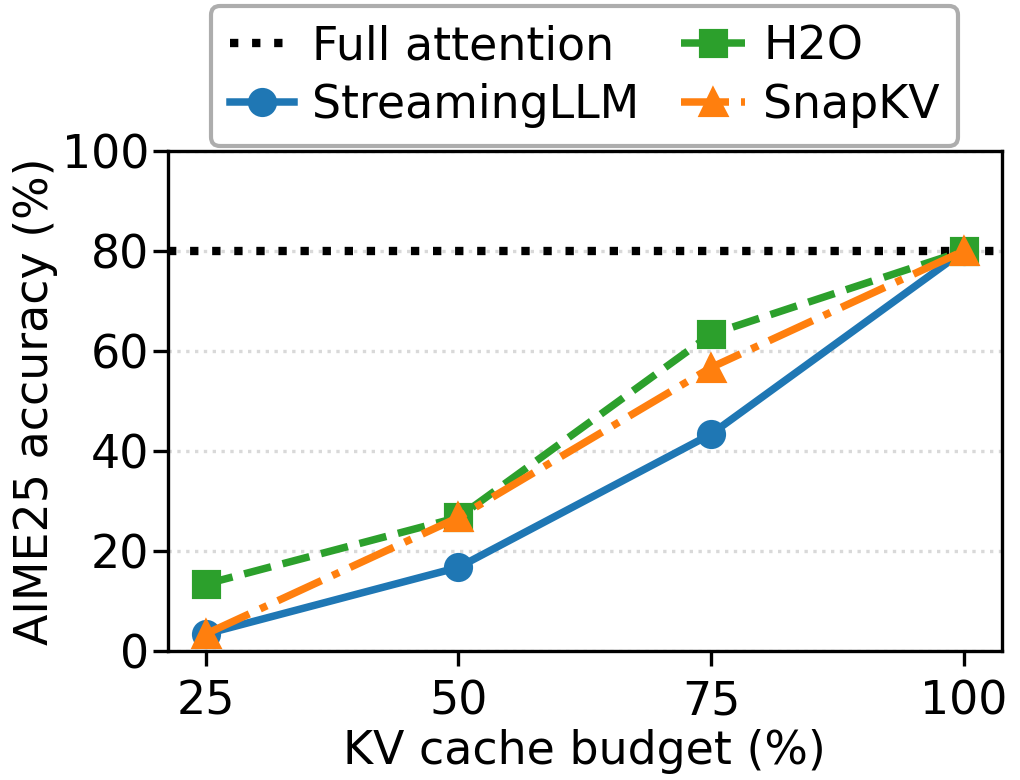
out81920_van_b32r128 t=5,840 s · 128/200 완료 · 구간 106 tok/s · 누적 419 tok/s · KV 19%AIME 2025 prefill KV pruning (Qwen3-30B-A3B-Thinking-2507) — n=30 · greedy · max_new 32,768 · 10/10 셀 완료 (2026-09-23). 원천 /home/shared/JH_MARVEL/dashboard_inbox/aime_kv_pruning/README.txt.
| method | KV budget | accuracy | correct | cap hit | wall s | GPU | |
|---|---|---|---|---|---|---|---|
| 4.3.12.1 | full | 100% | 80.0% | 24/30 | 3 | 3,989 | H200 |
| 4.3.12.2 | h2o | 75% | 63.3% | 19/30 | 5 | 4,144 | H200 |
| 4.3.12.3 | snapkv | 75% | 56.7% | 17/30 | 7 | 4,145 | H200 |
| 4.3.12.4 | streamingllm | 75% | 43.3% | 13/30 | 9 | 4,134 | H200 |
| 4.3.12.5 | h2o | 50% | 26.7% | 8/30 | 4 | 4,107 | H200 |
| 4.3.12.6 | snapkv | 50% | 26.7% | 8/30 | 9 | 4,106 | H200 |
| 4.3.12.7 | streamingllm | 50% | 16.7% | 5/30 | 5 | 4,108 | H200 |
| 4.3.12.8 | h2o | 25% | 13.3% | 4/30 | 6 | 9,581 | RTX PRO 6000 |
| 4.3.12.9 | snapkv | 25% | 3.3% | 1/30 | 15 | 3,199 | H200 #1-20 + PRO 6000 #21-30 |
| 4.3.12.10 | streamingllm | 25% | 3.3% | 1/30 | 2 | 6,386 | RTX PRO 6000 |
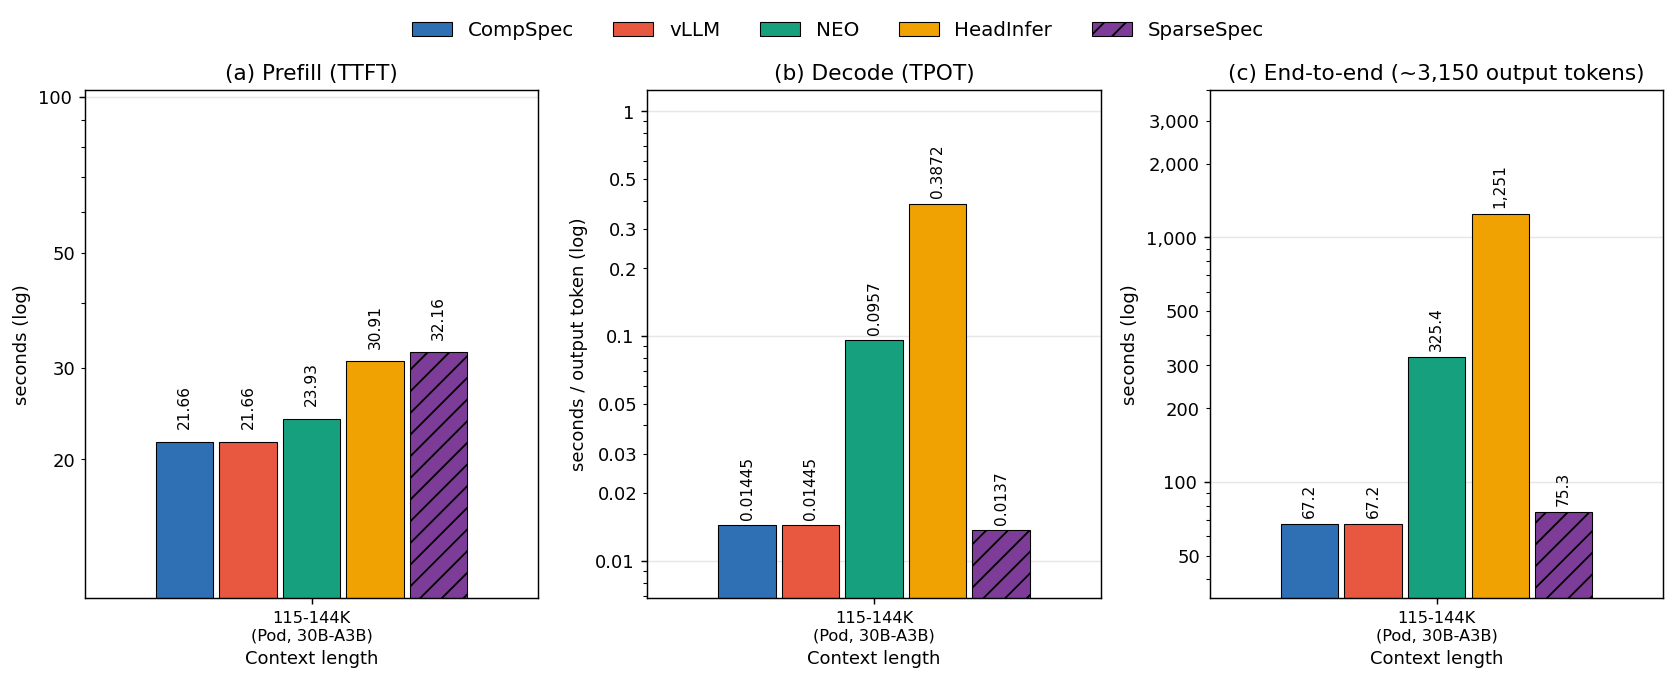
RTX PRO 6000 · Qwen3-30B-A3B · 5-way (115~144K, 문서 52개, batch 1) — 값은 중앙값. 실패·OOM·상한 절단 0.
| 시스템 | Prefill s | TPOT s/token | E2E 정규화 s | E2E 실측 중앙 s | 종류 | |
|---|---|---|---|---|---|---|
| 4.4.2.1 | vLLM | 21.66 | 0.0144 | 67.2 | 69.6 | measured |
| 4.4.2.2 | TandemSpec | 21.66 | 0.0144 | 67.2 | 69.8 | measured |
| 4.4.2.3 | NEO | 23.93 | 0.0957 | 325.4 | 320.9 | modeled |
| 4.4.2.4 | HeadInfer | 30.91 | 0.3872 | 1250.6 | 1261.3 | modeled |
| 4.4.2.5 | SparseSpec | 32.16 | 0.0137 | 75.3 | 76.3 | measured |
E2E 정규화 = prefill + 3,150 × TPOT (SparseSpec 평균 출력 5,514, 나머지 5,976 token 이라 길이 차이를 뺀다).
- 기(상황) SparseSpec 은 vLLM 보다 prefill 이 10.50 s 느리고 출력 token 당 0.00075 s 빠르다
- 승(증상) 상쇄되는 출력 길이 14,000 token. 이 문서 집합의 SparseSpec 출력 중앙값 2,878 → 교차점을 넘는 문서 52개 중 3개
- 전(원인) 지금 워크로드는 대부분 교차점보다 짧다. 생성 시작 비용을 고정비로 옮기면 교차점 9,516 token (표본 20개일 때 9,304) — 표본에 따라 크게 움직인다
- 결(조치) E2E 로는 SparseSpec 불리, 이점은 TPOT 에서 본다. 유보 사항 원문
lcp6_06_reservations.md(원본 5.2 탭)
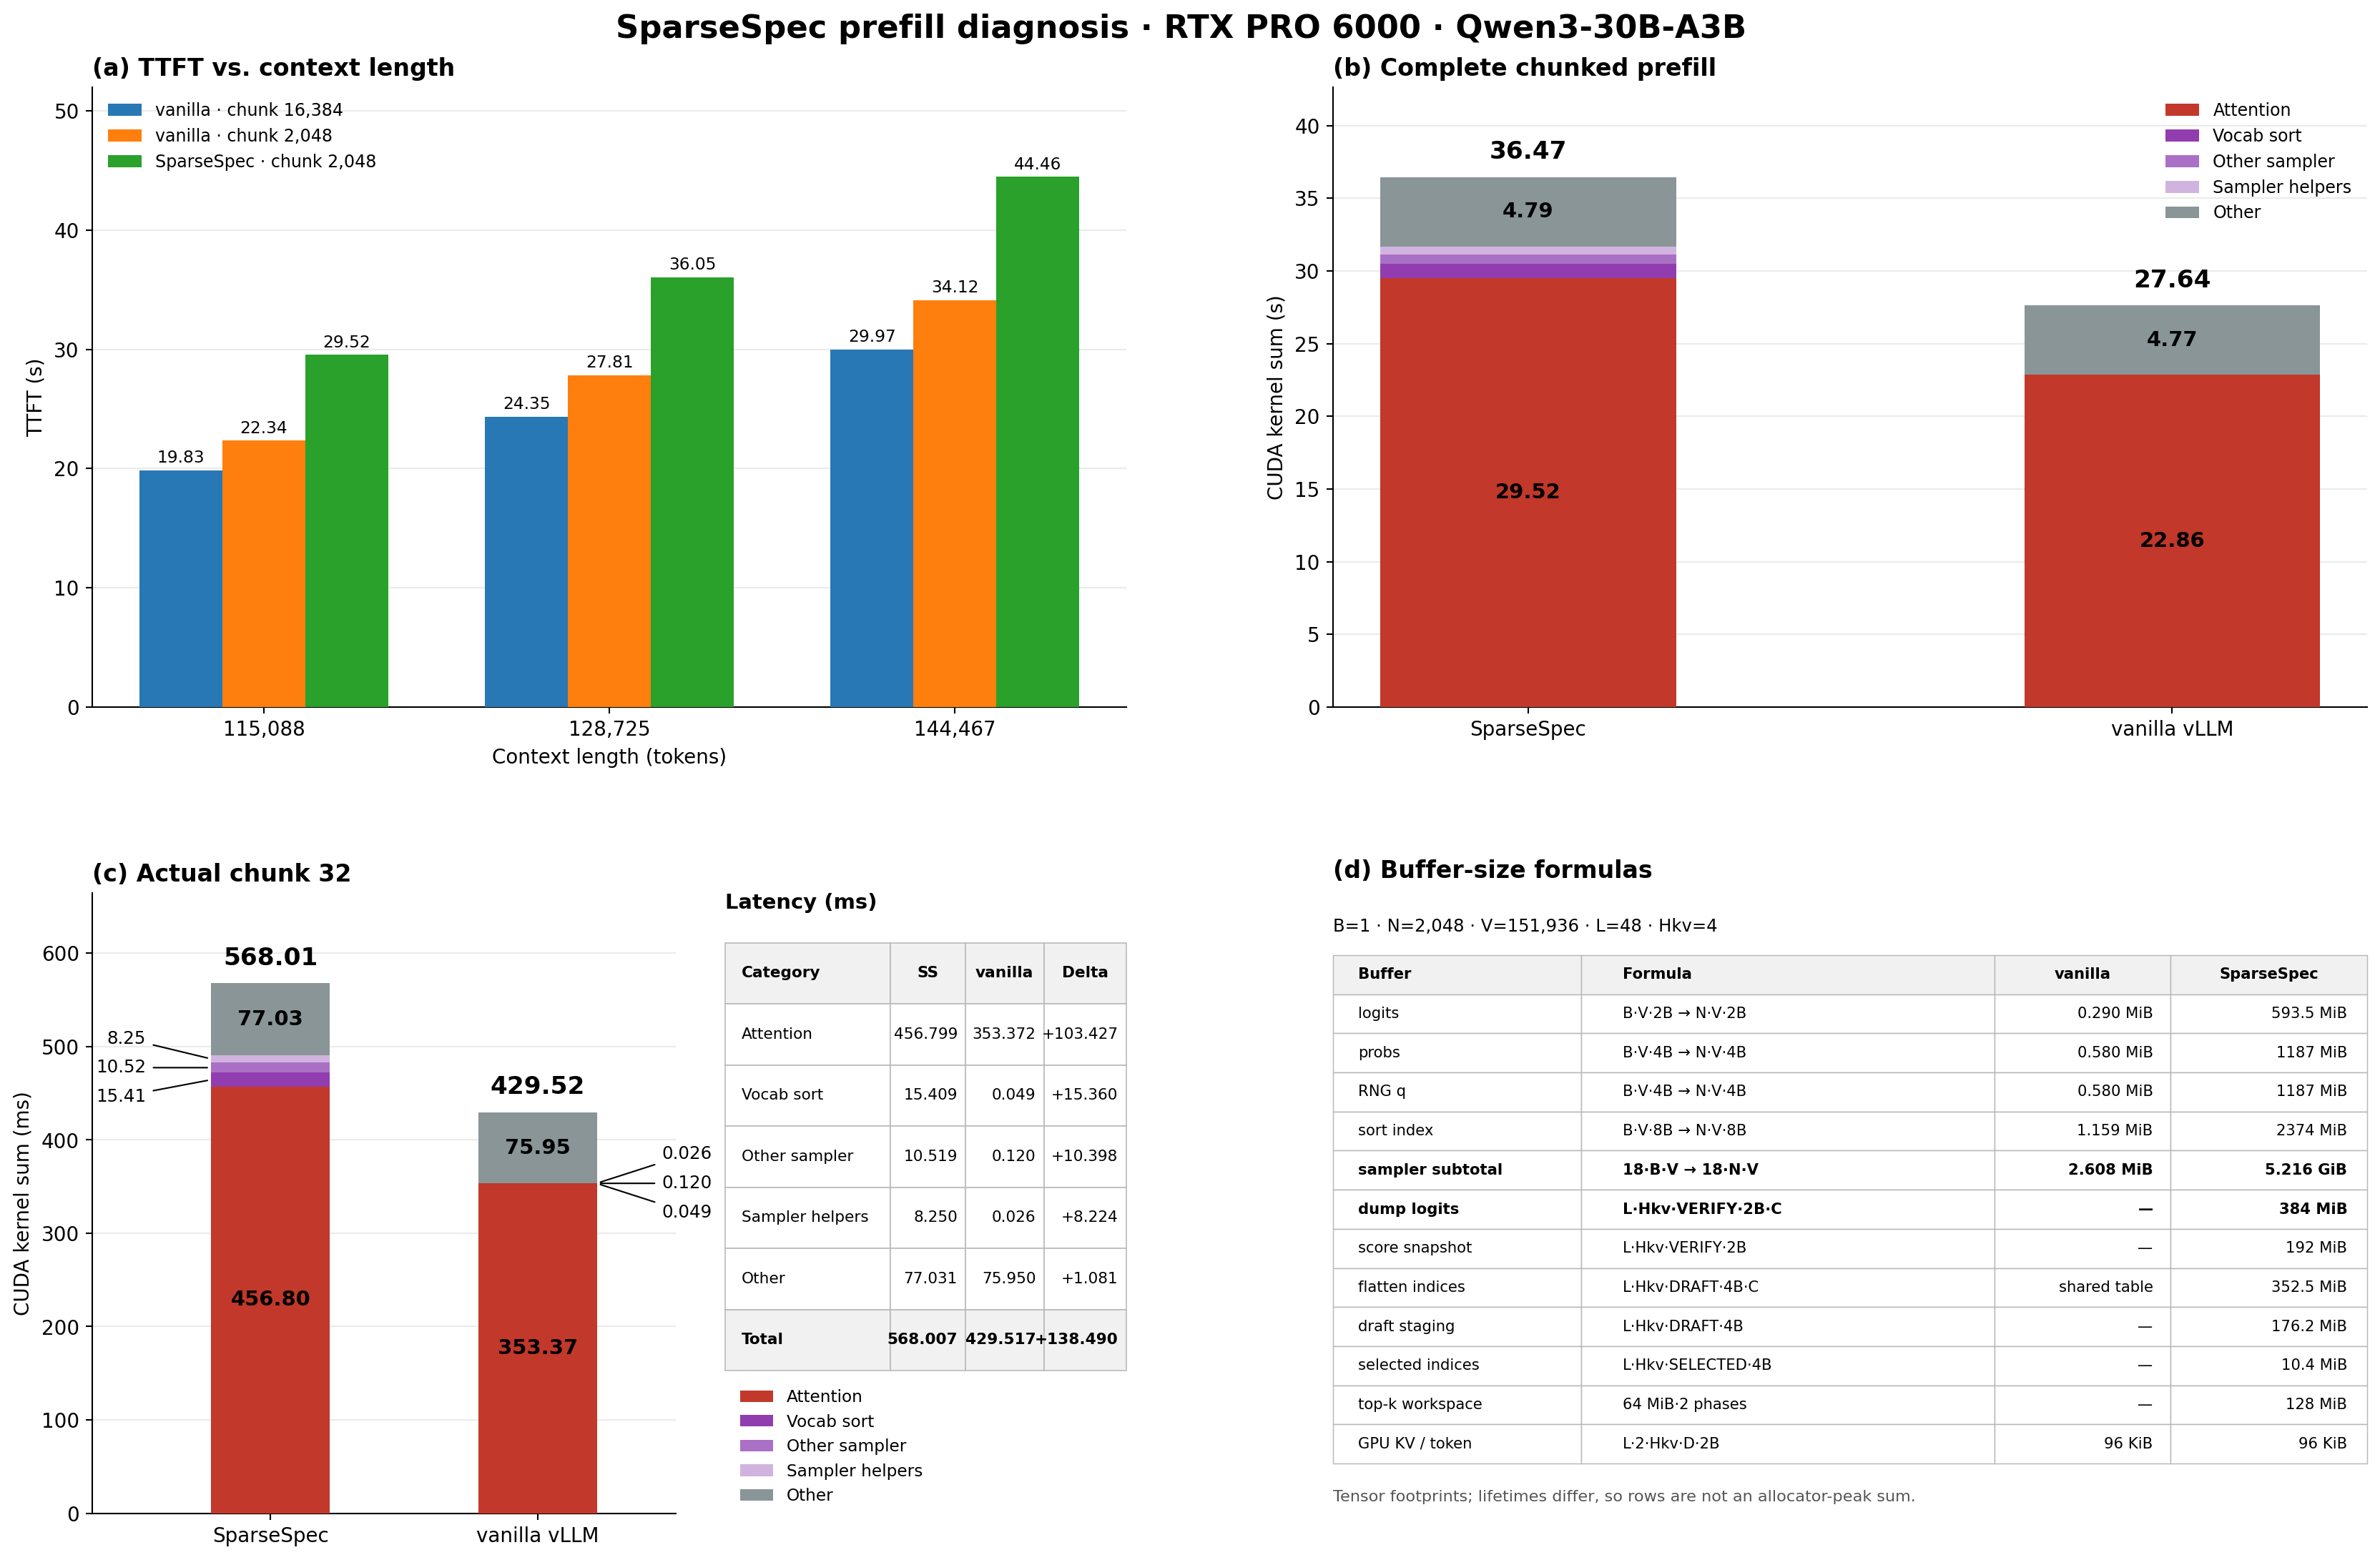
| RTX PRO 6000 TTFT (chunk 2,048, 문서 3개) | vanilla vLLM 0.14.1 | SparseSpec | 차이 | |
|---|---|---|---|---|
| 4.4.6.1 | 115,088 tok | 22.26 s | 29.52 s | +7.26 |
| 4.4.6.2 | 128,725 tok | 28.32 s | 36.05 s | +7.74 |
| 4.4.6.3 | 144,467 tok | 34.27 s | 44.46 s | +10.18 |
| 4.4.6.4 | 평균 | 28.29 s | 36.68 s | +8.39 (+29.7%) |
- 기(상황) vanilla 를 FlashInfer·block 32·graph ON 으로 맞추고 SparseSpec TTFT 경계를 prefill 완료로 교정했다
- 승(증상) 같은 세 문서에서 SparseSpec prefill 이 +29.7%, chunk 당 131.8 ms 격차. graph 설정 차이는 0.2 s 이하
- 전(원인) persistent attention 본체가 FlashInfer 보다 KV 32K~129K 에서 22~45% 느림 + prefill 2,048 row 전부에 LM-head·top-k/top-p 수행(full-vocab sort 15.3 ms/chunk 확정). attention 내부 원인은 미확정(NCU 비교 진행 중)
- 결(조치) 버퍼 공식·메모리 분석은 원본 5.3 탭
p6mem_00_memory_buffers.md
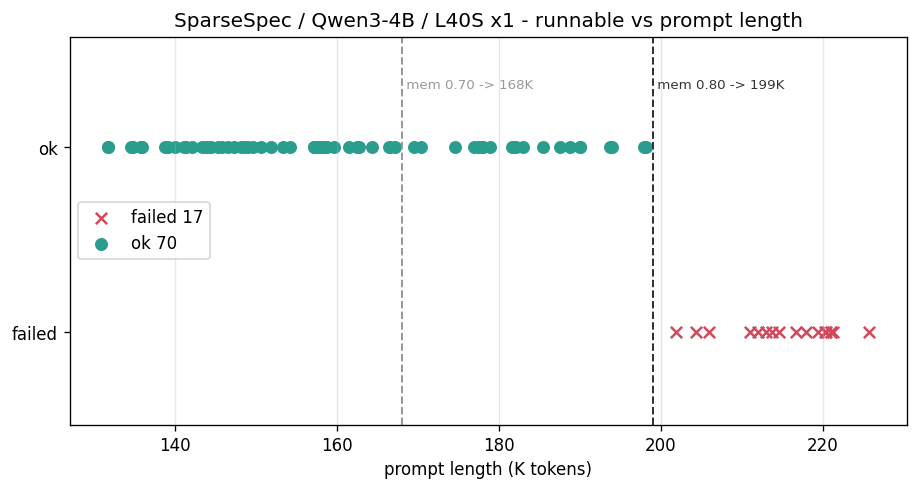
L40S · Qwen3-4B · 장문 상한 (expr_14, LongBench-v2 무절단 87문서 131K~226K, batch 1)
| 항목 | 값 | |
|---|---|---|
| 4.4.10.1 | 성공 / 실패 | 70 / 17 (실패는 전부 용량 초과) · 성공 범위 131,731 ~ 198,211 token |
| 4.4.10.2 | 상한 | prompt + 생성 이 KV 풀에 들어가는가. mem_fraction 0.70 → 168K, 0.80 → 199K(실측 최대), 0.85 → OOM(풀 바깥 6.89 GiB, 절반이 sampler 임시 버퍼) |
| 4.4.10.3 | 처리량 | tpot 20~23 ms 로 평탄, prefill 만 45 → 78 s (131K → 198K) |
| 4.4.10.4 | host 메모리 | 상한을 못 올린다. batch 1 에서 offload 복원 조건이 성립하지 않아 199K 그대로 |
| 4.4.10.5 | 확장 | chunk 2048 → 512 (220~230K, 미검증) · TP=2 (약 450K/rank, distribute/tp.py 수정 필요) |
Dynamic Recompaction (decision model v2, 2026-09-16) — GPU resident KV 를 지금 줄일지 판단. token N 과 block B_gpu 로 같은 상태를 표현하고 draft·transfer·metadata·recompaction 을 ms 로 환산.
Benefit = h × [Tattn(B_gpu) − Tattn(B_keep)] + p_full × [Tfull(B_keep) − Tdelta(B_new)] + Tstall
Cost    = Trc(B_keep) + Tmeta + Margin              → RECOMPACT NOW when Benefit > Cost
R*      = 1 + α/(h×ρ) + (T0_rc + Tmeta + Margin) × BW_hbm / (h×ρ×M_block×B_keep)   (memory-bound roofline 닫힌형)
                                                    → RECOMPACT NOW when B_gpu > R* × B_keep
HARD GUARD: B_gpu + B_new > B_cap 이면 비용 비교보다 먼저 재압축| 기호 | 뜻 | |
|---|---|---|
| 4.5.3.1 | B_gpu · B_keep · B_new · B_cap | 현재 GPU KV 블록 · 재압축 뒤 남길 블록 · 이번 delta 블록 · GPU 상한 (pool_blocks · keep_blocks · len(new_cpu_block_ids) · num_gpu_blocks × cap) |
| 4.5.3.2 | h · ρ · α | lookahead(다음 판단 전 draft forward 수, spec_stride 와 같은지 미확정) · KV reread factor(이상적 1) · recompaction traffic factor(read+write 2, 임시 버퍼 포함 4) |
| 4.5.3.3 | M_kv · M_block | 2 × L × H_kv × D × dtype (Qwen3-4B 144 KiB/token · 4.5 MiB/block, Llama-3.1-8B 128 KiB · 4 MiB) |
| 4.5.3.4 | draft attention | 항상 memory-bound: AI = H_q/H_kv = 4 FLOP/B, L40S ridge ≈ 419 FLOP/B. Tattn = ρ × B × M_block / BW_hbm |
- 기(상황) α=4, ρ=1, h=16 이면 R* ≈ 1.25 로 수렴. 측정이 아니라 roofline 유도값
- 승(증상) 128K recompaction median 16.6~24.7 ms(B_keep 501~746), 256K 26.1~30.4 ms. α=2 가정 시 128K ≈ 7.7 ms 로 실측의 절반 미만
- 전(원인) 빠진 항: B_keep 으로 줄이면 accept 이 떨어진다(accept ∝ log2 보존 블록). Benefit 에 음수로 들어가야 하나 미정량화. metadata stage 는 timer 미분리
- 결(조치) 128K·256K 두 점 회귀로 α·T0_rc 동시 추정 가능. 계측 schema(State·Draft·Transfer·Metadata·Recompact, verify generation 당 1행) 원문은 원본 1.3 탭
Block-level selection 전환 · 설계 v3 (2026-09-16, ai-cluster CompressSpec)
- 기(상황) GPU selected block table 은 KV group 당 한 row 라 layer 축이 없는데, layer 마다 남기려는 slot 이 다르다
- 승(증상) block selection 만으로 GPU recompaction 을 제거할 수 없다. 단순 scheduler trim 은 필요한 KV 를 버린다. 강제 interleaving 에서 old generation + 빈 bitmap 승인(keep-map torn publication)
- 전(원인) P0 셋: 원격 전송 경로에 layer 별 source 필드 없음 · group 공통 GPU 목록으로 layer 별 keep-slot 표현 불가 · keep-map publication 에 process-shared lock 없음
- 결(조치) 순서 = 전송 계약 연결(S0) → block-native 장부(S1) → keep-map v3(S2) → 조건부 clear-legacy(S3) → layer 별 table(S4) → teacher-forced 검증(S5) → 같은 노드 E2E 3회(S6).
COMPACT_METHOD=block은 스위치 하나로 두고 capability 로 경로 결정. 원격 root/home2/qwg724/001_CompressSpec, 분석 snapshotbuild/block_selection_audit_20260916/
| 실험 보고 (2026-09-18) | 판 | 관측 | 판정 | |
|---|---|---|---|---|
| 4.5.7.1 | 03:51 | n82 · 32K · 4B | fullonly=ratio1.0 토큰 9663·5515 일치, accept 수열 1,020 라운드 동일 | 통과 |
| 4.5.7.2 | 03:51 | n83 · 128K · 4B | 토큰 10000·1315 일치, accept 수열 756 라운드 동일 | 통과 |
| 4.5.7.3 | 04:44 | n82 · 128K→256K→420K 한 세션 | 요청 6개 토큰 일치, 420K 정상 종료 | 통과 |
| 4.5.7.4 | 09:51 | Nebius · 128K+256K · 30B | 요청 4개 토큰 일치. accept 은 173라운드에서 갈림(93.540 vs 93.678%) | 미해결 → 이후 4.2 정합 판정에서 4셀 PARITY OK |
| 핸드셰이크 이식본 (fullonly / ratio1.0) | 토큰 | accept | tok/s(prefill 제외) | transfer ms | transfer 블록 | |
|---|---|---|---|---|---|---|
| 4.5.8.1 | 32K n82 req0 | 9,663 | 93.8% | 28.35 / 30.17 | 71.9 / 27.3 | 325 / 111.5 |
| 4.5.8.2 | 128K n83 req0 | 10,000 | 93.9% | 15.12 / 16.00 | 146.4 / 63.0 | 685.5 / 280 |
| 4.5.8.3 | 128K~420K 한 세션 n82 req0 | 1,750 | 85.8% | 15.38 / 16.34 | 152.3 / 75.9 | 716 / 346 |

CompressSpec 정합 버그 (fullonly 대 ratio1.0, L40S 4B) — 해결 8 · 진행 4 · 미착수 2 · 기각 1.
| 상태 | 시각 | 현상 → 조치 | |
|---|---|---|---|
| 4.6.2.1 | 완료 | 09-12 | ratio1.0 전용 KEEP_MAP slack 으로 탈락 토큰이 GPU 에 남음 → 원본 선택 집합만 발행 (COMPACT_KEEPMAP_SLACK=0) |
| 4.6.2.2 | 완료 | 09-12 | draft 의 EOS 제안으로 reload 가 생략돼 미기록 블록에 attention → 거절에 대비해 항상 reload |
| 4.6.2.3 | 완료 | 09-12 | CPU 엔진이 검증 주기를 재프리필로 오인해 GPU 잔존 슬롯 맵을 버림(accept 0/16) → draft 창 이하 축소는 허용 |
| 4.6.2.4 | 완료 | 09-13 | 낡은 슬롯 맵 항목 때문에 확정된 KV 를 재전송하지 않아 256K 두 arm 갈림 → verified_len 이상 항목 HOLE 로 무효화 (DIFFPLAN_ROW0STALE_RESEND) |
| 4.6.2.5 | 미착수 | 09-13 | cpu_verify_server_score.py 가 sampling 입력 세 줄을 안 보내 엔진이 greedy 로 → extra_args 에 draft_logprob_pool_ids·rs_seed·rs_temperature 추가 |
| 4.6.2.6 | 완료 | 09-13 | 진단 코드가 diff 경로에만 비용을 얹어 성능 비교 방향이 뒤집힘(verify +75.1 ms) → 2단계로 강등, 불필요한 복사 제거 (+11.3 ms) |
| 4.6.2.7 | 완료 | 09-13 | 풀이 포화해 한 블록도 못 채우는 것을 계획기가 전송 실패로 오인, full 폴백이 풀을 4,185 → 633 블록으로 되돌림 → 빈 계획 no-op (DIFFPLAN_EXHAUSTED_NOOP) |
| 4.6.2.8 | 진행 | 09-13 | 400K Table QA 3문항이 반복 루프(accept 98.5%) → 도메인 분리 측정 중, 밴드 제외 |
| 4.6.2.9 | 진행 | 09-13 | 잡 취소 직후 재시작한 런이 재현 안 됨 → QUARANTINED_TS 로 격리, 재측정 |
| 4.6.2.10 | 진행 | 09-15 | 400K ratio1.6 첫 런에서 라운드 28% 가 약 4.5 s 정지, 재측정 2회 미재현 → 원인 미특정(HTTP 왕복 위치만) |
| 4.6.2.11 | 기각 | 09-15 | 가설 "batch>1 은 교착 때문에 막혀 있다" → 두 교착은 07-07 해결. batch 1 이유는 KV 용량 |
| 4.6.2.12 | 완료 | 09-15 | batch 32 는 자기 재현 불가 → token 정합을 arm 비교 관문으로 쓰지 않음 |
| 4.6.2.13 | 진행 | 09-15 | CPU verify 는 KV 업로드 라운드에만 호출 → 짧은 컨텍스트 셀 처리량은 CompressSpec 처리량이 아님(원인 규명만) |
| 4.6.2.14 | 완료 | 09-15 | 바깥 상태(잡 번호·노드·경로)가 코드 상수로 굳어 하루 5번 조용히 틀림 → 4곳 수정, squeue 로 읽음 |
| 4.6.2.15 | 미착수 | 09-15 | AIME 셀에서 UPLOAD_TRACE 꺼져 KV 사용률 시계열 없음 → 다음 AIME 판에서 켠다 |
Delta Transfer 결함 (13건, 완료 2) — 원문(문제·현상·원인·조치 4칸)은 원본 7.3 탭.
| ID | 상태 | 심각도 | 내용 | |
|---|---|---|---|---|
| 4.6.4.1 | DT-P1 | 완료 | HIGH | planner padding 을 보존 대상으로 착각, 발행 순서도 pool 순 → 착지 완료 시 keep set 을 selection 으로 한정, argsort 로 token position 순 (keep_map_shm.py, vllm_cpu 5db2aaeb2). 1 GPU 159 라운드 accept 수열 일치 |
| 4.6.4.2 | DT-P2 | 완료 | HIGH | prune_before_landing 뒤 pool 이 survivors ++ delta 인데 keep-map 은 held ++ delta 좌표 → layer 별 held_only 로 ordinal 재사상 (scheduler_recompact.py, vllm a321029c3) |
| 4.6.4.3 | DT-P3 | 기각 | HIGH | min-count 통일 가설 → selector 가 이미 level-up(gpu_model_runner.py:4069), min 을 넣으면 매 라운드 full fallback. COMPACT_MIN_COUNT 되돌림 |
| 4.6.4.4 | DT-P4 | 예정 | HIGH | hybrid(SW layer) 모델에서 layer 별 source 목록이 빈 행 때문에 조용히 flat list 로 fallback → temp_buffer.py:528 길이검사에 if r 통일, warn-once |
| 4.6.4.5 | DT-P5 | 예정 | MEDIUM | 절대 발동하면 안 되는 보정(_PAD_LAYERS·_SLOT_ALIGN)이 늘 켜져 정합 붕괴가 조용히 지나감 → detector 로 격상(KEEP_COUNT_SKEW warn-once, assert) |
| 4.6.4.6 | DT-P6 | 예정 | LOW | 옛 정합 수정의 죽은 스위치·함수(COMPACT_KEEPMAP_SLACK 분기, note_upload, _hole_free) → 삭제, 두 env 는 무조건 적용 |
| 4.6.4.7 | DT-P7 | 예정 | LOW | token mode 가 부분 유효 블록을 전체 보유로 집계 → block mode 미발동, docstring 기록. token mode 폐기 검토 |
| 4.6.4.8 | DT-S1 | 진행 | HIGH | 잠정 종료 요청이 tail 없이 끝나면 보류 landing 이 정리되지 않아 누수 → commit=False 로 폐기 (cpu_verify_engine.py:1993-1997) |
| 4.6.4.9 | DT-S2 | 진행 | HIGH | 잠정 종료 + 미검증 tail 이면 보류 landing 때문에 영구 정지 → landing 을 commit=True 로 먼저 태움 (:1999-2006) |
| 4.6.4.10 | DT-S3 | 예정 | LOW | prune 대기가 reload-stall watchdog 보다 먼저 return → 분기 순서 교체, 경고 방식은 사용자 결정 대기 |
| 4.6.4.11 | DT-S4 | 예정 | MEDIUM | issued=gen 을 landing 성공 전에 보고 → keep-map 캐시, issued 기록을 착지 성공 시점으로 |
| 4.6.4.12 | DT-S5 | 예정 | MEDIUM | staged scatter 가 요청 종료 뒤 남의 블록을 덮어씀 → drain 에 liveness 가드, request_finished 에서 purge |
| 4.6.4.13 | DT-S6 | 예정 | HIGH | capacity precheck 가 'no room' 과 'cannot tell' 을 구분 못 해 엔진 사망 → PrelandVerdict(reuse, evaluated, why) 로 갈라 PARK |
SparseSpec 정합 버그 (SS-01, RunPod RTX PRO 6000) — 원인 확정 · 수정 미적용.
- 기(상황) 정합 판정은 먼저 같은 입력·같은 seed 에서 자기 자신을 재현해야 성립한다
- 승(증상) SparseSpec 은 동일 입력·seed 로 반복해도 출력이 달라진다. vanilla 와의 불일치가 아니라 자기 재현 실패
- 전(원인) 희소 KV 선택의 경계 동점 처리. RAFT radix-select
last_filter()(select_radix.cuh:434-440)가atomicAdd도착 순서로 동점자를 자르므로 스레드 스케줄링에 따라 같은 score 의 다른 KV token 이 선택된다 - 결(조치) 결정적 tie-break 를 넣고 자기 재현을 먼저 통과시킨 뒤 vanilla 와 분포 정합을 검증한다
허락 없이 내린 판단 기록 (CompressSpec 정합 작업, 12건) — 2차 의견(Fable)이 확정한 것과 단독 판단을 구분.
| 시각 | 성격 | 내용 | 근거 · 되돌림 | |
|---|---|---|---|---|
| 4.6.8.1 | 09-12 | 코드 수정 | diff 경로 keep-map 을 full 과 같이 원본 선택 집합만 발행 | Fable 확정 · COMPACT_KEEPMAP_SLACK=1 로 원복 |
| 4.6.8.2 | 09-12 | 코드 수정 | draft 가 EOS 제안해도 CPU→GPU KV 복사 수행 | Fable 확정 · 되돌릴 수 있음 |
| 4.6.8.3 | 09-12 | 코드 수정 | 재프리필 가드가 draft window 이하 감소는 허용 | 단독 판단(로그 관측) · 되돌릴 수 있음 |
| 4.6.8.4 | 09-13 | 방향 변경 | 수정 범위를 정합성 하나로 축소, 검증 프로토콜 재설계 보류 | 사용자 지시 |
| 4.6.8.5 | 09-13 | 방향 변경 | 지시받은 256K 재측정을 보류(거절 위치 어긋난 상태) | 단독 판단 · 이후 nd·pm 단계에서 측정 완료 |
| 4.6.8.6 | 09-13 | 코드 수정 | 확정 범위 이상 보유 항목 전부 무효화(경계 한 칸 → '이상' 일반화) | 일반화는 단독 판단 · DIFFPLAN_ROW0STALE_RESEND |
| 4.6.8.7 | 09-13 | 코드 수정 | diff 전용 진단 비용 3가지 제거 (verify +75.1 → +11.3 ms) | 단독 판단, 20,005 사례 동일 확인 · 되돌릴 수 있음 |
| 4.6.8.8 | 09-13 | 방향 변경 | 성능 비교 기준을 진단 OFF 로. 이전 수치 폐기 | 짝 실험 실측(verify 1,248.9 → 1,192.3 ms) |
| 4.6.8.9 | 09-13 | 수정 후 철회 | GPU 재압축 torch.cuda.synchronize() 2개 제거 시도 | 실측 기각(2,188 vs 2,181 s) · 되돌림 |
| 4.6.8.10 | 09-13 | 코드 수정 | 계획기가 '보낼 것 없음' 과 '못 싣음' 구분 → 빈 계획 no-op | Fable 코드 확인 · DIFFPLAN_EXHAUSTED_NOOP 기본 0 |
| 4.6.8.11 | 09-13 | 방향 변경 | 재현 안 되는 측정 행 1개 전 그림에서 제외 (QUARANTINED_TS) | 단독 판단 · 수집기 한 줄로 복원 |
| 4.6.8.12 | 09-12~13 | 사고 | 사용자가 거부한 실행 명령이 클러스터에서 3번 시작됨(PHASE=ign·sg·rp) | 원인 미상 · PID 트리로 종료, 오염 가능 행 표시 |
백업
유료 클라우드 실험 데이터 백업. 위치 /home/shared/CXL_LLM_SIM_JH/Ai-Cluster-New/Marvell_cloud/. 진행 탭은 30초마다 backup_status.json 을 다시 읽는다. 담당: JH 클라우드 백업 세션.
찾는 법
| 목적 | 방법 | ||
|---|---|---|---|
| 5.1.2.1 | 키워드로 찾기 | `grep -i <모델·버그·노드명> SEARCH_INDEX.tsv \ | cut -f1,3,4` |
| 5.1.2.2 | 디렉토리를 정한 뒤 | README.md 색인 표 → 그 디렉토리 ENVIRONMENT.md | |
| 5.1.2.3 | 압축본 안(018~021) | .tar.zst.list 를 grep → tar -I zstd -xf <압축본> <파일> 로 그 파일만 푼다 | |
| 5.1.2.4 | 디렉토리별 한 줄 요약 | CATALOG.md (아래 5.2) |
복원 시나리오
| 시나리오 | 절차 | |
|---|---|---|
| 5.1.4.1 | 결과·그림 다시 보기 (016) | 016…/data/results/plot_*.py, 공통 style plot_style.py |
| 5.1.4.2 | 결과·그림 다시 보기 (017) | 017…/data/workspace/cs/results_archive/make_bundle.sh → bundle 안 redraw.sh. RUNROOT·LIB 를 백업 경로로 |
| 5.1.4.3 | 실험 재현 | _repro/README.md §1 한눈 표 → RUN_RECIPES.md → ENV_VARS.md |
| 5.1.4.4 | 환경 복원 (docker) | _docker/README.md §1, Docker Hub private junhyeong0724/marvell-tandemspec tag 3개 |
| 5.1.4.5 | 환경 복원 (Nebius conda) | 015…/data/miniforge3_tar/*.tar.zst 를 원래 prefix(/mnt/filesystem-h8/miniforge3)에서 푼다. pkgs 는 data/miniforge3_pkgs/ |
| 5.1.4.6 | 환경 복원 (RunPod env) | 017…/data/workspace/cs/backup/env-*.tar.zst 를 RESTORE.md 대로. zstd -d 먼저 |
| 5.1.4.7 | 코드 | Nebius 015…/data/CompressSpec·data/cs/sparsespec_git·data/cs/noamx, RunPod 017…/data/workspace/{CompressSpec,repo} |
| 5.1.4.8 | 모델 weight | 015…/data/cs/{models,hf}, 017…/data/workspace/{models,cs/models,cs/hf} |
원문 /home/shared/CXL_LLM_SIM_JH/Ai-Cluster-New/Marvell_cloud/HOW_TO_USE.md
Marvell_cloud/ 디렉토리 한 개가 한 행. 크기는 015·017·018~021·_docker 기록값, 나머지 2026-09-27 du -sh.
| 번호·이름 | 무슨 실험·자료 | 클라우드·노드·GPU | 측정일 | 크기 | 핵심 파일 | 주의 | |
|---|---|---|---|---|---|---|---|
| 5.2.2.1 | 001_rtx_pro6000_sweep | 장문 컨텍스트 compaction 스윕 29셀 (128K·256K·420K × arm) | Nebius RTX PRO 6000 ×1 | 2026-09-18~20 | 676 MB | data/rtx_cells.json · data/raw/rtx_raw.tgz · script/collect_cells.py | |
| 5.2.2.2 | 002_tandemspec_saturate_throughput | TandemSpec saturate 처리량 (AIME25 batch 4~64) | Nebius RTX PRO 6000 ×1 | 2026-09-19~21 | 582 MB | data/results/*.console·*.csv · data/_run_headers.txt | |
| 5.2.2.3 | 003_saturate_socket1_omp_smt | saturate 소켓 1 · OMP 21~64 · SMT 비교 (batch 4) | Nebius RTX PRO 6000 ×1 | 2026-09-20 | 1.1 MB | data/results/*.console · data/_run_headers.txt | 002 와 같은 하니스 |
| 5.2.2.4 | 004_granite_30b_batch_sweep | Granite 4.2-30B batch 스윕 (vanilla vLLM 대 SparseSpec, AIME25) | Nebius RTX PRO 6000 ×1 | 2026-09-20~21 | 189 MB | data/_cells_summary.csv · data/<arm>_<ts>/ | |
| 5.2.2.5 | 005_magistral_24b_batch_sweep | Magistral-Small-2509 batch 스윕 (vanilla vLLM 대 SparseSpec) | Nebius RTX PRO 6000 ×1 | 2026-09-20~21 | 382 MB | data/_cells_summary.csv · data/<arm>_<ts>/ | |
| 5.2.2.6 | 006_qwen3_4b_batch_sweep | Qwen3-4B-Thinking batch 스윕 + RunPod 판 b16·b32·b64 | Nebius RTX PRO 6000 ×1 · RunPod | 2026-09-20~21 | 1.5 GB | data/<arm>_<ts>/ · data/runpod_sweep_20260921/ | |
| 5.2.2.7 | 007_longcontext_4way | 장문 컨텍스트 4-way (CompressSpec·NEO·HeadInfer) | Nebius RTX PRO 6000 ×1 | 2026-09-21~22 | 378 MB | data/results_archive.csv(77행) · data/{long,medium,breakdown}/ | e2e_kind=modeled 행은 모델링 값 |
| 5.2.2.8 | 008_diagnostics | Nebius 박스 진단 (ISPC·cap 탐색·membw·gate) | Nebius RTX PRO 6000 ×1 | 2026-09-20~21 | 362 MB | 진단 .sh 76 · .py 17 · 로그 115 · ispc/ | |
| 5.2.2.9 | 009_compressspec_figures | 논문 01_intro 그림 스크립트 | 미기록 (vast.ai 추정) | 미기록 | 88 KB | data/01_intro/*.py · data/script/*.sh | 측정 데이터 없음 |
| 5.2.2.10 | 010_aime_kv_pruning | AIME25 prefill KV pruning (StreamingLLM·H2O·SnapKV × 25/50/75%) | Nebius RTX PRO 6000 (25%) · ai-cluster n88 H200 | 2026-09-23 | 19 MB | data/*/summary.jsonl · script/plot_ratio_aime.py | |
| 5.2.2.11 | 011_medium144_sparsespec_b1 | SparseSpec batch 1 · medium144 144개 | Nebius 81.85.4.145 RTX PRO 6000 ×8 | 2026-09-24~25 | 1.2 GB | data/<ts>/per_request.csv·totals.csv | 주의 LOG_SS=2 TPOT·E2E 부풀림, 사용 금지 |
| 5.2.2.12 | 012_granite_medium20_sparsespec_b1 | SparseSpec batch 1 · Granite 4.2-30B · Medium 20개 | Nebius 81.85.4.145 RTX PRO 6000 ×8 | 2026-09-25 | 150 MB | data/<ts>/per_request.csv·totals.csv · figs/ | 주의 LOG_SS=2 TPOT·E2E 부풀림, 사용 금지 |
| 5.2.2.13 | 013_vanilla126_temp0_cap8192 | vanilla vLLM · Qwen3-30B-A3B · temp 0 · LongBench-v2 medium 126개 | Nebius 81.85.4.145 RTX PRO 6000 ×8 | 2026-09-25 | 832 KB | data/20260925_061459/per_request.csv·totals.csv | |
| 5.2.2.14 | 014_ss20_temp0_chunk1024 | SparseSpec batch 1 · temp 0 · chunk 1024 · LOG_SS=1 · 20개 | Nebius 81.85.4.145 RTX PRO 6000 ×8 | 2026-09-25 | 95 MB | data/20260925_070231/per_request.csv·totals.csv | |
| 5.2.2.15 | 015_nebius_h8_raw_mirror | Nebius filesystem-h8 원천 전체 mirror + 코드·models·hf·conda env 8개·pkgs | Nebius CPU 81.85.2.64 (/mnt/filesystem-h8) | 2026-09-17~25 측정, 09-26 백업 | 약 206 GB | data/cs/run/ · data/CompressSpec · data/miniforge3_tar/*.tar.zst | perf .data 3개 권한 없어 못 받음 |
| 5.2.2.16 | 016_ysshin_rtxpro6000_results | ysshin 논문 평가 정리 결과 + CLAUDE_DOCS | RTX PRO 6000 (Nebius) · 사본 출처 ai-cluster | 2026-09-2x | 77 MB | data/results/plot_*.py · script/CLAUDE_DOCS/ | |
| 5.2.2.17 | 017_runpod_pro6000_workspace_mirror | RunPod /workspace 원천 mirror + CompressSpec 트리·.so·models·env tar 4개 | RunPod CPU pod 66.92.198.82:11946 (측정은 RTX PRO 6000 pod) | 2026-09-08~21 측정, 09-26 백업 | 154 GB | data/workspace/cs/PLAYBOOK.md · cs/backup/env-*.tar.zst·RESTORE.md | env/(34 GB) 제외, env tar 와 중복 |
| 5.2.2.18 | 018_aicluster_breakdown_debugger | CompressSpec phase breakdown·compaction·accept 디버깅 dump 전부 | ai-cluster L40S(n81·n84)·H200(n88) 등 · g07 | 2026-05~09 | 압축 16.8 GB (원천 100.7 GB) | .tar.zst 41개 + .list · logs/verify_summary.txt | 2차 10개 md5 는 표본 대조 |
| 5.2.2.19 | 019_aicluster_dump_debugger | accept·score·block·metadata dump, saturate 로그, run10·sweep_test | ai-cluster L40S(n81~n86)·RTX 6000 Ada(n61) · g07 | 2026-05~09 | 압축 0.97 GB (원천 2.77 GB) | .tar.zst 11개 + .list | 로그에 HF_TOKEN 평문, 외부 공유 금지 |
| 5.2.2.20 | 020_aicluster_baseline | SparseSpec vs vanilla vLLM baseline (RULER·AIME·LiveCodeBench·Olympiad·LongContext) · pruning 정확도 | ai-cluster L40S·RTX 6000 Ada·H200 | 2026-06~09 | 압축 2.7 GB (원천 16.2 GB) | .tar.zst 19개 + .list | archive/results md5 표본 8% |
| 5.2.2.21 | 021_aicluster_judge_debugger | 3-mode acceptance (standard·dual·cactus·tas) 결과·dump·dump_archive | ai-cluster n90 H200 ×2 · n92 H200 NVL | 2026-07 | 압축 54.8 GB (원천 248.1 GB) | 세션별 .tar.zst 50개 · logs/judge_dump_sizes.tsv | 2차 md5 표본 대조 |
| 5.2.2.22 | 022_compaction_sweep_monitor | Compaction Sweep Monitor 현황판(job 9f4386c4) 페이지·생성 스크립트 | g07 job tmp | ~2026-09-23 | 313 MB | data/job_9f4386c4_tmp/serve/index.html · figs/(54장) | |
| 5.2.2.23 | _repro | 재현 키트: 러너 스크립트·env 전수·빌드·실행법 | Nebius·RunPod 러너 사본 | 2026-09-26 | 6.7 MB | README.md §1 · RUN_RECIPES.md · ENV_VARS.md · BUILD.md | ~/mrun/scripts/ 원본 소실 (scripts/nebius_1.51_mrun/RECOVERY.md) |
| 5.2.2.24 | _docker | Nebius sm_120 기준 docker 이미지 3개 (tandemspec·neo·headinfer) | g07 cross-compile · Docker Hub junhyeong0724/marvell-tandemspec | 2026-09-26 | 이미지 압축 26.5 GB (11.7+7.7+7.2) | README.md §1 · images/*.tar.zst·SHA256SUMS | sm_120·AMX 실제 실행 미확인 |
원문 /home/shared/CXL_LLM_SIM_JH/Ai-Cluster-New/Marvell_cloud/CATALOG.md
문서화
- 문제 문서 설계·코드 청소·환경설정 작업의 현재 상태를 빠르게 확인해야 한다.
- 현상 환경변수 300개 중 DELTA 42개는 적용했고, 나머지 258개는 계획이다.
- 원인 이전 설계와 적용 결과가 같은 본문에 섞여 있었다.
- 결과 현황은 아래 표, 변수 조회는 6.4, 문서 예시는 6.99에서 확인한다.
| 작업 | 상태 | 다음 확인 | 위치 | |
|---|---|---|---|---|
| 6.0.2.1 | Accelerator porting 문서 구조 | 설계 | Delivery revision과 vendor capability | 6.1 |
| 6.0.2.2 | DELTA 환경변수 정리 | 적용 (env_clean) | 16K/32K acceptance 진행 중 | 6.2 |
| 6.0.2.3 | 나머지 환경변수 258개 | 계획 | Category별 이행과 검증 | 6.4 |
| 6.0.2.4 | 주석·진단 코드·출력 경로 정리 | 계획 | 적용 범위를 나누어 검증 | 6.2 |
| 6.0.2.5 | Profile·test suite | 설계 | 설정 우선순위와 suite 계약 | 6.3 |
| 6.0.2.6 | Sidebar·예시 페이지 두 개 | 검토용 초안 | Porting 독자의 navigation | 6.99 |
- 기준 Astra 재설계(2026-09-30, 대상: custom accelerator 회사의 porting 엔지니어). 원문
.handoff/docs_v2/RESULT.md
- 목적은 accelerator 엔지니어가 TandemSpec을 이해하고, reference hardware에서 실행한 뒤, 담당할 device role을 이식하고 검증하도록 돕는 것이다.
- 구성은 Overview → Run on reference hardware → Hardware contracts → Porting guides → Validation and performance → Reference로 정한다.
- Draft role·Verify role·두 role을 맡는 경우는 같은 contract를 사용하고, 필요한 페이지 경로만 달리한다.
- 아래는 문서 설계이며, 새 device backend가 이미 구현됐다는 뜻은 아니다.
첫 진입과 완료 기준
처음에는 전체 개념 문서를 읽지 않아도 시작할 수 있게 한다. Overview에서 reference 실행, device role 선택, component map으로 바로 이동한다.
| 독자의 질문 | 첫 페이지 | 얻어야 하는 답 | |
|---|---|---|---|
| 6.1.5.1 | TandemSpec은 무엇을 하는가 | TandemSpec at a glance | Selected KV로 draft하고 full-context KV로 verify하는 구조 |
| 6.1.5.2 | 현재 구현을 먼저 실행할 수 있는가 | Prerequisites and supported configurations | 검증된 software·model·hardware 조합과 필요한 자원 |
| 6.1.5.3 | 우리 chip은 어느 일을 맡는가 | Choose device roles | Draft·Verify·두 role의 책임과 필요한 capability |
| 6.1.5.4 | 무엇을 구현하거나 연결해야 하는가 | Hardware-dependent component map | Component별 입력·출력·invariant·현재 코드·검증 항목 |
| 6.1.5.5 | 이식이 맞는지 어떻게 확인하는가 | Component conformance → Numerical behavior → Lifecycle | 구조 정합성·수치 동작·통합 동작의 검증 결과 |
| 6.1.5.6 | 성능이 충분한가 | Measure and tune performance | 같은 workload에서 측정한 latency·throughput·memory·transfer |
| 6.1.5.7 | 어디까지 지원한다고 말할 수 있는가 | Port acceptance report | Role·model·dtype·shape·동시성별 검증 범위와 제한 |
최종 sidebar와 페이지 책임
총 36개 페이지로 구성한다. Category는 메뉴 묶음이며 별도 본문 페이지를 추가하지 않는다.
| 부 | ID | 페이지 | 핵심 내용 | |
|---|---|---|---|---|
| 6.1.8.1 | Overview | O1 | TandemSpec at a glance | 엔진 원리, reference와 port의 구분, 시작 경로 |
| 6.1.8.2 | Overview | O2 | Request lifecycle | Resident·speculative mode, prefill, verify, commit, 종료 |
| 6.1.8.3 | Overview | O3 | Recompression and delta transfer | 재선택, recall gate, missing KV 전송, 적용 확인 |
| 6.1.8.4 | Overview | O4 | Correctness model | Target distribution, greedy·sampling, 수치 가정, 검증 범위 |
| 6.1.8.5 | Overview | O5 | Terminology | Role·mode·cache identity·통계·metric 용어 |
| 6.1.8.6 | Run on reference hardware | R1 | Prerequisites and supported configurations | 검증된 구성, 자원, toolchain, model, 제한 |
| 6.1.8.7 | Run on reference hardware | R2 | Build the environments and prepare a model | 두 environment, kernel build, model·tokenizer, 설정 확인 |
| 6.1.8.8 | Run on reference hardware | R3 | Run your first verified request | 시작 순서, 실제 verify 실행, committed output, 종료 |
| 6.1.8.9 | Run on reference hardware | R4 | Capture a reference baseline | Resident·speculative 실행과 비교용 evidence 저장 |
| 6.1.8.10 | Run on reference hardware | R5 | Troubleshoot a reference run | Build·layout·verify·output·hang·성능 문제의 경계별 진단 |
| 6.1.8.11 | Hardware contracts | H1 | Choose device roles | Role별 책임과 vendor capability 확인 |
| 6.1.8.12 | Hardware contracts | H2 | Hardware-dependent component map | C01–C17의 소유자·의존성·guide·test |
| 6.1.8.13 | Hardware contracts | H3 | Device-contract specification | Component contract의 공통 schema |
| 6.1.8.14 | Hardware contracts | H4 | KV memory model | Logical position, physical block, slot, layout, 수명 |
| 6.1.8.15 | Hardware contracts | H5 | Communication and synchronization | Control·tensor 경로, completion, ack, 재사용 순서 |
| 6.1.8.16 | Porting guides | P1 | Bring up the runtime and model execution | Runtime·allocation·model runner·eager 실행 |
| 6.1.8.17 | Porting guides | P2 | Supply model operators | 선택한 model의 전체 operator coverage |
| 6.1.8.18 | Porting guides | P3 | Port draft attention and long-context prefill | Selected attention, streamed prefill, 초기 selection |
| 6.1.8.19 | Porting guides | P4 | Port verify attention | Full-context attention, query 정렬, score·LSE |
| 6.1.8.20 | Porting guides | P5 | Adapt KV layouts and transfers | Packing·변환·shared buffer·DMA·completion |
| 6.1.8.21 | Porting guides | P6 | Port recompression and cache updates | Gate·selection·repack·delta·rearrange·ack |
| 6.1.8.22 | Porting guides | P7 | Preserve sampling and attention statistics | Distribution payload, sampling, score·LSE 의미 |
| 6.1.8.23 | Porting guides | P8 | Enable graphs, batching, and concurrency | Graph replay, batch, request 격리, 실행 순서 |
| 6.1.8.24 | Validation and performance | V1 | Run component conformance tests | Component별 invariant와 실패 입력 검증 |
| 6.1.8.25 | Validation and performance | V2 | Validate numerical behavior and sampling | Tensor 비교, greedy, sampling fixture, 분포 검증 |
| 6.1.8.26 | Validation and performance | V3 | Validate request lifecycle and recovery | Mode 전환, reject, 종료, 취소, 동시 요청, 복구 |
| 6.1.8.27 | Validation and performance | V4 | Measure and tune performance | 측정 경계, warmup, 계측 비용, 병목, tuning |
| 6.1.8.28 | Validation and performance | V5 | Interpret the reference results | Figure별 조건·결과·제한·재현 evidence |
| 6.1.8.29 | Validation and performance | V6 | Assemble the port acceptance report | 지원 조합, 검증 결과, 성능, 미해결 사항 |
| 6.1.8.30 | Reference | F1 | CLI | 명령·인자·dispatch·종료 상태 |
| 6.1.8.31 | Reference | F2 | Engine and connector configuration | Field·단위·default·상호 제약 |
| 6.1.8.32 | Reference | F3 | Environment variables | 소유자·read point·유효값·진단 비용 |
| 6.1.8.33 | Reference | F4 | Verify control API | Endpoint·request·response·identity·error |
| 6.1.8.34 | Reference | F5 | Tensor layouts and shared buffers | KV·distribution·score·LSE·retention map의 표현 |
| 6.1.8.35 | Reference | F6 | Outputs and metric definitions | 결과 schema와 token·byte·time·memory 정의 |
| 6.1.8.36 | Reference | F7 | Release compatibility and limitations | Component 조합, 검증 범위, 제한, migration |
Role별 읽기 경로
Role을 아직 결정하지 않았어도 reference 실행과 component 조사는 진행할 수 있다.
| 경로 | 공통 시작 | 주로 필요한 guide | 추가 확인 | |
|---|---|---|---|---|
| 6.1.11.1 | Draft role | O1 → R1–R4 → H1 → H2 | P1–P3·P5·P7·P8 | P6의 device cache rearrangement |
| 6.1.11.2 | Verify role | O1 → R1–R4 → H1 → H2 | P1·P2·P4–P8 | Attention 외 전체 target model 실행 |
| 6.1.11.3 | 두 role | 같은 시작 경로 | 두 role의 guide 전체 | 같은 chip에서도 소유권·completion·ack 유지 |
| 6.1.11.4 | Role 미정 | O1 → H1 → H2 | Capability worksheet | Runtime·memory·operator·통계 출력 능력 확인 |
이 구성을 고른 이유
- Porting을 기존 Guides 뒤에 추가하면 hardware 의존성이 설치·개념·porting 문서에 나뉘어 독자가 경계를 다시 조립해야 한다.
- 별도 user entrance와 porting entrance를 만들 필요는 없다. 이번 전달 대상은 accelerator 엔지니어이며, 실제 분기는 담당할 device role이다.
- Mechanism 설명은 O2·O3에서 제공하고, 각 contract와 guide가 필요한 설명으로 연결한다.
- 이 결정은 수신자가 실제 backend 이식 책임을 가진다는 가정에 의존한다. 완성된 backend의 운영만 맡는다면 navigation 검증에서 이 가정이 틀렸는지 확인한다.
공통 용어
Role·mode·environment와 logical identity·physical placement를 구분한다. Code 이름은 source 연결과 검색 alias로 남긴다.
| 사용할 용어 | 뜻 | 구분할 기존 표현 | |
|---|---|---|---|
| 6.1.15.1 | Draft role / Verify role | 토큰 제안 / full-context target 검증 책임 | GPU side / CPU side |
| 6.1.15.2 | Draft device / Verify device | 해당 role을 실행하는 hardware | Reference GPU / CPU와 구분 |
| 6.1.15.3 | Draft environment / Verify environment | Role을 실행하는 software 설치 | 실행 mode와 구분 |
| 6.1.15.4 | Resident mode | 필요한 KV가 draft device에 있어 speculative verify 없이 실행 | Bypass |
| 6.1.15.5 | Speculative mode | Draft window를 verify하고 결과를 commit하는 실행 | Compressed mode |
| 6.1.15.6 | Verification round | Draft window와 verify·commit 결과의 한 주기 | Cycle / decode step의 모호한 사용 |
| 6.1.15.7 | Selected KV cache | Draft가 사용하는 KV 부분집합 | Compressed KV / sparse KV |
| 6.1.15.8 | Recompression | 이후 draft에 사용할 KV를 다시 선택 | 선택 의미의 compaction |
| 6.1.15.9 | Cache repacking | KV의 물리적 배치나 packing 변경 | 이동 의미의 compaction |
| 6.1.15.10 | Retained set | Draft device에 있다고 확인된 논리적 KV 집합 | Held set |
| 6.1.15.11 | Residency ledger | Confirmed·pending KV와 generation을 추적하는 상태 | Index map |
| 6.1.15.12 | Retention map | 기존 cache slot 중 살아남는 위치를 나타내는 metadata | Keep map |
| 6.1.15.13 | Applied generation | 소비 장치에서 사용할 수 있다고 확인된 update 세대 | Landed generation |
| 6.1.15.14 | Draft distribution payload | Draft sampling 분포를 복원하는 데이터 | Logprob pool이라는 이름만으로 표현을 단정하지 않음 |
| 6.1.15.15 | Selection threshold | 남길 KV를 선택하는 목표 | Selection의 τ |
| 6.1.15.16 | Recall threshold | 현재 selected KV를 갱신할지 정하는 기준 | Gate의 τ |
| 6.1.15.17 | Retained KV fraction | 동일 기준의 selected KV / full-context KV | 보존 비율 |
| 6.1.15.18 | KV reduction fraction | 같은 기준에서 1 − retained fraction | 제거 비율 의미의 compression rate |
| 6.1.15.19 | KV-pool utilization | 사용 중인 KV pool / 가용 KV pool | Cache 보존 비율과 구분 |
| 6.1.15.20 | Correction token / Bonus token | 첫 reject 위치의 교정 / all-accept 뒤 조건부 추가 토큰 | Target token을 무조건 같은 의미로 쓰지 않음 |
표기 규칙
- Hardware 일반 설명에는 role 이름을 쓰고, 현재 구현 설명에 NVIDIA GPU·Intel CPU·CUDA·AMX 등을 쓴다.
- Logical token position, physical block ID, cache slot을 바꾸어 쓰지 않는다.
- Selection threshold와 recall threshold는 별도 설정으로 설명한다. 특정 recipe에서 같게 둘 수는 있다.
- Ratio에는 분자·분모·단위·layer/group 집계·padding 처리 방식을 적는다.
- Upload·download 대신 출발 memory와 도착 memory를 적는다.
- Lossless 설명에는 target distribution과 numerical assumption을 함께 적는다.
- 문서상 contract를 이미 존재하는 plugin API처럼 표현하지 않는다.
Device contract
각 component는 입력·출력만 아니라 memory 수명과 completion 조건까지 정의한다. Reference에서 확인한 동작과 target에서 검증한 동작은 별도 상태로 기록한다.
| 항목 | 반드시 기록할 내용 | |
|---|---|---|
| 6.1.19.1 | Identity / applicability | Contract ID, role, mode, 필수 feature |
| 6.1.19.2 | Source / status | Revision·file·symbol·caller·consumer, 검증 상태 |
| 6.1.19.3 | Inputs / outputs | 수학적 의미, shape, dtype, stride, packing, valid length |
| 6.1.19.4 | Memory ownership | Allocator·writer·reader·alias·capacity·재사용 조건 |
| 6.1.19.5 | Ordering | Submitted·ready·applied·acknowledged의 의미 |
| 6.1.19.6 | Invariants | Identity·state·bounds와 허용되는 수치 차이 |
| 6.1.19.7 | Capability / failure | 지원 shape·dtype·batch·graph, 오류·fallback·cleanup |
| 6.1.19.8 | Validation | Fixture·비교 방법·통과 기준·evidence |
| 6.1.19.9 | Performance | 계산량·byte·시간 경계·temporary memory·계측 비용 |
| 6.1.19.10 | Open facts | 미확정 질문·담당자·막힌 페이지 |
Hardware-dependent component 목록
D는 Draft role, V는 Verify role, H는 host/control 책임이다. 아래 code 좌표는 component 경계를 찾는 출발점이며 delivery release에서 다시 묶는다.
| ID | Component | 적용 | 주요 code 좌표 | 검증 핵심 | |
|---|---|---|---|---|---|
| 6.1.22.1 | C01 | Runtime and backend integration | D/V | platforms, worker/model runner | Eager forward와 자원 정리 |
| 6.1.22.2 | C02 | Whole-model operators | D/V | model_executor, CPU oneDNN dispatch | Operator→layer→model 비교 |
| 6.1.22.3 | C03 | Draft attention | D | FlashInfer backend와 patched decode kernel | Selected KV·mask·position |
| 6.1.22.4 | C04 | Long-context prefill and initial selection | D/H | FlashInfer prefill, kv_transfer_utils | Chunk 경계와 full KV 보존 |
| 6.1.22.5 | C05 | Verify attention | V | cpu_attn.py, cpu_attn*.hpp | Full context와 query/group 정렬 |
| 6.1.22.6 | C06 | Attention statistics | D/V/H | Score/LSE export와 reader | Base·normalization·validity |
| 6.1.22.7 | C07 | Sampling and distribution transport | D/V/H | logprob_worker, verify sampling | Payload 표현과 p/q 정렬 |
| 6.1.22.8 | C08 | KV physical representation | D/V/H | amx_kv_layout, cache kernels | Packing과 정확한 round trip |
| 6.1.22.9 | C09 | Shared buffers and transfers | D/V/H | cpu_gpu, shared-memory handlers | Completion과 buffer 수명 |
| 6.1.22.10 | C10 | Device cache rearrangement | D/H | gpu_recompact, scheduler_recompact | 겹치는 이동과 늦은 재사용 |
| 6.1.22.11 | C11 | Selection, recall gate, host repacking | V/H | _should_compact, _compact_kv_cache, compact_amx_kernel | Gate 경계와 selection oracle |
| 6.1.22.12 | C12 | Delta ledger and retention publication | D/V/H | index_map, keep_map_shm, keep_map_reader | Generation·ack·publication 순서 |
| 6.1.22.13 | C13 | Verify control and lifecycle | H/D/V | Verify server, dispatcher, channels | Request·job·group·commit 정렬 |
| 6.1.22.14 | C14 | Execution ordering and graphs | D/V/H | cuda_graph, transfer hooks, _lse_sync | Eager/graph 동등성과 write 완료 |
| 6.1.22.15 | C15 | Host threading and memory placement | H/V | CPU platform, OpenMP, NUMA allocation | 실제 affinity와 memory placement |
| 6.1.22.16 | C16 | Timing and observability | D/V/H | Breakdown·trace·output writer | 비동기 시간 경계와 byte 계산 |
| 6.1.22.17 | C17 | Parallel execution and collectives | 조건부 | Communicator, distributed, rank별 buffer | 합의된 multi-device 구성만 검증 |
조사에서 확인한 contract 주의점
- Verify role은 attention만이 아니라 target model 전체를 실행한다. Attention kernel 제공만으로 verify port가 완성되지는 않는다.
- AMX KV packing은 vector 경로와 다르다. 같은 tensor shape라는 이유로 byte layout이 같다고 볼 수 없다.
- 확인한 draft logprob worker는 raw bf16 logits를 전송한다. 이전 자료의 log-probability 설명과 delivery release에서 대조해야 한다.
- Recall gate는 draft log2 LSE를 natural-log 기준으로 바꿔 비교한다. Query·layer·head 정렬과 aggregation도 contract에 포함한다.
- LSE completion helper에는 worker와 scheduler가 같은 Python interpreter에 있다는 가정이 있다. Process 구성이 바뀌면 다시 검증해야 한다.
- Graph replay에서는 일반 layer decorator의 transfer 부작용이 자동으로 실행되지 않아 별도 hook이 필요하다.
- KV update는 payload 완료, metadata 공개, 적용, ack, 재사용으로 나누어 설명한다.
- Keep-map generation 검사와 고정 capacity는 source를 확인하되, 주석만으로 publication race가 없다고 결론 내리지 않는다.
- Native compaction JIT의 -march=native는 build host와 실행 host의 호환성 확인이 필요하다.
Figure 배치와 수정 사항
그림은 설명의 목적에 맞는 페이지에 배치한다. 결과 수치에는 해당 experiment의 model·hardware·configuration·metric 정의를 연결한다.
| Figure | 배치 | 처리 | |
|---|---|---|---|
| 6.1.26.1 | overview3 | O1·H1 | 첫 구조 그림으로 사용하고 payload 생략과 bonus 조건을 설명 |
| 6.1.26.2 | overview2 | P3·O2 | Layer/chunk prefill 상세에 사용 |
| 6.1.26.3 | timeline2 | V5·O2 | 개념적 schedule과 memory 비교로 설명 |
| 6.1.26.4 | Optimize | O3·P6 | 그대로 사용. recall check 는 all-accept window 뒤에만 돈다는 조건을 본문에 적음 |
| 6.1.26.5 | fig-aime-kv-budget-accuracy | O1 상세·V5 | 압축 검증의 동기를 설명하고 port 정합성 증거와 구분 |
| 6.1.26.6 | fig-batch-vs-kv-budget | H4·V5 | Capacity 계산 또는 측정의 가정을 확인 |
| 6.1.26.7 | latency_v3 | V5·V4 | TTFT·TPOT·E2E와 OOM 조건 연결 |
| 6.1.26.8 | throughput_routing | V5·V3 | Throughput와 requests-in-flight를 구분 |
| 6.1.26.9 | analysis_mean | V5·V4 | Gate 결과와 round-time의 대표 설명 |
| 6.1.26.10 | analysis | V5 상세 | Context별 결과와 측정 설정 연결 |
| 6.1.26.11 | compression_mean | V5·H4 | KV reduction fraction으로 뜻을 명시 |
| 6.1.26.12 | ablation | V5 | Brief와 다른 수치를 raw result로 대조한 뒤 사용 |
| 6.1.26.13 | sensitivity | V4·V5 | w와 threshold의 의미·설정·OOM 조건 연결 |
| 6.1.26.14 | fig-appx-delta-rounds | P6·V5 | α·limit·block size·정책 정의 후 사용 |
Figure에서 발견한 불일치
- Optimize 그림은 올바르다: Recall < τ 가 yes 면 recompression, no 면 Skip GPU KV update. (앞선 'yes/no 반대' 지적은 오판, 2026-09-30 그림 확인)
- Optimize에는 모든 draft가 accepted된 경우에만 skip을 고려한다는 조건도 추가해야 한다.
- Ablation PDF는 1.00→2.28→2.44→2.54배이고 brief는 1.00→2.46→2.53→2.62배다. 둘 중 하나를 임의로 채택하지 않는다.
- Compression mean의 97.4%·89.9%는 제거 비율이다. 보존 비율 및 KV-pool utilization과 별도 metric으로 설명한다.
- Overview의 token arrow는 전체 verification payload를 생략한 표현이다. 필요한 distribution·statistics·completion은 contract로 연결한다.
완성 전에 받아야 할 사실
문서 구조는 지금 확정할 수 있다. 아래 답은 해당 component의 실제 명세와 acceptance 기준을 완성하는 데 필요하다.
| 담당 | 받아야 할 사실 | 영향 | |
|---|---|---|---|
| 6.1.30.1 | Vendor | Draft·Verify·두 role 중 목표와 prefill 배치 | Guide 적용 범위 |
| 6.1.30.2 | Vendor | Runtime·compiler·framework integration | Build와 model 실행 |
| 6.1.30.3 | Vendor | Model operator·dtype·accumulation·quantization | 전체 model coverage와 수치 기준 |
| 6.1.30.4 | Vendor | Attention shape·mask·GQA·score/LSE 출력 | Attention와 recompression 연결 |
| 6.1.30.5 | Vendor | Memory capacity·DMA·pinning·coherence·completion | KV layout·transfer·synchronization |
| 6.1.30.6 | Vendor | Graph·batch·concurrency·multi-device 요구 | 최적화와 lifecycle 검증 |
| 6.1.30.7 | Engine team | Launcher·server·두 engine·kernel의 delivery revision | 문서의 실제 지원 조합 |
| 6.1.30.8 | Engine team | Distribution payload와 sampler semantics | Sampling 정합성 |
| 6.1.30.9 | Engine team | Selection·recall 설정과 aggregation | Mechanism 설명과 configuration |
| 6.1.30.10 | Engine team | Layout·block size·keep-map limit·publication 보장 | Device contract |
| 6.1.30.11 | Engine team | Figure별 raw result와 수정 asset | 결과 문서의 신뢰성 |
| 6.1.30.12 | 공동 | Numerical acceptance, workload, latency·throughput·memory 목표 | Port acceptance report |
| 6.1.30.13 | 공동 | Model·tokenizer 전달 및 실행 절차 | 외부에서 가능한 reference 실행 |
작성 순서와 검증
각 단계는 독립적으로 확인할 수 있는 산출물을 남긴다. Engine 구현 변경은 이 문서 설계의 범위에 포함하지 않는다.
| 순서 | Tier | 작업 | 완료 신호 | |
|---|---|---|---|---|
| 6.1.33.1 | B1 | routine | Delivery source bundle 고정 | 모든 claim에 source 또는 미확정 항목 연결 |
| 6.1.33.2 | B2 | routine | 36개 page manifest와 role 경로 작성 | Sidebar·page·cross-link 일치 |
| 6.1.33.3 | B3 | routine | Glossary와 alias 적용 | 기존 code 이름으로 올바른 용어 검색 |
| 6.1.33.4 | B4 | judgment | Role 책임과 C01–C17 contract 확정 | 구현할 항목·소유자·test가 명확 |
| 6.1.33.5 | B5 | routine | Reference 실행 경로 작성 | 실제 verify 요청과 evidence 확보 |
| 6.1.33.6 | B6 | routine | 8개 porting guide 작성 | 각 guide가 contract test로 끝남 |
| 6.1.33.7 | B7 | routine | Release reference 연결 | Producer·consumer schema와 유효 설정 확인 |
| 6.1.33.8 | B8 | judgment | Figure·numerical·performance claim 대조 | 그림과 acceptance 기준의 근거 확보 |
| 6.1.33.9 | B9 | routine | 6.1 교체 | 허용 markdown으로 단독 검토 가능 |
| 6.1.33.10 | B10 | routine | Navigation·정합성·공개 범위 검증 | Role별 독자가 작업 경로를 찾음 |
Acceptance에서 반드시 확인할 사례
- 기존 문서처럼 hardware가 고정된 것으로 보이거나 porting 항목이 없어 구현 범위를 찾지 못하는 문제가 재발하지 않아야 한다.
- Verify role만 맡는 독자는 CPU attention만 바꾸면 된다고 결론 내리지 않아야 한다.
- Draft role만 맡는 독자는 verifier를 이식하지 않고도 자신이 지켜야 할 layout·payload·completion 계약을 찾아야 한다.
- DMA가 늦게 끝나는 경우 control message가 먼저 처리돼 미완료 tensor를 읽지 않아야 한다.
- 같은 shape지만 다른 AMX/vector packing은 layout 검증에서 구분해야 한다.
- Delta payload가 비어 있어도 retention 적용과 generation 처리는 필요할 수 있음을 설명해야 한다.
- Graph replay에서 transfer hook이 빠진 구현은 eager 성공만으로 통과하지 않아야 한다.
- 같은 seed의 sampled text가 다르다는 사실만으로 distribution 보존 실패라고 판정하지 않아야 한다.
- Role이 아직 미정이어도 capability 질문과 책임 범위를 찾을 수 있어야 한다.
- 실제 수신자가 backend 이식이 아니라 운영만 맡는다면 navigation test가 이 구조의 가정을 반증하도록 한다.
- 문제 설정·진단·주석 정리의 적용 범위를 구분해야 한다.
- 현상 DELTA 정리는 env_clean에 적용했고, 다른 category와 주석·출력 경로는 계획이다.
- 원인 기존 본문에는 적용 전 설계와 적용 후 상태가 함께 있었다.
- 결과 현재 판정은 6.4, 검증 결과는 아래, 이전 설계는 접은 이력으로 보존한다.
6.2.1 현재 결과와 다음 작업
| 항목 | 상태 | 근거·제한 | |
|---|---|---|---|
| 6.2.3.1 | DELTA 변수 42개 | 적용 (env_clean) | CSV의 after·state 기준 |
| 6.2.3.2 | Batch-1 전후 비교 | 통과 | 두 upload mode에서 bit-identical |
| 6.2.3.3 | 비교 workload | 완료 | 16K, 요청 2개, 151 verification rounds, accepted 2000/2406 |
| 6.2.3.4 | Unit test | 통과 | 41/41 |
| 6.2.3.5 | 기본 진단 level | 통과 | DELTA 진단 line 없음 |
| 6.2.3.6 | Level 3 진단 | 통과 | 이전 marker 68종 모두 출력 |
| 6.2.3.7 | Batch-2 | Smoke 용도 | 같은 baseline 두 번도 acceptance 89.5%·86.4% |
| 6.2.3.8 | 16K/32K acceptance | 진행 중 | 완료 결과로 표기하지 않음 |
| 6.2.3.9 | 나머지 category | 계획 | 258개 |
| 6.2.3.10 | 주석·진단 코드·출력 경로 | 계획 | 아래 작업별 검증 후 적용 |
- Batch-1 결과는 cleanup 전후의 동등성 근거다.
- Baseline vLLM 전체와의 implementation parity나 모든 batch의 결정성을 증명하지 않는다.
COMPACT_INDEX_MAP_MAX기본값은 512→2048로 변경됐다.COMPACT_UPLOAD_PEND와DIFF_NATIVE는 현재 유지한다.
기존 환경변수 계획 페이지와 preview
- 카테고리별 정리 계획
- 전체 목록
- 이전 묶기 CSV
- DELTA 감사 CSV
- 이 preview는 이전 계획을 포함한다. 현재 적용 여부는 6.4를 따른다.
6.2.2 공용 설정 체계
- 목적 로그·dump·시간 계측·출력 경로를 구분한다.
- 상태 DELTA의 적용 범위를 제외하면 아래 공용 체계는 계획이다.
| 설정 | 값 | 책임 | |
|---|---|---|---|
| 6.2.8.1 | LOG_PRINT | 0–3 | Domain의 기본 진단 level |
| 6.2.8.2 | LOG_PRINT_<DOMAIN> | 0–3 | COMPACTION·DELTA·DRAFT·VERIFY·KV·ROUTER·PREFILL별 override |
| 6.2.8.3 | Level 0 | 기본 | 추가 domain 진단을 끈다 |
| 6.2.8.4 | Level 1 | 요약 | Verification round·step 요약; 진단용 GPU sync·전체 pool scan 없음 |
| 6.2.8.5 | Level 2 | 상세 | Request·layer 정보와 JSONL trace; 시간 계측 sync 허용 |
| 6.2.8.6 | Level 3 | 무거운 관찰 | Tensor 통계·fingerprint·전체 pool 비교 |
| 6.2.8.7 | LOG_PRINT_REQ | req_id | 특정 request만 기록 |
| 6.2.8.8 | DUMP | 종류 목록 | accept·score·kv·logprob·memcheck·reject·reject_all·metadata·tokens |
| 6.2.8.9 | CS_OUT | 경로 | CS_OUT/<run>/logs/, breakdown/, trace/, dump/; 경로 지정만으로 계측을 켜지 않음 |
| 6.2.8.10 | BREAKDOWN | 0·rows·light | 시간 분해 기록 |
| 6.2.8.11 | BREAKDOWN_KERNEL | 0·inline·profiler·inline+gpu-profiler | Kernel 시간 계측 |
| 6.2.8.12 | DELTA_STRICT | 명시적 설정 | DELTA soft failure를 오류로 처리 |
이전 설계의 규모·배경·진행 순서
- 이전 첫 요약은 추가 환경변수 286개, 안 쓰는 후보 48개, 추가 코드 약 3.9만 줄, 한글 주석 84줄, TODO 24개, 주석 처리된 코드 114줄, 진단 코드 31개였다.
- 공개 엔진 문서가 없고 설정이 CLI·설정 클래스·환경변수에 나뉘어 있었다.
- 최초 문서 frame은 LLMServingSim 구조를 참고했다. 현재 frame은 6.1의 accelerator porting 대상 설계다.
- 당시 결과는 문서 구성요소·git 청소 목록·설정 및 test 구조의 설계였고, “코드는 아직 고치지 않았다”는 그 시점의 상태였다.
- 기존 청소 순서는 위험이 작은 작업부터 #1 환경변수·#3 진단 코드 → #2 주석 → #4 출력 경로였다.
- 2026-09-30 초기 묶기 설계는 GPU(Astra) 89개와 CPU verify(Fable) 197개, 합계 286개를 대상으로 했다.
- 그 표의 쪽 표시는 설계 분담이며 실제 실행 process나 변수 작성자를 뜻하지 않는다.
| 당시 처리 | GPU(Astra) | CPU verify(Fable) | 합 | |
|---|---|---|---|---|
| 유지·일부 rename·호환 | 61 | 138 | 199 | |
| 공용 knob으로 묶기 | 11 | 29 | 40 | |
| 삭제 제안 | 17 | 30 | 47 | |
| 합 | 89 | 197 | 286 |
- 당시 로그·trace·dump 스위치는 약 70개, level 방식은 5가지, 출력 경로 변수는 14개였다.
- 접두어는
COMPRESS_SPEC_,COMPRESSION_SPEC_,COMPSPEC_,CS_네 가지였다. - CPU 설계에서는 사용자 노출 변수를 197→149개, 로그 스위치 59개를 공용 knob 11개로 줄이는 안을 제시했다.
- 전체 공용 knob 규모는 약 12개로 설명했다. 이 수치는 적용 후 300개 inventory와 다른 집계다.
- “디버그·dead 변수는 실제 실행 성능에 큰 영향이 없다”는 초기 설명과, 아래 GPU sync·pool scan 비용 지적을 함께 보존한다. 이번 문서에서 성능 효과를 새로 확정하지 않는다.
- Astra 이행안은 기준선 → 공용 resolver → 기능 rename·alias → 동작과 로그 분리 → emitter level 분리 → CS_OUT → 삭제 → n82 L40S 전후 비교 순서였다.
- 당시 비교 배치는 verify 28코어와 GPU engine용 4코어였다.
- 원문은
RESULT_astra_env.md,RESULT_fable_env.md, 합친env_regroup.csv이며 위치는 ai-clusterdocs/ai_agent/011_env_inventory/였다.
이름·호환·출력 경로에 남은 세부 조건
- 기능 접두어 계획은
COMPACTION_*,DELTA_*,DRAFT_*,KV_*,VERIFY_*다. - 초기 예시는
COMPACT_DIFF_UPLOAD→DELTA_UPLOAD,COMPACT_THRESHOLD→COMPACTION_THRESHOLD,COMPSPEC_RUNAHEAD→DRAFT_RUNAHEAD,COMPACT_TEMP_BUFFER_GB→KV_TEMP_BUFFER_GB,COMPSPEC_BONUS_TOKEN→VERIFY_BONUS_TOKEN이었다. - DELTA의 현재 이름과 처리는 6.4를 따른다. 초기 rename 예시를 적용 완료로 읽지 않는다.
- Alias 계획은 옛 이름을 한동안 경고 한 번과 함께 받고, 셸>.env, 같은 우선순위에서는 새 이름을 우선하는 방식이다.
RS_*,LS_*,LAYER_SERIAL_*,DYN_ROUTER*,COMPACT_MAX_GPUBLK_UTIL등 논문 runner의 일부 이름은 유지한다.BREAKDOWN_KERNEL_PROFILE_MODE,BREAKDOWN_KERNEL_INLINE의 순서로(1,1)→inline+gpu-profiler,(1,0)→profiler를 보존한다. INLINE 단독으로 profiling을 켜지 않는다.- Legacy path와 timestamp 동작은 이행 시 보존한다.
ATTN_KV_DUMP_DIR의 계획 경로는CS_OUT/<run>/dump/kv/<req>_j<job>_<postfix>.json이다.BREAKDOWN_LIGHT_LAT는breakdown/lat_<role>.json,BREAKDOWN_RUN_DIR는CS_OUT/<run>/breakdown/{sched,step_<role>,cpu_verify}.jsonl로 연결한다.- CPU·GPU log 계획 경로는
logs/cpu_server.log,logs/gpu_client.log다. - FSM은
trace/fsm/<req>.jsonl이며 transition마다 open/append/close하는 비용 때문에 handle caching을 제안했다. - Recompaction trace 계획 경로는
trace/{reload_trace,verify_trace,recompact_trace,draft_trace}.jsonl이다. - 기존 trace writer는 BREAKDOWN_DIR에 append하며
draft_trace는 light 조건을 가진다.analysis/recompact_*.pyreader를 함께 확인한다. - Logprob dump는
dump/logprob/step{N}_{ts}.pt, score dump는dump/score/, memory 검사는dump/memcheck/다. - Reject dump의 기존 제안 경로는
dump/accept/reject_distrib.jsonl, full-vocab PT는dump/accept/reject_pt/다. DUMP공통 설명의dump/<kind>/와 reject의 기존 경로 제안은 일치하지 않는다. OUTPUT 구현 전에 경로 계약을 확정한다.- CPU profile 도구는 현재
$BREAKDOWN_DIR/B{n}_{DTYPE}_CPU/<ts>를 쓰며CS_OUT/<run>/breakdown/으로 옮기는 계획이다. TOKEN_DUMP_JSON의 명시적 경로를 보존한다.DUMP=tokens일 때의 선택적 기본 경로는dump/tokens/<force_name>.json이다.OUT_ROOT의 legacy fallback은<OUT_ROOT>/held.jsonl이다.- Retained set fingerprint와 전체 배열은 각각
trace/held.jsonl, 명시적DUMP=metadata로 나누는 계획이었다. - 이전
DUMP_METADATA_ROUNDS제안은 generation 범위만 지정하며, 범위 설정 자체가 dump를 켜지는 않는다.
DELTA 감사와 이전 결정의 변경 이력
- 초기 감사의 “28개 모두 20190511이 추가”는 당시 범위의 기록이다.
- 논문 runner
scripts/longcontext/run_compressspec.sh:53은 shipped defaults를 사용한다고 설명하며COMPACT_DIFF_UPLOAD=1,COMPACT_RECOMPACT_RATIO=1.0,COMPACT_MAX_GPUBLK_UTIL=0.9를 override로 전달했다. - Saturate runner는
COMPACT_INDEX_MAP_MAX=2048을 전달했다. - 초기 판정은 ratio·headroom·index map 세 knob와 upload ablation 하나였다.
- 경계 항목은
COMPACT_UPLOAD_PEND,COMPACT_ACT_RESERVE_GIB였다. - Helper reader
_armv,_diag,_dlog를 추가한 inventory 재조사에서 480→490개가 됐고 dead 후보는 47→44개가 됐다. - 그때
COMPACT_RECOMPACT_RATIO,HELD_ORDER_DIAG,KEEP_SPREAD_DIAG가 dead 목록에서 빠졌다. - 새로 확인한 항목은
COMPACT_RECOMPACT_RATIO,COMPACT_ACK_TRACE,COMPACT_PLAN_STAT,KEEPMAP_DIAG,KEEPMAP_SIZE_DIAG,KEEP_SPREAD_DIAG,POOL_SET_DIAG,PRUNE_HOLD_LOG,RECOMPACT_DIAG,UPLOAD_TRACE였다. - 최초 본문의 “나머지 25개”, “로그 11개+누락 9개”, 요약의 “17개”는 조사 단계별 표현이다. 현재 42개와 합산하지 않는다.
COMPACT_INDEX_MAP_MAX는 vllm_cpu14036677a에서 기본 512→2048로 runner 값에 맞췄다.- 당시 n82 Job 1036985의 전후 E2E 확인 후 적용한다는 계획이 있었으며, 현재 검증 상태는 6.2.1이다.
- 이전에는 아래 11개를 상수화 대상으로 묶었다:
COMPACT_KEEPMAP_SLACK=0,CS_LANDING_PRUNE=1,CS_DRAFT_HOLD=1,CS_DRAFT_HOLD_MAX=64,DIFF_NATIVE=1,DIFF_PARTIAL_RELOAD=1,KEEPMAP_PAD_LAYERS=1,KEEPMAP_STRICT_SLOTS=1,RECOMPACT_SLOT_ALIGN=1,COMPACT_KEEPMAP_SLOT_MULT=2,COMPACT_FINISHED_RESEND=4. - 마지막 두 항목은 on/off가 아닌 tuning 상수라는 구분도 있었다.
- 이후
DIFF_NATIVE는 native→NumPy fallback을 위해 유지했다. 공유한-march=nativebuild의 SIGILL 위험을 고려한 판정이다. - 이후
COMPACT_UPLOAD_PEND도 유지했다. GPU 기본 0·CPU 기본 1 불일치는 미해결이다. COMPACT_ACT_RESERVE_GIB는 코드 상수 1 GiB 로 고정하고 삭제했다(2026-09-30, 러너가 1.0 외 값을 쓴 적 없음).COMPACT_KEEPMAP_SLACK의 당시 setter 76회는 모두 0이었다. 1은 selected set과 delta의 union을 남기는 이전 동작이었다.- Landing prune을 끄면 diff 적용 후 prune을 생략하고, draft hold를 끄면 prune 대기 중 draft가 진행한다.
- Layer padding을 끄면 stale tail, strict slot 검사를 끄면 다른 pool 크기의 map 적용과 KV 손실 위험이 있었다.
- 초기 rename안은
DELTA_FINISHED_RESEND,DELTA_PRUNE_HOLD,DELTA_PRUNE_HOLD_MAX,DELTA_LANDING_PRUNE,DELTA_PARTIAL_RELOAD,DELTA_KEEPMAP_STRICT_SLOTS,DELTA_KEEPMAP_PAD_LAYERS,DELTA_RECOMPACT_SLOT_ALIGN,DELTA_KEEPMAP_SLOT_MULT,DELTA_KEEPMAP_SLACK,DELTA_INDEX_MAP_MAX,DELTA_UPLOAD_PEND,DELTA_NATIVE였다. 현재 disposition은 6.4로 대체됐다. - 초기 fatal/assert 통합안은
DIFF_PAD_SHORT_FATAL,UPLOAD_SKIP_FATAL,CS_PARITY_ASSERT를 LOG_PRINT_DELTA=3에 넣었다. - 다른 설계안은 각각
DELTA_PAD_SHORT_FATAL,DELTA_UPLOAD_SKIP_FATAL,DELTA_ASSERT_SERIAL_REQUESTS로 분리했다. - 현재 CSV는 세 항목을 명시적
DELTA_STRICT=1로 연결한다. CS_PARITY_ASSERT는 다른 request의 ledger가 남으면 raise하는 serial-request 가정의 검사였다. 동시 요청의 정상 상태와 구분해야 한다.- 초기
COMPACT_HOLD_FULL→DUMP_METADATA_ROUNDS계획은 현재 DELTA CSV의 삭제 판정으로 대체됐다. - 초기
LOG_DELTA_SELECTION의 1/2 기능별 분해안과 이후 “값 2만 의미”라는 감사 문구를 이력으로 보존한다. 현재 CSV는 LOG_PRINT_DELTA≥3이다. - 초기
COMPACT_DIFF_STAT는 요약을 level 1, 비교·sync timing을 level 2로 분리하는 안이었다. 현재 CSV의 연결은 LOG_PRINT_DELTA≥1이며 세부 emitter 비용을 새로 측정한 결과는 이 문서에 없다. DELTA_COMPACTION_LOG=1과COMPACT_DIFF_STAT=1의 기존 경로에는 GPU sync 2회가 있었다. Legacy 기능 선택과 새 level 의미를 같은 숫자만으로 대체하지 않는다는 조건을 보존한다.KEEPMAP_SLOT_LOG의 warning은 level 0에서도 남긴다는 판정이다.
6.2.3 주석 정리
- 대상 v0.14.0 이후 추가한 Python·C++ 코드다.
- 상태 계획이다. 아래 수치는 기존 조사값이다.
| Repo | 추가한 줄 | 주석 줄 | 한글 주석 | TODO·FIXME | 주석 처리된 코드 | |
|---|---|---|---|---|---|---|
| 6.2.14.1 | vllm | 32,927 | 4,503 | 84 | 24 | 104 |
| 6.2.14.2 | vllm_cpu | 6,742 | 1,053 | 0 | 0 | 10 |
적용 규칙
- vllm·vllm_cpu의 한글 주석 84줄을 영어로 바꾼다.
- 주석은 두 줄 이내로 두고 긴 설명은 docs로 옮긴다.
- 주석 처리된 코드 114줄은 삭제하고 Git 기록으로 보존한다.
- 호출자가 없거나 동작이 바뀐 함수의 docstring을 확인한다. 과거
note_upload()문제가 점검 사례다. - TODO 24개는 issue로 옮기거나 처리한다.
6.2.4 진단 코드 정리
- 대상 trace 감사에서 남은 문제별 probe다.
- 상태 계획이며, 변수 삭제와 emitter 삭제를 함께 검토한다.
| 묶음 | 도입 | 개수 | 예 | |
|---|---|---|---|---|
| 6.2.18.1 | hybrid-sw 추적 | 2026-06-07 f369fd175 | 14 | PR4_*, gemma3 DUMP_*, *_DBG |
| 6.2.18.2 | pr4-item8 | 2026-06-11 vllm_cpu 2ecde1a2b | 8 | ALLOC_NEW_COMPUTED_DBG, FREE_BLOCKS_DBG |
| 6.2.18.3 | 해결된 parity 추적 | 2026-09-19 2d7f91b2a·deaf471f3 | 9 | KV_DUMP_*, RECOMPACT_FP_LOG, *_LOG |
삭제·유지 판단의 세부 근거
- 근거는
/envs/1.8절과trace_audit.md다. - 초기 47개 삭제 목록의 현재 처리는 6.4에 포함한다.
ALLOC_NEW_COMPUTED_DBG,CPU_ATTN_BUILD_DBG,CPU_FWD_READ_HASH,DUMMY_BATCH_DBG,FWD_TENSOR_STATS,INPUT_PROCESSOR_DBG는 횟수가 제한된 probe였다.FREE_BLOCKS_DBG,RESERVE_DBG는 특정 block ID의 free·reserve probe였다.COMPACT_DUMP_INDICES,COMPACT_DUMP_KV는 일회성 layout probe였다.CPU_KV_HASH_DBG는 문제별 block hash였고 기존 진단 setter 하나도 함께 정리하는 계획이었다.DUMMY_BATCH_DBG를 지워도 독립적인SKIP_DUMMY_BATCH동작 제어는 유지한다.COMPACTION_IDX_DUMP와COMPACTION_IDX_EVERY,COMPACTION_IDX_LAYERS는 전체 selected-index writer와 주기·layer filter를 함께 삭제하는 계획이다. 이를 DUMP=accept에 자동 편입하지 않는다.KV_DUMP_DIR는 이전 parity dump family의 경로다. 다른 모든 KV dump의 alias로 확장하지 않는다.KV_DUMP_SEQ는 request prefix·sequence 범위 dump,KV_DUMP_NCT는 tensor 저장과.cpu()를 포함했다.ATTN_BP_DUMP_SCORE_CHECK는 L×T×H×S fp32 tensor를 유지하는 test-only 비교였다.BREAKDOWN_GPU_EVENT_DEPTH는 4로 고정하는 계획이고,BREAKDOWN_FLUSH_EVERY는 line buffering과 중복이었다.COMPRESS_SPEC_CYCLE_ANNOTATE는.realmode-run/cycle_map.jsonl에 기록했다. DUMP=accept에도 accepted_token_ids가 있어 중복으로 판정했다.DUMP_EXTEND_BEFORE_VERIFY는 처음 8회,DUMP_SAMPLED_IDS는 처음 32회 probe였다.DUMP_LAST_HIDDEN의.item()·.cpu(),DUMP_SAMPLED_IDS의.tolist()는 sync를 수반했다.KV_TRANSFER_DBG는 처음 10회,PR4_8_DBG_EXTENDED의 관련 emitter는 처음 2회 무조건 출력했다.NUMA_VERIFY_DEBUG는 allocation 10,000회마다 print했다.LOGPROB_READ_DEBUG는 08-21 anchor 수정의 계측용이었다.LOGPROB_READ_POS_OFFSET은 legacy-anchor branch 안에서만 읽었다.PAYLOAD_BUILD_DBGenv는 제거하되 emitter는 LOG_PRINT_VERIFY=2 아래에 남기는 계획이었다.PR4_DISABLE_COMPRESS_CALL,FAKE_COMPACTION_VERIFY,FAKE_NEEDS_KV_RELOAD,REUSE_ENGINE_RID는 동작을 바꾸는 실험 경로였다.INIT_FILE_PATH는 상대 CPU_VERIFY_DUMP_DIR의 기준 경로였으며 CS_OUT을 절대 경로로 쓰는 계획에서 제거 대상이었다.COMPACT_SCORE_EXPORT_LEGACY는 cpu_attn.py:586의 살아 있는 비교 경로라 초기 dead 판정을 취소했다.LOGPROB_DUMP_DIR는 dump_debugger/logprobs_debugger.py:29의 reader 때문에 유지할 dump 종류로 판정했다.DRAFT_TOKEN_LOG에는 Qwen stop ID 151645·151643이 고정돼 있어 이행 시 model에 맞게 점검한다.VERIFY_DEBUG는 일반 server에서 decode된 draft·verified tail을 출력하지만 score server에는 읽고 쓰지 않는 지점도 있었다.
6.2.5 Trace·출력 경로 통일
- 목적 기록 위치와 진단 level을 예측 가능하게 만든다.
- 상태 DELTA 밖의 공용 이행은 계획이다.
| 대상 | 현재 조사값 | 계획 | |
|---|---|---|---|
| 6.2.22.1 | 출력 경로 | 변수 14개 | CS_OUT과 고정 하위 폴더 |
| 6.2.22.2 | 진단 level | 방식 5가지 | LOG_PRINT와 domain override |
| 6.2.22.3 | 기본 반복 로그 | 6곳 | Level 확인 뒤에 기록 |
| 6.2.22.4 | Env read | Request·round마다 35–45회 | 해석·cache 시점 통합 |
| 6.2.22.5 | _diag() | 복사 6개 | 공통 해석 계약 |
| 6.2.22.6 | Sync 계측 | Repacking step당 2회 경로 | 명시적 계측 level로 구분 |
이전 명칭과 검증 조건
- 이전 #4 표는
CS_TRACE=0/1/2/3,CS_DUMP,BREAKDOWN=0/rows/light,BREAKDOWN_KERNEL=0/inline/profiler라고 적었다. - 현재 공용 설계 명칭은 LOG_PRINT·DUMP이고, kernel 모드에는 inline+gpu-profiler를 포함한다.
- 이전 폴더 예시는
logs,breakdown,trace,dump/{accept,score,kv,logprob,debug}였다. - 당시 예시 경로에
KV_DUMP_DIR=/tmp/qwg_kvdump가 포함됐다. _envcompat로 옛 이름을 경고와 함께 받는 계획이었다.- 변경 후 같은 GPU에서 짧은 E2E output과 breakdown을 전후 비교한다.
- Import 시 cache하더라도 request별 arm override를 잘못 고정하지 않도록 resolver 경계를 확인한다.
- 문제 실험 조건과 검증 진입점을 일관되게 관리해야 한다.
- 현상 CLI·환경변수·설정 클래스와 여러 runner가 함께 쓰인다.
- 원인 실험별 설정과 test 실행 계약이 분산돼 있다.
- 결과 Profile과 suite를 제안한다. 아직 구현 완료 상태가 아니다.
6.3.1 설정 우선순위
- 목적 같은 값을 여러 곳에서 정했을 때 실제 적용값을 설명한다.
- 상태 현재 세 층을 문서화하고 profile 도입을 계획한다.
| 층 | 위치 | 우선순위 | |
|---|---|---|---|
| 6.3.4.1 | CLI | compressspec <cmd> … | 명시한 인자 우선 |
| 6.3.4.2 | 환경변수 | 셸 > .env | load_dotenv가 기존 셸 값을 덮어쓰지 않음 |
| 6.3.4.3 | 설정 클래스 | CompressionSpecConfig | 기본값; 일부 field는 생성 시 env read |
Profile 제안
- 실험 조건을
profiles/paper_long.env,paper_batch.env,smoke.env로 묶는다. - 제안 진입점은
compressspec run --profile paper_long이다. - Profile이 env registry에 없는 이름을 사용하면 시작 시 실패시킨다.
- Profile을 추가할 때 CLI·셸·profile·.env·class 사이 우선순위를 별도로 확정한다.
- 위 명령은 설계 예시이며 현재 지원 명령으로 표시하지 않는다.
6.3.2 Test suite
- 목적 검증 범위·실행 자원·예상 시간을 구분한다.
- 상태 아래 구성은 계획이다.
| Suite | 검증 내용 | 자원 | 시간 | |
|---|---|---|---|---|
| 6.3.8.1 | unit | Selection Eq.1·2, delta plan, retention map, ledger ack, rejection sampling | GPU 없는 CPU | 초 |
| 6.3.8.2 | kernel | AMX/AVX-512 attention 수치와 참조 구현, tile 경계 w+1 | CPU 노드 | 분 |
| 6.3.8.3 | api | Verify request·response, version·ack 계약 | CPU 노드 | 분 |
| 6.3.8.4 | smoke | 요청 1개, 짧은 context, T=0 | GPU 1장+CPU socket 1개 | 수 분 |
| 6.3.8.5 | parity | T=0의 vLLM token 비교, full/delta token 비교 | 같은 노드 순차 | 수십 분 |
| 6.3.8.6 | perf | 고정 workload의 breakdown 전후 비교 | 같은 노드 | 수십 분 |
| 6.3.8.7 | artifact | 논문 figure 재현 | Cloud | 시간 |
Test 배치와 운영
- 제안 진입점은
compressspec test <suite>이며 suite는 unit·kernel·api·smoke·parity·perf다. - Artifact 실행을 같은 CLI에 포함할지는 별도로 확정한다. 기존 표의 artifact 항목은 유지한다.
- 결과는
CS_OUT/<시각>/test/<suite>/의 CSV와 log다. - 실패 시 마지막 50줄을 요약에 붙인다.
test/,scripts/,jh_script/runner를 suite에 흡수하고 나머지는 archive로 옮긴다.- Parity·perf는 한 노드에서 순차 실행한다.
- 실행 전 해당 노드의 다른 process를 확인한다.
6.3.3 장비별 확인
- 목적 Quickstart 와 offline·online 예제가 GPU·CPU 조합마다 손 설정 없이 도는지 본다.
- 상태 ISA 별 격리 빌드 후 같은 조건(Qwen3-4B-Thinking-2507 BF16, 16 코어)으로 확인 중이다.
갱신 2026-10-01 20:12 · 결과 results/20260930_qs_matrix/ · 생성 jh_script/claude_script/qs_matrix/hw_matrix.py
| 장비 | GPU (cc) | CPU | ISA | GPU import | CPU import | Quickstart | AIME 3문항 | offline SnapKV | online SnapKV | offline StreamingLLM | online StreamingLLM | Ctrl-C 종료 | breakdown | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 6.3.13.1 | L40S | L40S 8.9 | Xeon Gold 6530 | AMX | O | O | O | O | O | O | O | O | O | O |
| 6.3.13.2 | L40S · MODEL=HF id (Qwen3-0.6B) | L40S 8.9 | Xeon Gold 6530 | AMX | – | – | – | – | O | O | – | – | O | – |
| 6.3.13.3 | RTX4090 | RTX 4090 8.9 | Xeon Gold 6426Y | AMX | O | O | O | O | O | O | O | O | O | O |
| 6.3.13.4 | H200 | H200 9.0 | Xeon Platinum 8562Y+ | AMX | O | O | O | O | O | O | O | O | O | – |
| 6.3.13.5 | L40S · AVX-512 경로 | L40S 8.9 | Xeon Gold 6530 | AVX-512 (vec) | – | – | – | – | O | O | O | O | O | O |
| 6.3.13.6 | H200 · AVX-512 경로 | H200 9.0 | Xeon Platinum 8562Y+ | AVX-512 (vec) | – | – | – | – | O | O | O | O | O | – |
| 6.3.13.7 | RTX4090 · AVX-512 경로 | RTX 4090 8.9 | Xeon Gold 6426Y | AVX-512 (vec) | – | – | – | – | O | O | O | O | O | – |
| 6.3.13.8 | RTX6000ADA | RTX 6000 Ada 8.9 | EPYC 7313 | AVX2 | O | O | O | O¹ | O | O | O | O | O | – |
| 6.3.13.9 | RTX3090 | RTX 3090 8.6 | EPYC 7313 | AVX2 | O | O | O | O¹ | O | O | O | O | O | – |
| 6.3.13.10 | A6000 | RTX A6000 8.6 | EPYC 7413 | AVX2 | O | O | O | O¹ | O | O | O | O | O | O |
| 6.3.13.11 | A5000 | RTX A5000 8.6 | EPYC 7502 | AVX2 | O | O | O | O¹ | O | O | O | O | O | O |
| 6.3.13.12 | A100-80GB | A100 80GB 8.0 | EPYC 7513 | AVX2 | O | O | O | O¹ | O | O | O | O | O | – |
| 6.3.13.13 | A100-40GB | A100 40GB 8.0 | EPYC 7742 | AVX2 | O | O | O | O¹ | O | O | O | O | O | – |
| 6.3.13.14 | 4A100 | A100 40GB 8.0 | EPYC 7742 | AVX2 | O | O | O | O¹ | O | O | O | O | O | – |
| 6.3.13.15 | TITANRTX | TITAN RTX 7.5 | Xeon Gold 5220R | AVX-512 | O | O | X² | – | –³ | –³ | –³ | –³ | –³ | O |
| 6.3.13.16 | RTX2080Ti | RTX 2080 Ti 7.5 | Xeon Silver 4210 | AVX-512 | O | O | X | X | –³ | –³ | –³ | –³ | –³ | – |
O 통과 · X 실패 · … 진행 중 또는 대기 · – 해당 없음 또는 미실행
¹ 측정 30행·3행은 모두 기록됐으나, 실행 중 스크립트를 덮어써 판정 줄이 rc=127 로 남았습니다.
² 판정 기준을 고치기 전 기록입니다. 수락 0/752, 출력이 개행 문자뿐이라 실패로 봅니다.
³ RTX 2080 Ti 는 GPU 메모리 부족(모델 7.61 GiB 적재 후 KV cache 가용 -0.98 GiB)으로 제외했습니다. TITAN RTX 는 지원하지 않습니다. TandemSpec 은 FlashInfer attention 을 필수로 쓰는데, 이 GPU(sm_75)에서 FlashInfer 가 틀린 결과를 냅니다(vLLM 단독에서도 FlashInfer 는 깨지고 Triton 은 정상, results/20260930_qs_matrix/turing_diag/). Ampere(sm_80) 이후를 주 대상으로 만든 kernel 이라 Turing 경로가 검증되지 않은 것으로 보이며, 원인 kernel 은 확인하지 않았습니다.
- 기준
feat/clean_code현재 코드 (TandemSpec620cd05, vllmfad20de69, vllm_cpucf6fc24b2). launcher·예제·verify 서버·두 엔진이 읽는 변수 중 upstream vLLM v0.14.0 에 없던 이름. harness(test/,scripts/) 전용 변수는 제외 - 개수 사용자 경로·자동 설정·출력 61 · 엔진 기능 조절 105 · 디버그 스위치 34 · 옛 이름 25 · 퇴역 26
- 근거 전체 목록 g07
011_tandemspec_clean/results/20261007_env_inventory/env_now.csv. 용도 열은 09-30 원자료(read site 확인)에서 가져왔고, 없으면 비움 - 생성기
model_matrix/dashboard_tools/gen_env_now.py(이 절은 손으로 고치지 않고 다시 생성)
6.4.1 사용자가 정하는 것
| 변수 | 기본값 | 용도 | |
|---|---|---|---|
| 6.4.3.1 | MODEL | 없음 (필수) | 모델 경로 또는 HF ID, 두 엔진 공통 |
| 6.4.3.2 | EXP_DTYPE | fp16 | bf16 · fp16 · fp32, 두 엔진 공통 |
| 6.4.3.3 | HYBRID_COMPRESS_MODE | snapkv | prefill 선택 snapkv · streamingllm |
| 6.4.3.4 | SERVE_PORT | 8100 | online API 포트 (--port 와 같음) |
| 6.4.3.5 | MAX_TOKENS | 128 | offline 예제 생성 길이 (--max-tokens 와 같음) |
| 6.4.3.6 | HF_TOKEN | 없음 | 비공개 HF 모델 |
6.4.2 조정용 (기본값으로 충분)
| 변수 | 기본값 | 용도 | |
|---|---|---|---|
| 6.4.5.1 | MAX_MODEL_LEN | 8192 | 최대 길이, verify 쪽도 따름 |
| 6.4.5.2 | MAX_NUM_SEQS | 8 | 동시 요청 수. CPU index map 크기도 이 값으로 자동 결정 |
| 6.4.5.3 | GPU_MEMORY_UTILIZATION | 0.8 | GPU 메모리 사용률 |
| 6.4.5.4 | SHARED_CPU_POOL_GB | 8 | CPU KV pool 크기 (GiB) |
| 6.4.5.5 | BLOCK_SIZE | 32 | KV block 크기. DRAFT_BLOCK_SIZE·VERIFY_BLOCK_SIZE 로 따로 줄 수 있으나 같아야 함 |
| 6.4.5.6 | SPECULATIVE_RUN_STEP | 16 | draft window |
| 6.4.5.7 | COMPRESSION_SPEC_SELECTED_TOKENS | 128 | prefill 끝의 선택 budget. launcher 가 EXP_SELECTED_TOKENS 에도 같은 값을 넣음 |
| 6.4.5.8 | COMPACT_COVERAGE | 0.95 | coverage threshold τ (선택 + recall gate). 엔진 단독 기본값은 0.7 |
| 6.4.5.9 | COMPACT_GATE_SCORE | 1 | recall gate 켜기 |
| 6.4.5.10 | STREAMINGLLM_SINK | 64 | StreamingLLM sink token 수 |
| 6.4.5.11 | ENFORCE_EAGER | 0 | 1 이면 CUDA graph 끔 |
| 6.4.5.12 | PORT | 8000 | 내부 verify 서버 포트 |
| 6.4.5.13 | COMPRESS_SPEC_CORES | auto | draft·verify 코어 분배 (off 면 분배 안 함) |
| 6.4.5.14 | COMPRESS_SPEC_DRAFT_CORES | 4 | draft 엔진 코어 수 |
6.4.3 launcher 가 자동으로 채우는 것 (설정하지 않음)
| 변수 | 채우는 값 | |
|---|---|---|
| 6.4.7.1 | VERIFY_MODEL | MODEL |
| 6.4.7.2 | CPU_VERIFY_URL | PORT 로 만듦 |
| 6.4.7.3 | LOGPROB_VOCAB_SIZE | config.json vocab_size |
| 6.4.7.4 | SCORE_NUM_LAYERS | config.json num_hidden_layers |
| 6.4.7.5 | SCORE_NUM_Q_HEADS | config.json num_attention_heads |
| 6.4.7.6 | SCORE_POOL_SIZE | 동시 요청 수 × (길이/128 + 2) × 1.25 |
| 6.4.7.7 | VERIFY_MAX_MODEL_LEN | MAX_MODEL_LEN |
| 6.4.7.8 | EXP_SELECTED_TOKENS | COMPRESSION_SPEC_SELECTED_TOKENS 와 같은 값 |
| 6.4.7.9 | VLLM_CPU_KVCACHE_SPACE | SHARED_CPU_POOL_GB |
| 6.4.7.10 | VLLM_CPU_OMP_THREADS_BIND | 코어 분배 결과 |
| 6.4.7.11 | OMP_NUM_THREADS | 코어 분배 결과 |
| 6.4.7.12 | VLLM_ATTENTION_BACKEND | FLASHINFER |
| 6.4.7.13 | COMPRESSION_SPEC_DECODING_INTERVAL | 2048 |
| 6.4.7.14 | NUM_GPU_BLOCKS · max_num_seqs | GPU 엔진이 시작할 때 /initialize 로 CPU 엔진에 전달 (환경변수 아님) |
6.4.4 설치·실행 제어
| 변수 | 용도 | |
|---|---|---|
| 6.4.9.1 | COMPRESS_SPEC_DRAFT_ENV | 기존 draft conda env 지정 |
| 6.4.9.2 | COMPRESS_SPEC_VERIFY_ENV | 기존 verify conda env 지정 |
| 6.4.9.3 | COMPRESS_SPEC_TAG | env 이름 태그 |
| 6.4.9.4 | COMPRESS_SPEC_SKIP_CHECK | build stamp 대조 생략 |
| 6.4.9.5 | COMPRESS_SPEC_NO_AUTOBUILD | stamp 불일치 시 자동 재빌드 거부 |
| 6.4.9.6 | COMPRESS_SPEC_NO_CLEAN | 실행 전 정리 생략 |
| 6.4.9.7 | LOG_DIR, CPU_LOG, GPU_LOG | 로그 위치 |
| 6.4.9.8 | READY_TIMEOUT | verify 서버 준비 대기 (600초) |
| 6.4.9.9 | HF_HUB_OFFLINE, TRANSFORMERS_OFFLINE | HF 오프라인. 처음 받을 때는 0 |
| 6.4.9.10 | MINIFORGE_DIR | conda 위치 |
6.4.5 로그 · dump · breakdown
| 변수 | 동작 | |
|---|---|---|
| 6.4.11.1 | DUMP_DIR | 모든 dump 출력 위치. $DUMP_DIR/<kind> (breakdown, kv, score, verify, metadata, fsm, delta …) |
| 6.4.11.2 | LOG_PRINT_BREAKDOWN | 1 phase 단위 breakdown, 2 CPU kernel 계측 추가 |
| 6.4.11.3 | LOG_PRINT_DUMP | 1 index · accept · FSM, 2 score · attn KV, 3 forward · logits · sampled id |
| 6.4.11.4 | LOG_PRINT_<DOMAIN> | 도메인별 로그 0–3: BREAKDOWN, DELTA, DUMP, KV, VERIFY. 없으면 LOG_PRINT |
| 6.4.11.5 | BREAKDOWN_KERNEL_INLINE | kernel 계측 방법. 1 inline (기본), 0 torch.profiler |
| 6.4.11.6 | BREAKDOWN_PHASES, BREAKDOWN_LIGHT_LAT | breakdown 필터·요약 모드 |
| 6.4.11.7 | KV_DUMP_NCT, KV_DUMP_SEQ, COMPACTION_IDX_EVERY, COMPACTION_IDX_LAYERS | dump 범위 필터 (켜기는 LOG_PRINT_DUMP) |
| 6.4.11.8 | COMPRESS_SPEC_TRACE_REQ | trace 를 request 하나로 좁힘 |
| 6.4.11.9 | BREAKDOWN_RUN_DIR | harness 가 정하는 run 디렉토리 (내부) |
6.4.6 엔진 기능 조절 (105개, 실험용 · 기본값 그대로 사용)
| 카테고리 | 개수 | |
|---|---|---|
| 6.4.13.1 | VERIFY — verify engine | 39 |
| 6.4.13.2 | COMPACTION — recompression | 20 |
| 6.4.13.3 | KV — KV offload · pool | 16 |
| 6.4.13.4 | PREFILL — prefill | 10 |
| 6.4.13.5 | DRAFT — draft engine | 5 |
| 6.4.13.6 | DELTA — delta transfer | 4 |
| 6.4.13.7 | ROUTER — mode 전환 | 4 |
| 6.4.13.8 | HARNESS | 1 |
| 6.4.13.9 | ETC — 기타 | 1 |
| 6.4.13.10 | 미분류 — 09-30 원자료에 없던 변수 | 5 |
6.4.6.1 VERIFY — verify engine
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.15.1 | ACCEPT_MODE | standard | verify/utils.py | standard / dual / cactus / tas acceptance rule |
| 6.4.15.2 | CACTUS_DELTA | 1.0 | verify/utils.py | |
| 6.4.15.3 | COMPSPEC_BONUS_TOKEN | 0 | verify/cpu_verify_server.py | changes what the GPU appends; behaviour knob |
| 6.4.15.4 | COMPSPEC_SKIP_WATCH_SECS | 120 | vllm/cpu_verify/cpu_verify_engine.py | log-only watchdog threshold (comment :542); still a timing parameter, … |
| 6.4.15.5 | CPU_VERIFY_TIMEOUT_S | 500 | vllm/cpu_verify/_verify_dispatcher.py | |
| 6.4.15.6 | FORCE_ATTN_ISA | "" | vllm/v1/kv_offload/worker/cpu_gpu.py 외 1 | |
| 6.4.15.7 | LOGPROB_READ_POS_OFFSET | 0 | vllm/cpu_verify/cpu_verify_engine.py | only read inside the LEGACY_ANCHOR branch |
| 6.4.15.8 | LOGPROB_SPARSE | 0 | verify/test_logprob_stamp.py 외 4 | |
| 6.4.15.9 | LOGPROB_SPARSE_CAP | 128 | verify/utils.py 외 2 | |
| 6.4.15.10 | MAXPOS_OVERRIDE | — | verify/cpu_verify_server.py 외 1 | |
| 6.4.15.11 | NUMA_AWARE_VERIFY_NODES | 4 | verify/cpu_verify_server.py 외 5 | |
| 6.4.15.12 | RELAX_RESIDUAL | v1 | verify/utils.py | read but effect not in the read lines; UNCLEAR: read verify/utils.py … |
| 6.4.15.13 | RELAX_TAU | 0.5 | verify/utils.py | |
| 6.4.15.14 | RS_ALLOW_UNSUPPORTED_SAMPLING | 0 | vllm/cpu_verify/channels/temp_buffer.py | |
| 6.4.15.15 | RS_FAST_TRUNC | 1 | verify/utils.py | |
| 6.4.15.16 | RS_FAST_TRUNC_MAX_K | 4096 | verify/utils.py | |
| 6.4.15.17 | RS_KTH_CHUNKS | 32 | verify/utils.py | |
| 6.4.15.18 | RS_KTH_MIN_VOCAB | 16384 | verify/utils.py | |
| 6.4.15.19 | RS_Q_FLOOR | 1e-6 | verify/utils.py | |
| 6.4.15.20 | RS_ROW_MISMATCH | fatal · reject | verify/test_rs_truncation.py 외 1 | |
| 6.4.15.21 | RS_STALE_MAX_RATE | 0.02 | verify/utils.py | |
| 6.4.15.22 | RS_STALE_MIN_POS | 200 | verify/utils.py | |
| 6.4.15.23 | RS_TIE_EPS | 1e-3 | verify/utils.py | |
| 6.4.15.24 | RS_TOPP_EPS | 1e-5 | verify/utils.py | |
| 6.4.15.25 | RS_TRUNCATE | 1 | verify/utils.py | |
| 6.4.15.26 | SKIP_DUMMY_BATCH | 0 | vllm_cpu/v1/engine/core.py | |
| 6.4.15.27 | TAS_DELTA | 0.3 | verify/utils.py | |
| 6.4.15.28 | TAS_EPS | 0.09 | verify/utils.py | |
| 6.4.15.29 | VERIFY_BATCH_WINDOW_MS | 0 | verify/cpu_verify_server.py | |
| 6.4.15.30 | VERIFY_DISABLE_HYBRID_KVCM | 0 | verify/cpu_verify_server.py | 0 setters; behaviour knob, must not fold into a level |
| 6.4.15.31 | VERIFY_DISPATCH_WORKERS | "" | vllm/cpu_verify/cpu_verify_engine.py | |
| 6.4.15.32 | VERIFY_DP_SIZE | 1 | verify/cpu_verify_server.py 외 5 | |
| 6.4.15.33 | VERIFY_ENFORCE_EAGER | 1 | verify/cpu_verify_server.py 외 1 | |
| 6.4.15.34 | VERIFY_KV_PREFAULT | 0 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.15.35 | VERIFY_KV_PREFAULT_ARM_IDLE | 2.0 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.15.36 | VERIFY_MAX_NUM_SEQS | 1 · 32 · 4 | verify/cpu_verify_server.py 외 2 | |
| 6.4.15.37 | VERIFY_NUMA_INTERLEAVE | 1 | verify/cpu_verify_server.py | |
| 6.4.15.38 | VERIFY_NUMA_LOCAL | — | verify/cpu_verify_server.py | |
| 6.4.15.39 | VERIFY_PROMPT_LOGPROBS | -1 | verify/cpu_verify_server.py |
6.4.6.2 COMPACTION — recompression
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.17.1 | COMPACT_BLOCK_KEEP_RATIO | 0.1 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.2 | COMPACT_BLOCK_POLICY | mass | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.3 | COMPACT_BLOCK_SIZE | 32 | vllm/cpu_verify/keep_map_reader.py | slot alignment for the keep map = KV block size; UNCLEAR whether any … |
| 6.4.17.4 | COMPACT_DISABLE | 0 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.5 | COMPACT_GATE_AGG | min | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.6 | COMPACT_METHOD | ? · block · token | verify/profile_cpu_forward.py 외 5 | |
| 6.4.17.7 | COMPACT_NATIVE | 0 · 1 | verify/profile_cpu_forward.py 외 2 | |
| 6.4.17.8 | COMPACT_SCORE_FP16 | 1 | vllm_cpu/v1/attention/backends/cpu_attn.py | |
| 6.4.17.9 | COMPACT_SCORE_NO_REDUCE | 0 | vllm_cpu/v1/attention/backends/cpu_attn.py | |
| 6.4.17.10 | COMPACT_TOKEN_GLOBAL_RANK | 0 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.11 | COMPACT_TOKEN_HEAD_AGG | gqa_max | vllm_cpu/v1/attention/backends/cpu_attn.py 외 1 | |
| 6.4.17.12 | COMPACT_TOKEN_NUM_RECENT | 32 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.13 | COMPACT_TOKEN_NUM_SINK | 32 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.14 | COMPACT_TOKEN_POOL_K | 7 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.15 | COMPACT_TOKEN_POOL_TYPE | max | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.16 | COMPACT_TOKEN_SCORE_ROWS | draft_first_last | vllm_cpu/v1/attention/backends/cpu_attn.py 외 1 | |
| 6.4.17.17 | CP_BATCH_HEAD_REDUCE | 1 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.18 | DENSE_NO_COMPACT | — | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.17.19 | SNAPKV_KEY_CHUNK | — | vllm/v1/attention/backends/flashinfer.py | |
| 6.4.17.20 | SNAPKV_WIN_CHUNK | 8 | vllm/v1/attention/backends/flashinfer.py |
6.4.6.3 KV — KV offload · pool
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.19.1 | ATTN_BP_STREAM_CAP | 64 | vllm/distributed/kv_transfer/kv_connector/v1/attn_byproduct_handler/handler.py | stream/event pool cap; resource limit |
| 6.4.19.2 | COMPACT_FULL_COPY_GB | 8 | vllm/config/compression_spec_config.py | |
| 6.4.19.3 | COMPACT_TEMP_BUFFER_GB | 8 | vllm/config/compression_spec_config.py | connector memory size, not a compaction knob |
| 6.4.19.4 | COMPRESS_SPEC_CPU_POOL_HOLD | 1 | vllm/cpu_verify/cpu_verify_engine.py | admission hold on CPU pool capacity; default on |
| 6.4.19.5 | COMPRESS_SPEC_NO_FREE_SW | 0 | vllm_cpu/v1/core/single_type_kv_cache_manager.py | |
| 6.4.19.6 | COMPRESS_SPEC_PIN_FULLKV | 0 | vllm_cpu/v1/core/kv_cache_manager.py 외 1 | |
| 6.4.19.7 | COMPSPEC_PREEMPT_OFFLOAD | 0 | vllm/cpu_verify/compaction_upload/manager.py 외 2 | |
| 6.4.19.8 | COMPSPEC_RELOAD_STALL_S | 120 | vllm/cpu_verify/cpu_verify_engine.py | |
| 6.4.19.9 | COMPSPEC_RESUME_NEED_GATE | 0 | vllm/cpu_verify/cpu_verify_engine.py | |
| 6.4.19.10 | COMPSPEC_RESUME_NEED_MARGIN | 0 | vllm/cpu_verify/cpu_verify_engine.py | |
| 6.4.19.11 | COMPSPEC_RESUME_NEED_TIMEOUT_S | 600 | vllm/cpu_verify/cpu_verify_engine.py | |
| 6.4.19.12 | CPU_OFFLOAD_POOL_BLOCKS | "" | vllm/cpu_verify/cpu_verify_engine.py 외 3 | |
| 6.4.19.13 | NUMA_FIRST_TOUCH | 0 | vllm/v1/kv_offload/worker/cpu_gpu.py 외 2 | |
| 6.4.19.14 | NUMA_FT_NODES | "" | compressspec/numa_first_touch.py 외 1 | |
| 6.4.19.15 | OFFLOAD_PREFIX_CACHE | 0 | vllm/cpu_verify/channels/naive_copy.py | restores a documented-broken 2x-pool behaviour for A/B; 0 setters |
| 6.4.19.16 | RESERVE_SKIPPED_SW_BLOCKS | 0 | vllm_cpu/v1/core/single_type_kv_cache_manager.py |
6.4.6.4 PREFILL — prefill
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.21.1 | HI_NTB | 32 | vllm/v1/attention/backends/headinfer_decode.py | |
| 6.4.21.2 | LAYER_SERIAL_BARRIER | stream | vllm/cpu_verify/cpu_verify_engine.py | |
| 6.4.21.3 | LAYER_SERIAL_CHUNKED | 0 | vllm/config/scheduler.py 외 2 | |
| 6.4.21.4 | LAYER_SERIAL_COVERAGE_BLOCKS | — | vllm/v1/core/kv_cache_utils.py | |
| 6.4.21.5 | LAYER_SERIAL_K | 0 | vllm/cpu_verify/channels/naive_copy.py 외 6 | |
| 6.4.21.6 | LAYER_SERIAL_TAIL_BLOCKS | 16 | vllm/cpu_verify/cpu_verify_engine.py 외 2 | |
| 6.4.21.7 | LS_CHUNKED_VERIFY | 0 | vllm/v1/attention/backends/flashinfer.py | |
| 6.4.21.8 | LS_CHUNK_TILE | 8192 | vllm/v1/worker/gpu_model_runner.py | |
| 6.4.21.9 | LS_PIPELINE_RELOAD | 1 | vllm/v1/attention/backends/flashinfer.py | |
| 6.4.21.10 | LS_RELOAD_MEMCPY | 1 | vllm/v1/attention/backends/flashinfer.py |
6.4.6.5 DRAFT — draft engine
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.23.1 | COMPRESSION_SPEC_MAX_TOTAL_CONTEXT | — | vllm/v1/core/sched/scheduler.py | |
| 6.4.23.2 | COMPSPEC_DECODE_ATTN_INTERVAL | — | vllm/v1/attention/backends/flashinfer.py | |
| 6.4.23.3 | COMPSPEC_DRAFT_STALL_S | 60 | vllm/cpu_verify/cpu_verify_engine.py | |
| 6.4.23.4 | COMPSPEC_RUNAHEAD | "" | vllm/cpu_verify/cpu_verify_engine.py | |
| 6.4.23.5 | DRAFT_DISPATCH_FULL | 0 | vllm/cpu_verify/channels/temp_buffer.py | fixed-window dispatch for parity runs; behaviour |
6.4.6.6 DELTA — delta transfer
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.25.1 | COMPACT_DIFF_UPLOAD | 1 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.25.2 | COMPACT_MAX_GPUBLK_UTIL | 0.9 | vllm/cpu_verify/compaction_upload/scheduler_recompact.py | |
| 6.4.25.3 | COMPACT_UPLOAD_PEND | 1 | verify/cpu_verify_server.py 외 3 | |
| 6.4.25.4 | DELTA_STRICT | 0 | vllm/cpu_verify/compaction_trace.py 외 4 |
6.4.6.7 ROUTER — mode 전환
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.27.1 | DYN_FORCE_OUT | 0 | vllm/cpu_verify/dyn_router.py | dev knob; runners pass $LC_DYN_FORCE_OUT |
| 6.4.27.2 | DYN_ROUTER | 0 | vllm/cpu_verify/dyn_router.py | |
| 6.4.27.3 | DYN_ROUTER_HEADROOM_PCT | 0.10 | vllm/cpu_verify/dyn_router.py | |
| 6.4.27.4 | DYN_ROUTER_HOLD_STEPS | 500 | vllm/cpu_verify/dyn_router.py |
6.4.6.8 HARNESS
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.29.1 | ARM | — | vllm/cpu_verify/channels/temp_buffer.py 외 3 |
6.4.6.9 ETC — 기타
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.31.1 | REUSE_ENGINE_RID | 0 | verify/cpu_verify_server.py | PR4 item-8 hypothesis toggle (comment :499); 0 setters |
6.4.6.10 미분류 — 09-30 원자료에 없던 변수
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.33.1 | COMPACT_BLOCK_BUDGET | — | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.33.2 | COMPACT_GATE_FALLBACK | compact | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.33.3 | COMPACT_UPLOAD_TIMEOUT_S | — | vllm/cpu_verify/_compaction_upload_dispatcher.py | |
| 6.4.33.4 | CS_UNPIN_HELPERS | 2 | vllm_cpu/v1/worker/cpu_worker.py | |
| 6.4.33.5 | RS_GUMBEL_SPARSE | 1 | verify/utils.py |
6.4.7 디버그 스위치 (34개, LOG_PRINT_* 흡수 후보)
- 출력만 늘리는 스위치는
LOG_PRINT_<DOMAIN>으로 흡수할 수 있다. 동작을 바꾸는 스위치(COMPRESS_SPEC_SYNC_VERIFY,FAKE_*)는 흡수하지 않고 디버그 전용으로 둔다
| 변수 | 기본값 | 읽는 곳 | 용도 | |
|---|---|---|---|---|
| 6.4.36.1 | ATTN_BP_DEBUG_FILL | "" | vllm/distributed/kv_transfer/kv_connector/v1/offloading_attn_bp_connector.py | TRAP: without .env the harness random-fills BP s |
| 6.4.36.2 | COMPACT_HOLD_DUMP | — | vllm_cpu/compaction/index_map.py | |
| 6.4.36.3 | COMPACT_SCORE_EXPORT_LEGACY | 0 | vllm_cpu/v1/attention/backends/cpu_attn.py | |
| 6.4.36.4 | COMPACT_SCORE_FORCE_OFF | 0 | vllm_cpu/v1/attention/backends/cpu_attn.py | |
| 6.4.36.5 | COMPRESS_SPEC_CYCLE_ANNOTATE | 0 | vllm/cpu_verify/cpu_verify_engine.py | writes hard-coded .realmode-run/cycle_map.jsonl; 'uncommitted' … |
| 6.4.36.6 | COMPRESS_SPEC_DEBUG | 0 | verify/utils.py 외 3 | the three == "1" readers fire ONLY |
| 6.4.36.7 | COMPRESS_SPEC_SYNC_VERIFY | 0 | vllm/v1/core/sched/scheduler.py | debug-only but behaviour-altering (serializes draft/verify); never a … |
| 6.4.36.8 | CPU_KV_HASH_DBG | 0 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.36.9 | CPU_PROFILE_CHUNK | 0 | verify/profile_cpu_forward.py | |
| 6.4.36.10 | CPU_PROFILE_CHUNK_ITERS | 12 | verify/profile_cpu_forward.py | |
| 6.4.36.11 | CPU_PROFILE_COMPACT_RATE | "" · 0 | verify/profile_cpu_forward.py | |
| 6.4.36.12 | CPU_PROFILE_CTX_TRUNC | 0 | verify/profile_cpu_forward.py | |
| 6.4.36.13 | CPU_PROFILE_MAX_TOKENS | 32 | verify/profile_cpu_forward.py | |
| 6.4.36.14 | CPU_PROFILE_PROMPT_LOGPROBS | — | verify/profile_cpu_forward.py | |
| 6.4.36.15 | CS_STOP_LOG | 0 | vllm/v1/core/sched/utils.py | per request per step when near a cap |
| 6.4.36.16 | DRAFT_DISPATCH_LOG | 0 | vllm/cpu_verify/channels/temp_buffer.py | |
| 6.4.36.17 | DUMMY_BATCH_DBG | 0 | vllm_cpu/v1/engine/core.py | |
| 6.4.36.18 | EXAMPLE_DIAG_QID | 1 | compressspec/cli.py | |
| 6.4.36.19 | FAKE_COMPACTION_VERIFY | 0.0 | vllm_cpu/v1/worker/gpu_model_runner.py | |
| 6.4.36.20 | FAKE_NEEDS_KV_RELOAD | 0 | vllm/cpu_verify/_fake_verify.py | gpu_only fake-verify toggle; 0 setters |
| 6.4.36.21 | LOGPROB_DUMP_DIR | — | verify/utils.py | audit s3.2 lists it under REMOVE; kept because a reader tool exists |
| 6.4.36.22 | LOGPROB_READ_LEGACY_ANCHOR | 0 | vllm/cpu_verify/cpu_verify_engine.py | legacy A/B path (dead_kind C) |
| 6.4.36.23 | LS_PEAK_PROBE | 0 | vllm/v1/core/sched/scheduler.py | one line per free event; no sync |
| 6.4.36.24 | PR4_8_DBG_EXTENDED | 0 | vllm/cpu_verify/channels/naive_copy.py | NOTE the [PR4-8-DBG] emitter at :321-335 is unconditional for the … |
| 6.4.36.25 | PR4_DISABLE_COMPRESS_CALL | 0 | vllm/v1/attention/backends/flashinfer.py | behaviour-altering probe; 0 setters |
| 6.4.36.26 | PR4_SW_GUARD_DEBUG | 0 | vllm/v1/attention/backends/flashinfer.py | |
| 6.4.36.27 | PRESERVE_LOG | 0 | vllm/cpu_verify/channels/temp_buffer.py 외 1 | one line per reload / per all-accept preserve |
| 6.4.36.28 | REJECT_DISTRIB_DUMP | 0 | verify/utils.py | today needs DEBUG_METADATA_DUMP_DIR too (:1333 ACCEPT_DUMP_DIR); one … |
| 6.4.36.29 | REJECT_DISTRIB_PT | 0 | verify/utils.py | |
| 6.4.36.30 | REJECT_DISTRIB_PT_MAX | 2000 | verify/utils.py | |
| 6.4.36.31 | REJECT_DISTRIB_SOURCE | server | verify/utils.py | |
| 6.4.36.32 | REJECT_DISTRIB_TOPK | 8 | verify/utils.py | |
| 6.4.36.33 | RULER_SEQ | — | verify/profile_cpu_forward.py | |
| 6.4.36.34 | RULER_TASK | niah_single_1 | verify/profile_cpu_forward.py |
6.4.8 옛 이름 (25개, 설정하면 경고 후 새 이름으로 동작)
| 옛 이름 | 새 이름 | |
|---|---|---|
| 6.4.38.1 | ATTN_BP_DUMP_SCORE_CHECK | LOG_PRINT_DUMP≥2 |
| 6.4.38.2 | ATTN_KV_DUMP_DIR | LOG_PRINT_DUMP≥2 + $DUMP_DIR/attn_kv |
| 6.4.38.3 | BREAKDOWN_DIR | $DUMP_DIR/breakdown |
| 6.4.38.4 | BREAKDOWN_KERNEL_PROFILE_MODE | LOG_PRINT_BREAKDOWN≥2 |
| 6.4.38.5 | COMPACTION_IDX_DUMP | LOG_PRINT_DUMP≥1 |
| 6.4.38.6 | COMPACT_DUMP_INDICES | LOG_PRINT_DUMP≥2 |
| 6.4.38.7 | COMPACT_DUMP_KV | LOG_PRINT_DUMP≥2 |
| 6.4.38.8 | COMPACT_GATE_THRESHOLD | COMPACT_COVERAGE |
| 6.4.38.9 | COMPACT_THRESHOLD | COMPACT_COVERAGE |
| 6.4.38.10 | COMPRESSION_SPEC_DEBUG | COMPRESS_SPEC_DEBUG |
| 6.4.38.11 | COMPRESS_SPEC_DUMP_DIR | $DUMP_DIR/cspec |
| 6.4.38.12 | CPU_VERIFY_DUMP_DIR | $DUMP_DIR/verify |
| 6.4.38.13 | DEBUG_METADATA_DUMP_DIR | LOG_PRINT_DUMP≥1 + $DUMP_DIR/metadata |
| 6.4.38.14 | DELTA_COMPACTION_LOG | LOG_PRINT_DELTA |
| 6.4.38.15 | DUMP_EXTEND_BEFORE_VERIFY | LOG_PRINT_DUMP≥3 |
| 6.4.38.16 | DUMP_FORWARD_OUT | LOG_PRINT_DUMP≥3 |
| 6.4.38.17 | DUMP_LAST_HIDDEN | LOG_PRINT_DUMP≥3 |
| 6.4.38.18 | DUMP_LOGITS_OUT | LOG_PRINT_DUMP≥3 |
| 6.4.38.19 | DUMP_SAMPLED_IDS | LOG_PRINT_DUMP≥3 |
| 6.4.38.20 | DUMP_TRACKER_DISPATCH | LOG_PRINT_DUMP≥3 |
| 6.4.38.21 | FSM_RUN_DIR | LOG_PRINT_DUMP≥1 + $DUMP_DIR/fsm |
| 6.4.38.22 | KV_DUMP_DIR | $DUMP_DIR/kv |
| 6.4.38.23 | OUT_ROOT | $DUMP_DIR/delta |
| 6.4.38.24 | SCORE_DUMP_DIR | LOG_PRINT_DUMP≥2 + $DUMP_DIR/score |
| 6.4.38.25 | VLLM_CPU_KVCACHE_SPACE | SHARED_CPU_POOL_GB (사용자 입력일 때만. launcher 는 내부적으로 계속 설정) |
6.4.9 퇴역 (26개, 설정하면 경고만 출력하고 무시)
| 대신 쓸 것 | 퇴역한 이름 | |
|---|---|---|
| 6.4.40.1 | LOG_PRINT_BREAKDOWN | BREAKDOWN_FLUSH_EVERY, BREAKDOWN_GPU_EVENT_DEPTH, BREAKDOWN_PER_REQ, BREAKDOWN_SKIP_WARMUP |
| 6.4.40.2 | LOG_PRINT_KV | ALLOC_NEW_COMPUTED_DBG, COMPSPEC_OFFLOAD_COVER, FREE_BLOCKS_DBG, INPUT_PROCESSOR_DBG, KV_DST_PTR_DBG, KV_TRANSFER_DBG, NAIVE_STORE_DBG, NUMA_VERIFY_DEBUG, RESERVE_DBG, SAVE_KV_LAYER_DBG, TEMPBUF_DBG |
| 6.4.40.3 | LOG_PRINT_VERIFY | COMPRESS_SPEC_TRACE, CPU_ATTN_BUILD_DBG, CPU_FWD_READ_HASH, DRAFT_TOKEN_LOG, FWD_TENSOR_STATS, LAST_VERIFY_LOG, LOGPROB_READ_DEBUG, PAYLOAD_BUILD_DBG, VERIFY_BATCH_LOG, VERIFY_DEBUG, VERIFY_DEBUG_PAYLOAD |
| 6.4.40.4 | 자동화 (/initialize · native 고정) | DIFF_NATIVE, DELTA_PUBLISH_FULL_KEEPMAP, COMPACT_INDEX_MAP_MAX |
6.4.10 정리 후보
| 항목 | 상태 | |
|---|---|---|
| 6.4.42.1 | 디버그 스위치 (6.4.7) 를 LOG_PRINT_* 로 흡수, COMPRESS_SPEC_DEBUG 포함 | 미처리 |
| 6.4.42.2 | EXP_SELECTED_TOKENS → COMPRESSION_SPEC_SELECTED_TOKENS 하나로 (vllm_cpu 와 harness 4개) | 보류 (사용자 결정) |
| 6.4.42.3 | COMPACT_COVERAGE 기본값 0.95 (launcher) vs 0.7 (엔진) | 결정 대기 |
| 6.4.42.4 | EXAMPLE_DIAG_QID 는 compressspec test example 전용, 사용자 경로 아님 | 유지 |
| 6.4.42.5 | 옛 이름 (6.4.8) 제거 | harness 가 새 이름으로 옮긴 뒤 |
- 결론 대표 브랜치는
feat/clean_code하나. dev 위에 얹혀 있고 PR #47(→ dev, OPEN)로 올라가 있다 - 받는 법
git clone -b feat/clean_code --recursive https://github.com/PSAL-POSTECH/TandemSpec.git
6.5.1 feat/clean_code 구성
| 저장소 | 커밋 | dev 대비 | 최근 커밋 | |
|---|---|---|---|---|
| 6.5.3.1 | TandemSpec (001) | 1b24c0c | +9 | 로그·환경변수 정리 1개 (1b24c0c), 공개 docs 정리 1개 (12f32ba) |
| 6.5.3.2 | vllm | dbe3a8e | +6 | 로그 정리 1개 (dbe3a8e): DUMP_DIR + LOG_PRINT_BREAKDOWN/DUMP |
| 6.5.3.3 | vllm_cpu | cf6fc24 | +6 | 로그·compaction 변수 정리 1개 (cf6fc24) |
- 10-06~07 정리 커밋은 레포마다 하나로 묶었다. 그 전 커밋(09-30
env_clean등)은 그대로 - 백업 브랜치
backup/clean_code-pre-squash-20261007(세 레포),backup/clean_code-pre-internal-removal(001) - 내부 전달용 파일(handoff, manifest,
documents/serve/,*_jh.py)은 history 에서 빼고.gitignore로 로컬에만 둠
6.5.2 검증
| 장비 | 판 | 결과 | 근거 | |
|---|---|---|---|---|
| 6.5.6.1 | g07 RTX 3090 + EPYC 75F3 (AVX2) | breakdown 2단계화 | A =2 / B =1 / C 옛 변수 / D 끔 모두 통과, CSV 중복 row 0 | g07 011_tandemspec_clean/results/20261007_g07_breakdown_level2/ |
| 6.5.6.2 | g07 RTX 3090 + EPYC 75F3 | DUMP_DIR 도입 | 6/6 통과, 새 방식·옛 방식 캡처와 debugger CSV 생성 | results/20261006_g07_dump_breakdown/ |
| 6.5.6.3 | g07 RTX 3090 + EPYC 75F3 | /initialize, native 고정 | 6/6 통과. native vs numpy 400/400 일치. continuous batching 24/24 요청, verify 629건 500 0건, LRU drop 0 | results/20261006_g07_native_initialize/ |
| 6.5.6.4 | g07 RTX 3090 + EPYC 75F3 | env_clean 병합 | 6/6 통과 | results/20261006_g07_env_clean/ |
| 6.5.6.5 | n75 RTX 4090 + Xeon 6426Y (AMX) | dev 엔진 | 미완료: CPU 엔진 빌드가 oneDNN 다운로드에서 정체해 중단 | ai-cluster results/20261006_rtx4090_clean_code/v4/ |
- 6/6 = SnapKV·StreamingLLM × offline·online·Ctrl-C 종료
6.5.3 10-06~07 고친 결함
| 결함 | 증상 | 수정 | |
|---|---|---|---|
| 6.5.9.1 | HF ID 의 vocab 을 바깥 env 의 transformers 로 읽음 | RS ROW MISMATCH, verify 전부 실패인데 종료 코드 0 | config.json 만 받아 직접 읽음 |
| 6.5.9.2 | dev vllm_cpu 가 score 버퍼 모양을 필수로 요구 | compressspec run 에서 verify 500 | launcher 가 SCORE_NUM_LAYERS·SCORE_NUM_Q_HEADS 채움 |
| 6.5.9.3 | cpu_verify_server.py 에 /initialize 없음 | 긴 context 에서 "Cannot get 32 free blocks" | /initialize 추가, index map 크기 = max(64, 4×max_num_seqs) |
| 6.5.9.4 | BREAKDOWN_PER_REQ 가 sched.jsonl 줄을 복사 | CSV 같은 row 5,034개 (request 구간 두 번 집계) | 기능 제거 |
| 6.5.9.5 | debugger 의 BREAKDOWN_KERNEL_INLINE 기본값 0 (엔진은 1) | kernel 계측을 켜도 CPU_FWD_* row 0 | 기본값 1, 기본 모드에서도 inline row 병합 |
6.5.4 남은 일
| 항목 | 상태 | |
|---|---|---|
| 6.5.11.1 | PR #47 리뷰·병합 | OPEN |
| 6.5.11.2 | 빈 step breakdown 기록 (전체 row 의 92.6%) | 묶을지 결정 대기 (ENGINE_IDLE 하나로 묶기 권장) |
| 6.5.11.3 | 디버그 변수 40개 LOG_PRINT_* 흡수, COMPRESS_SPEC_DEBUG 포함 | 미처리 |
| 6.5.11.4 | launcher 경로 batch별 CPU breakdown | cpu_verify_server.py 가 cpu_batch_size 를 안 돌려줌 (score 서버만 지원) |
| 6.5.11.5 | n75 (AMX) 검증 | FETCHCONTENT_SOURCE_DIR_ONEDNN 지정 후 재시도 필요 |
| 6.5.11.6 | 011 env build stamp | 예전 SHA. 이후 변경은 Python 뿐이라 COMPRESS_SPEC_SKIP_CHECK=1 로 시험 |
| 6.5.11.7 | 예제 기본값 ≠ 제품 설정 (router 꺼짐, τ 0.95) | 결정 대기 |
| 6.5.11.8 | 저장소 구조 (vllm/ 이중 폴더) | 정리 대상 |
| 6.5.11.9 | GQA 비율 수정 (커밋 b6ff4df77e) | 미병합 |
| 6.5.11.10 | docs 미반영 결과 (L40S envelope, AIME b16 1.59×) | 공개 여부 결정 대기 |
- 무엇 실제 문서 사이트. 6.1 의 36쪽 구성을 English·한국어로 모두 작성했다(2026-09-30)
- 주소 docs.jhbae.stream ↗ ↗ · 한국어판 ↗ ↗ (로그인 없음, 오른쪽 위에서 English/한국어 전환)
- 상태 검토용 초안. 모르는 사실은 페이지마다 "Open question" 으로 남겼다
- 소스
/home/shared/JH_MARVEL/tandemspec_docs(Docusaurus), 작성 지침.handoff/docs_site/WRITING_BRIEF.md
| 파트 | 페이지 | ID | |
|---|---|---|---|
| 6.99.3.1 | Overview | 한눈에 보기 · 요청 lifecycle · Recompression 과 delta transfer · Correctness 모델 · 용어 | O1–O5 |
| 6.99.3.2 | Reference hardware 에서 실행 | 준비물 · 빌드 · 첫 verify 요청 · baseline 저장 · 문제 해결 | R1–R5 |
| 6.99.3.3 | Hardware contract | 엔진 배치 · component map · contract 형식 · KV memory model · 통신과 동기화 | H1–H5 |
| 6.99.3.4 | Porting 가이드 | runtime · operator · draft attention · verify attention · KV layout · recompression · sampling 통계 · graph/batch | P1–P8 |
| 6.99.3.5 | 검증과 성능 | conformance · 수치 · lifecycle · 성능 측정 · 결과 해석 · 인수 보고서 | V1–V6 |
| 6.99.3.6 | Reference | CLI · 설정 · 환경변수 · verify API · tensor layout · 출력 · 호환성 | F1–F7 |
TCO 분석
- 문제 Marvell 미팅에서 TandemSpec의 TCO 절감 효과와 차세대 Structera 요구사항(matrix unit 등)을 보여 달라는 요청이 나왔다. 제안서에 없는 항목이라 방법론부터 정해야 한다.
- 현상 현재 결과는 속도 지표(TPOT, tokens/s)뿐이다. 비용 입력값, 다중 GPU vLLM 기준점, 긴 문맥 batch 처리량이 없다.
- 원인 TCO는 시스템 1시간 비용과 그 1시간에 만든 토큰 수를 함께 알아야 계산된다. 지금까지 측정은 두 번째 항목 일부만 다뤘다.
- 결과 지표는 SemiAnalysis(InferenceX) 방식의 tokens per dollar로 정했다. 실측 처리량(A)과 소유 기준 시간당 비용(B)만으로 구성 A·B를 비교한다. Structera simulator는 이 절의 범위 밖이다. 논문에는 Appendix로 넣는다.
tokens per dollar = A[시스템 처리량(tokens/s)] × 3600 ÷ B[시간당 비용($/h)][KV cache를 GPU에 다 담을 필요가 없다]
아래 두 측면에서 TCO를 분석한다.
- KV cache 부담이 작아 vanilla vLLM보다 큰 batch를 운용할 수 있다.
- GPU 1장에 들어가지 않는 long context를 TandemSpec은 같은 GPU로 운용할 수 있다.
| 구성 | 하드웨어 | 메모리 배치 | 처리량 출처 | |
|---|---|---|---|---|
| 7.0.6.1 | A. vLLM 다중 GPU | KV 용량만큼 GPU를 늘림(TP 2·4·8) | 전체 KV를 HBM에 | 실측 |
| 7.0.6.2 | B. TandemSpec + Xeon | GPU 1 + Xeon(AMX) + DDR5 | 압축 KV는 HBM, 전체 KV는 DDR5 | 실측 |
TCO는 장비를 사서 수명 동안 운영하는 비용 전체다. SemiAnalysis는 아래 항목을 더해 칩 1개 1시간당 비용($/chip-hour)으로 정규화한다.
| 구분 | 항목 | 설명 | |
|---|---|---|---|
| 7.2.2.1 | CapEx | 서버·네트워크 | GPU, CPU, DRAM, NIC, 스위치. 네트워크는 서버 단위로 배분한다 |
| 7.2.2.2 | CapEx | 감가상각·이자 | 서버 가격을 수명(보통 4~6년)으로 나눈다. SemiAnalysis 예시는 연 13% 부채 |
| 7.2.2.3 | OpEx | 전력 | 평균 전력 × PUE × 전기 요금. PUE는 일반 colocation 1.4 이상, 최신 GPU 시설 약 1.25 |
| 7.2.2.4 | OpEx | 상면(colocation)·유지보수 | kW당 월 임대료, 부품·인력 |
| 7.2.2.5 | 보정 | 가동률 | 가동률이 낮으면 시간당 비용이 오른다 |
시간당 비용($/h)   = (월 CapEx + 월 전력 + 월 상면 + 월 유지보수) ÷ 730 h ÷ 가동률
tokens per dollar = 시스템 처리량(tokens/s) × 3600 ÷ 시간당 비용($/h)
$ per 1M tokens = 1,000,000 ÷ tokens per dollar- 예시: HGX H100 서버(GPU 8개)는 월 CapEx $7,025 + 운영비 $1,871 → 약 $1.52/GPU-hour. CapEx가 약 79%다.
- 2026년 InferenceX의 H100 소유 비용은 hyperscaler 약 $1.17/hr, neocloud 약 $1.55/hr이다. 소유 비용과 임대가는 서로 다른 기준이라 섞지 않는다.
- 처리량과 비용은 시스템 전체 기준으로 센다. GPU 1개 기준이면 CPU·DRAM·CXL 비용이 빠진다.
- tokens/$는 batch에 따라 바뀐다. 이 절은 같은 batch(긴 문맥 1, 짧은 문맥 8·12·16)에서 시스템끼리 비교한다. InferenceX처럼 사용자당 tokens/s(interactivity)를 맞춘 비교는 하지 않았다.
| 용어 | 뜻 | 값의 근거 | |
|---|---|---|---|
| 7.6.1.1 | CapEx | 서버를 살 때 한 번 내는 구매비(GPU·CPU·DDR5·서버 본체). 5년 할부로 나눠 매달 낸다고 본다 | 부품별 판매가(표의 링크, 2026-10-21 표시가. DDR5는 2026년 가격 급등 전 시세(Counterpoint 2025년 4분기 $450/개)), 5년·연 13%는 SemiAnalysis 예시 |
| 7.6.1.2 | 월 전기료 | 서버와 냉방이 쓰는 전기 요금. 전력 × PUE 1.3 × 730 h × 요금 | PUE는 SemiAnalysis 예시, $0.0977/kWh는 EIA 미국 산업용 평균(2026년 7월) ↗ |
| 7.6.1.3 | 월 상면료 | 데이터센터에 서버를 두는 자리·냉방·전원 설비 임대료. 전기 요금과 별도로 kW당 매달 낸다 | $194.95/kW·월은 CBRE 북미 평균 임대료(2025) ↗ |
| 7.6.1.4 | 유지보수·가동률 | 7.2 식의 월 유지보수는 0, 가동률은 100%로 둔다 | 모든 시스템에 같은 값이라 비교에 영향이 없다(가정) |
| 7.6.1.5 | 시스템별 B | CPU로 verify·attention을 돌리는 TandemSpec·NEO는 TandemSpec 열, GPU만 쓰는 vLLM·SparseSpec·HeadInfer는 vLLM 열(TP=1, L40S는 TP=2) | 7.7의 B 열이 이 대응을 따른다 |
L40S 서버
| 단계 | 식 | TandemSpec (GPU 1장) | vLLM TP=1 (GPU 1장) | vLLM TP=2 (GPU 2장) | vLLM TP=4 (GPU 4장) | |
|---|---|---|---|---|---|---|
| 7.6.3.1 | 서버 구성 | 서버 1대에 GPU만 TP 수만큼 꽂는다 | L40S 1장 + Xeon Gold 6530 1소켓 + DDR5 256 GB | L40S 1장 + Xeon Gold 6530 1소켓 + DDR5 256 GB | L40S 2장 + Xeon Gold 6530 1소켓 + DDR5 256 GB | L40S 4장 + Xeon Gold 6530 1소켓 + DDR5 256 GB |
| 7.6.3.2 | ① CapEx | 항목별 구매비 합 | GPU: $13,879 ↗ × 1 = $13,879 CPU: $2,128 ↗ DDR5: $1,800 (64 GB × 4개, $450/개 ↗) 서버 본체: $9,527 ↗ 합계: $27,334 | GPU: $13,879 ↗ × 1 = $13,879 CPU: $2,128 ↗ DDR5: $1,800 (64 GB × 4개, $450/개 ↗) 서버 본체: $9,527 ↗ 합계: $27,334 | GPU: $13,879 ↗ × 2 = $27,758 CPU: $2,128 ↗ DDR5: $1,800 (64 GB × 4개, $450/개 ↗) 서버 본체: $9,527 ↗ 합계: $41,213 | GPU: $13,879 ↗ × 4 = $55,516 CPU: $2,128 ↗ DDR5: $1,800 (64 GB × 4개, $450/개 ↗) 서버 본체: $9,527 ↗ 합계: $68,971 |
| 7.6.3.3 | ② 월 CapEx | ① × 0.022753 | $621.90 | $621.90 | $937.70 | $1,569.30 |
| 7.6.3.4 | ③ 평균 전력 | 항목별 전력 합 | GPU: 350 W × 1 = 350 W CPU: 270 W DDR5: 40 W (10 W × 4개) 서버 본체: 100 W 합계: 760 W | GPU: 350 W × 1 = 350 W CPU: 81 W DDR5: 40 W (10 W × 4개) 서버 본체: 100 W 합계: 571 W | GPU: 350 W × 2 = 700 W CPU: 81 W DDR5: 40 W (10 W × 4개) 서버 본체: 100 W 합계: 921 W | GPU: 350 W × 4 = 1,400 W CPU: 81 W DDR5: 40 W (10 W × 4개) 서버 본체: 100 W 합계: 1,621 W |
| 7.6.3.5 | ④ 월 전기료 | ③ × 1.3 × 730 h × $0.0977/kWh | $70.50 | $52.90 | $85.40 | $150.30 |
| 7.6.3.6 | ⑤ 월 상면료 | ③ × $194.95/kW·월 | $148.20 | $111.30 | $179.50 | $316.00 |
| 7.6.3.7 | ⑥ B (시간당 비용) | (② + ④ + ⑤) ÷ 730 h | $1.151/h | $1.077/h | $1.647/h | $2.789/h |
RTX PRO 6000 서버
| 단계 | 식 | TandemSpec (GPU 1장) | vLLM TP=1 (GPU 1장) | vLLM TP=2 (GPU 2장) | vLLM TP=4 (GPU 4장) | |
|---|---|---|---|---|---|---|
| 7.6.5.1 | 서버 구성 | 서버 1대에 GPU만 TP 수만큼 꽂는다 | RTX PRO 6000 1장 + Xeon 6776P 1소켓 + DDR5 512 GB | RTX PRO 6000 1장 + Xeon 6776P 1소켓 + DDR5 512 GB | RTX PRO 6000 2장 + Xeon 6776P 1소켓 + DDR5 512 GB | RTX PRO 6000 4장 + Xeon 6776P 1소켓 + DDR5 512 GB |
| 7.6.5.2 | ① CapEx | 항목별 구매비 합 | GPU: $17,850 ↗ × 1 = $17,850 CPU: $7,764 ↗ DDR5: $3,600 (64 GB × 8개, $450/개 ↗) 서버 본체: $9,527 ↗ 합계: $38,741 | GPU: $17,850 ↗ × 1 = $17,850 CPU: $7,764 ↗ DDR5: $3,600 (64 GB × 8개, $450/개 ↗) 서버 본체: $9,527 ↗ 합계: $38,741 | GPU: $17,850 ↗ × 2 = $35,700 CPU: $7,764 ↗ DDR5: $3,600 (64 GB × 8개, $450/개 ↗) 서버 본체: $9,527 ↗ 합계: $56,591 | GPU: $17,850 ↗ × 4 = $71,400 CPU: $7,764 ↗ DDR5: $3,600 (64 GB × 8개, $450/개 ↗) 서버 본체: $9,527 ↗ 합계: $92,291 |
| 7.6.5.3 | ② 월 CapEx | ① × 0.022753 | $881.50 | $881.50 | $1,287.60 | $2,099.90 |
| 7.6.5.4 | ③ 평균 전력 | 항목별 전력 합 | GPU: 600 W × 1 = 600 W CPU: 350 W DDR5: 80 W (10 W × 8개) 서버 본체: 100 W 합계: 1,130 W | GPU: 600 W × 1 = 600 W CPU: 105 W DDR5: 80 W (10 W × 8개) 서버 본체: 100 W 합계: 885 W | GPU: 600 W × 2 = 1,200 W CPU: 105 W DDR5: 80 W (10 W × 8개) 서버 본체: 100 W 합계: 1,485 W | GPU: 600 W × 4 = 2,400 W CPU: 105 W DDR5: 80 W (10 W × 8개) 서버 본체: 100 W 합계: 2,685 W |
| 7.6.5.5 | ④ 월 전기료 | ③ × 1.3 × 730 h × $0.0977/kWh | $104.80 | $82.10 | $137.70 | $248.90 |
| 7.6.5.6 | ⑤ 월 상면료 | ③ × $194.95/kW·월 | $220.30 | $172.50 | $289.50 | $523.40 |
| 7.6.5.7 | ⑥ B (시간당 비용) | (② + ④ + ⑤) ÷ 730 h | $1.653/h | $1.556/h | $2.349/h | $3.935/h |
평균 전력과 계수
| 항목 | 값 | 근거 | |
|---|---|---|---|
| 7.6.7.1 | GPU 전력 | TDP. L40S 350 W, RTX PRO 6000 600 W | 사양 |
| 7.6.7.2 | CPU 전력 (TandemSpec) | TDP. Xeon Gold 6530 270 W, Xeon 6776P 350 W | CPU로 verify를 돌리므로 최대 전력으로 잡는다(보수적) |
| 7.6.7.3 | CPU 전력 (vLLM) | TDP의 30%. 81 W, 105 W | 같은 5세대 Xeon(Xeon Platinum 8558U, TDP 300 W)의 idle package 전력 실측 67 W = TDP의 22% (ServeTheHome ↗). vLLM은 scheduler·tokenizer용 core 몇 개를 계속 돌리므로 idle보다 약간 높은 30%로 잡았다. n82 RAPL은 권한이 없어 읽지 못했다 |
| 7.6.7.4 | DDR5 전력 | 64 GB DIMM 1개당 10 W × DIMM 수 (L40S 4개, RTX PRO 6000 8개) | 64 GB급 RDIMM의 전원 칩(PMIC5010) 평균 전력 상한이 15.3 W다 (Micron DDR5 RDIMM 사양 ↗). 제조사가 모듈 실사용 전력을 공개하지 않아 상한의 약 2/3로 잡았다(가정). 4~8개라 B에 주는 영향은 $0.01/h 수준이다 |
| 7.6.7.5 | 서버 본체 전력 | 100 W (팬·보드·NIC·부팅 SSD) | NIC 11 W(ConnectX-6 Dx typical, NVIDIA ↗) + NVMe SSD 13.5 W(PM9A3 write 최대, Samsung ↗) = 약 25 W는 사양 근거. 나머지 약 75 W(팬·보드·BMC)는 출처를 찾지 못한 가정이다 |
| 7.6.7.6 | 0.022753 | 5년(60개월) 감가상각 + 연 13% 이자의 월 상환 계수 | 이자율: SemiAnalysis 예시 ↗ |
| 7.6.7.7 | 1.3 · $0.0977/kWh · $194.95/kW·월 | PUE · 전기 요금 · 상면료 | PUE: SemiAnalysis 예시 ↗, 전기 요금: EIA ↗, 상면료: CBRE ↗ |
GPU별 최대 context (vLLM, batch 1)
| L40S (48 GB GDDR6, 864 GB/s, 350 W) | TP=1 | TP=2 | TP=4 | TP=8 | |
|---|---|---|---|---|---|
| 7.7.2.1 | Qwen3-4B-Thinking | 225K (실측) | 515K (실측) | 1,076K | 2,209K |
| RTX PRO 6000 (96 GB GDDR7, 1,792 GB/s, 600 W) | TP=1 | TP=2 | TP=4 | TP=8 | |
|---|---|---|---|---|---|
| 7.7.3.1 | Qwen3-30B-A3B | 292K (실측) | 1,206K | 3,034K | 3,345K |
| 7.7.3.2 | Granite-4.2-30B | 112K (실측) | 446K | 1,116K | 2,456K |
- 산출: (GPU 메모리 × 0.9 − 가중치 ÷ TP) × TP ÷ 토큰당 KV. 토큰당 KV: Qwen3-4B 144 KiB, Qwen3-30B-A3B 96 KiB, Granite 256 KiB (layer × KV head × 128 × K·V × bf16).
- Qwen3-30B-A3B TP=8이 TP=4와 비슷한 이유: KV head가 4개라 TP=8에서는 같은 KV head를 GPU 2장이 중복 저장한다. 가중치 몫만 줄어든다.
계산식
E2E (s)          = TTFT + N_ref × TPOT        N_ref = TandemSpec이 그 요청에서 생성한 출력 토큰 수
A (tok/s)        = N_ref ÷ E2E                batch 1 처리량
B ($/h)          = 7.6 표의 ⑥
$/1M tokens = B ÷ (A × 3600) × 10^6L40S · Qwen3-4B-Thinking · Ultra(323K~451K) · batch 1
| prompt 토큰 | 시스템 | N_ref | E2E (s) | A (tok/s) | B ($/h) | $/1M tokens | |
|---|---|---|---|---|---|---|---|
| 7.7.8.1 | 322,627 | TandemSpec | 2,391 | 479.9 | 4.98 | 1.151 | $64.2 |
| 7.7.8.2 | 322,627 | vLLM TP=2 | 2,391 | 181.1 | 13.20 | 1.647 | $34.7 |
| 7.7.8.3 | 371,465 | TandemSpec | 2,194 | 525.4 | 4.18 | 1.151 | $76.5 |
| 7.7.8.4 | 371,465 | vLLM TP=2 | 2,194 | 210.7 | 10.41 | 1.647 | $43.9 |
| 7.7.8.5 | 400,301 (†) | TandemSpec | 83,230 | 11,325.3 | 7.35 | 1.151 | $43.5 |
| 7.7.8.6 | 400,301 (†) | vLLM TP=2 | 83,230 | 4,418.3 | 18.84 | 1.647 | $24.3 |
| 7.7.8.7 | 450,826 | TandemSpec | 694 | 472.1 | 1.47 | 1.151 | $217.5 |
| 7.7.8.8 | 450,826 | vLLM TP=2 | 694 | 199.3 | 3.48 | 1.647 | $131.5 |
(†) 두 시스템 모두 생성 상한까지 반복 생성(prompt 자체가 반복 코드). 출력 길이가 길어 $/1M이 낮게 나온다.
RTX PRO 6000 · 긴 문맥 (LongBench-v2 Long·Ultra 구간) · batch 1
| 모델 · prompt 길이 | 시스템 | N_ref | E2E (s) | A (tok/s) | B ($/h) | $/1M tokens | |
|---|---|---|---|---|---|---|---|
| 7.7.12.1 | Qwen3-30B-A3B Long 170K ~ 194K | TandemSpec | 3,950 | 150.1 | 26.32 | 1.653 | $17.4 |
| 7.7.12.2 | Qwen3-30B-A3B Long 170K ~ 194K | vLLM | 3,950 | 149.4 | 26.44 | 1.556 | $16.3 |
| 7.7.12.3 | Qwen3-30B-A3B Long 170K ~ 194K | SparseSpec | 3,950 | 167.2 | 23.62 | 1.556 | $18.3 |
| 7.7.12.4 | Qwen3-30B-A3B Long 170K ~ 194K | NEO | 3,950 | 935.8 | 4.22 | 1.653 | $108.8 |
| 7.7.12.5 | Qwen3-30B-A3B Long 170K ~ 194K | HeadInfer | 3,950 | 3,229.8 | 1.22 | 1.556 | $354.3 |
| 7.7.12.6 | Qwen3-30B-A3B Ultra 425K ~ 442K | TandemSpec | 3,763 | 942.6 | 3.99 | 1.653 | $115.1 |
| 7.7.12.7 | Qwen3-30B-A3B Ultra 425K ~ 442K | vLLM | 3,763 | OOM | — | — | — |
| 7.7.12.8 | Qwen3-30B-A3B Ultra 425K ~ 442K | SparseSpec | 3,763 | OOM | — | — | — |
| 7.7.12.9 | Qwen3-30B-A3B Ultra 425K ~ 442K | NEO | 3,763 | 2,910.3 | 1.29 | 1.653 | $355.9 |
| 7.7.12.10 | Qwen3-30B-A3B Ultra 425K ~ 442K | HeadInfer | 3,763 | 10,395.0 | 0.36 | 1.556 | $1,200.6 |
| 7.7.12.11 | Granite-4.2-30B Long 46K ~ 55K | TandemSpec | 2,914 | 184.6 | 15.79 | 1.653 | $29.1 |
| 7.7.12.12 | Granite-4.2-30B Long 46K ~ 55K | vLLM | 2,914 | 184.6 | 15.79 | 1.556 | $27.4 |
| 7.7.12.13 | Granite-4.2-30B Long 46K ~ 55K | SparseSpec | 2,914 | 199.8 | 14.59 | 1.556 | $29.6 |
| 7.7.12.14 | Granite-4.2-30B Long 46K ~ 55K | NEO | 2,914 | 501.7 | 5.81 | 1.653 | $79.0 |
| 7.7.12.15 | Granite-4.2-30B Long 46K ~ 55K | HeadInfer | 2,914 | 1,692.2 | 1.72 | 1.556 | $251.3 |
| 7.7.12.16 | Granite-4.2-30B Ultra 488K ~ 504K | TandemSpec | 8,190 | 2,696.7 | 3.04 | 1.653 | $151.0 |
| 7.7.12.17 | Granite-4.2-30B Ultra 488K ~ 504K | vLLM | 8,190 | OOM | — | — | — |
| 7.7.12.18 | Granite-4.2-30B Ultra 488K ~ 504K | SparseSpec | 8,190 | OOM | — | — | — |
| 7.7.12.19 | Granite-4.2-30B Ultra 488K ~ 504K | NEO | 8,190 | 5,193.4 | 1.58 | 1.653 | $290.6 |
| 7.7.12.20 | Granite-4.2-30B Ultra 488K ~ 504K | HeadInfer | 8,190 | 24,017.6 | 0.34 | 1.556 | $1,271.2 |
RTX PRO 6000 · 짧은 문맥(Short) · concurrency 8, 16 (AIME25, Qwen3-30B-A3B-Thinking-2507)
| concurrency | 시스템 | A (tok/s) | B ($/h) | $/1M tokens | |
|---|---|---|---|---|---|
| 7.7.15.1 | 8 | TandemSpec | 306.9 | 1.653 | $1.50 |
| 7.7.15.2 | 8 | vLLM | 309.6 | 1.556 | $1.40 |
| 7.7.15.3 | 16 | TandemSpec | 415.3 | 1.653 | $1.11 |
| 7.7.15.4 | 16 | vLLM | 409.3 | 1.556 | $1.06 |
- A = 출력 토큰 합 ÷ 전체 wall(요청 48·96개, 논문 §4.2.2와 같은 concurrency 8·16).
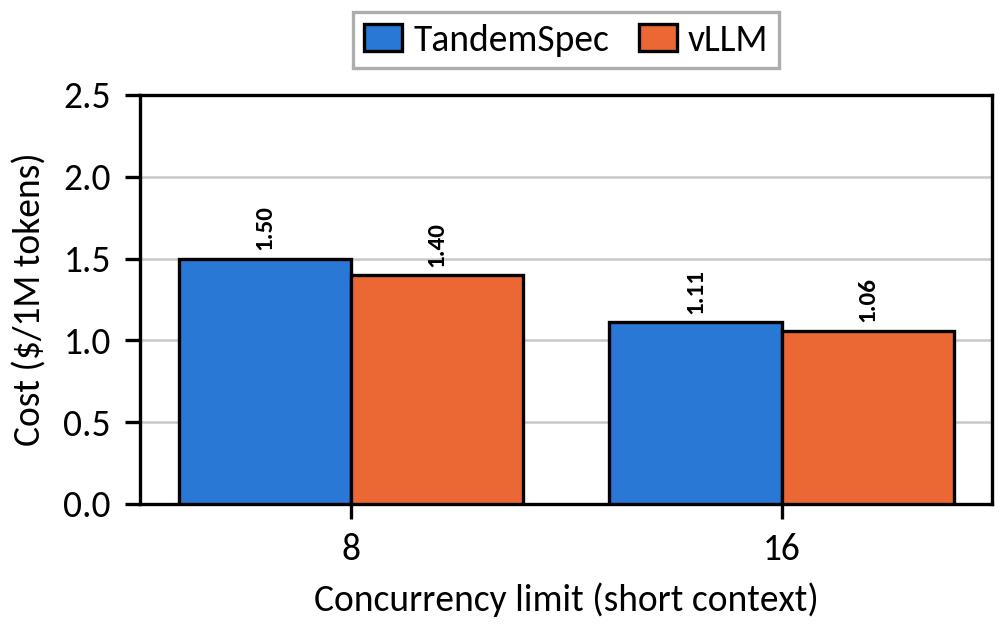
| 항목 | 내용 | |
|---|---|---|
| 7.8.1.1 | 파일 | [TandemSpec_TCO_Appendix.pdf 내려받기](TandemSpec_TCO_Appendix.pdf?v=eb683d12) (4쪽, 2단, 2026-10-22 빌드) |
| 7.8.1.2 | 형식 | 논문 appendix와 같은 acmart 2단, 약어 표는 식 앞, 표 캡션은 표 아래, References는 ACM 형식, 영문 |
| 7.8.1.3 | 원본 | ai-cluster figure/tex/appendix/tco/ (appendix_tco.tex, preview.tex, 표는 make_tables.py가 data/*.csv에서 생성) |